RAG là gì: retrieval-augmented generation và cách hoạt động
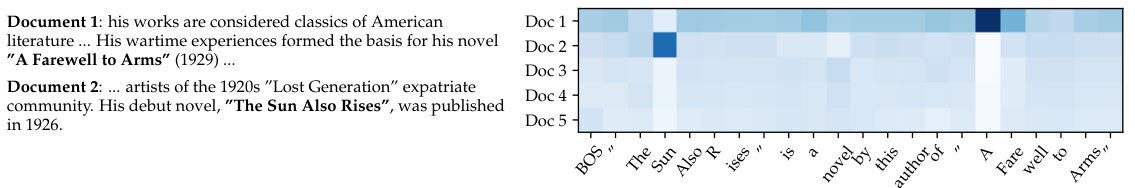
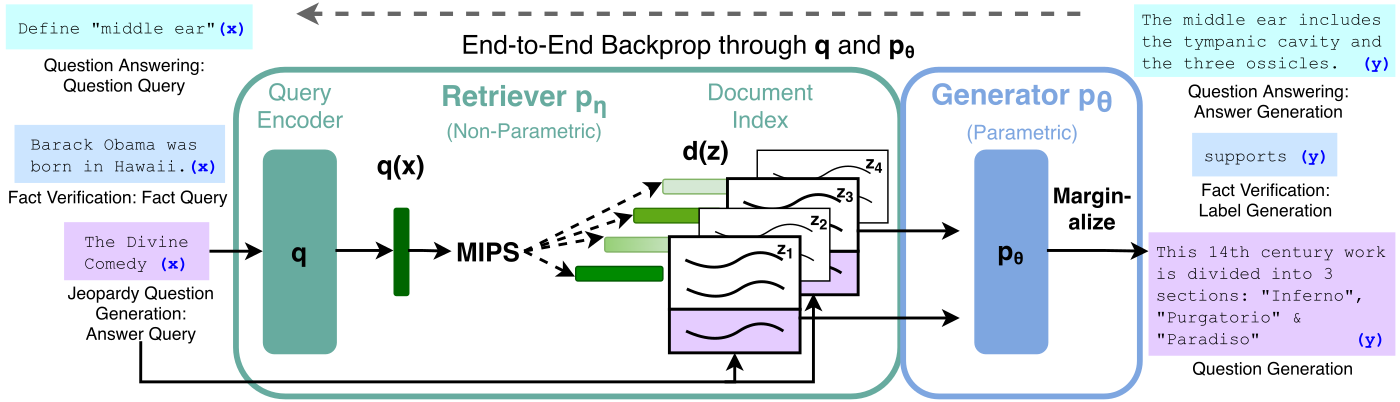
Retrieval-augmented generation (RAG) là một kỹ thuật tiên tiến trong lĩnh vực AI giúp mô hình ngôn ngữ lớn (LLM) truy cập và sử dụng thông tin từ nguồn dữ liệu bên ngoài khi tạo câu trả lời, giảm thiểu hiện tượng ảo giác và cho phép cập nhật tri thức mà không cần huấn luyện lại mô hình. Kỹ thuật này kết hợp bộ nhớ tham số (mô hình seq2seq đã huấn luyện trước) với bộ nhớ không tham số (dense vector index) dựa trên cơ chế truy xuất neural, như đề xuất lần đầu trong bài báo Lewis et al. (NeurIPS 2020).
Cơ chế hoạt động của RAG
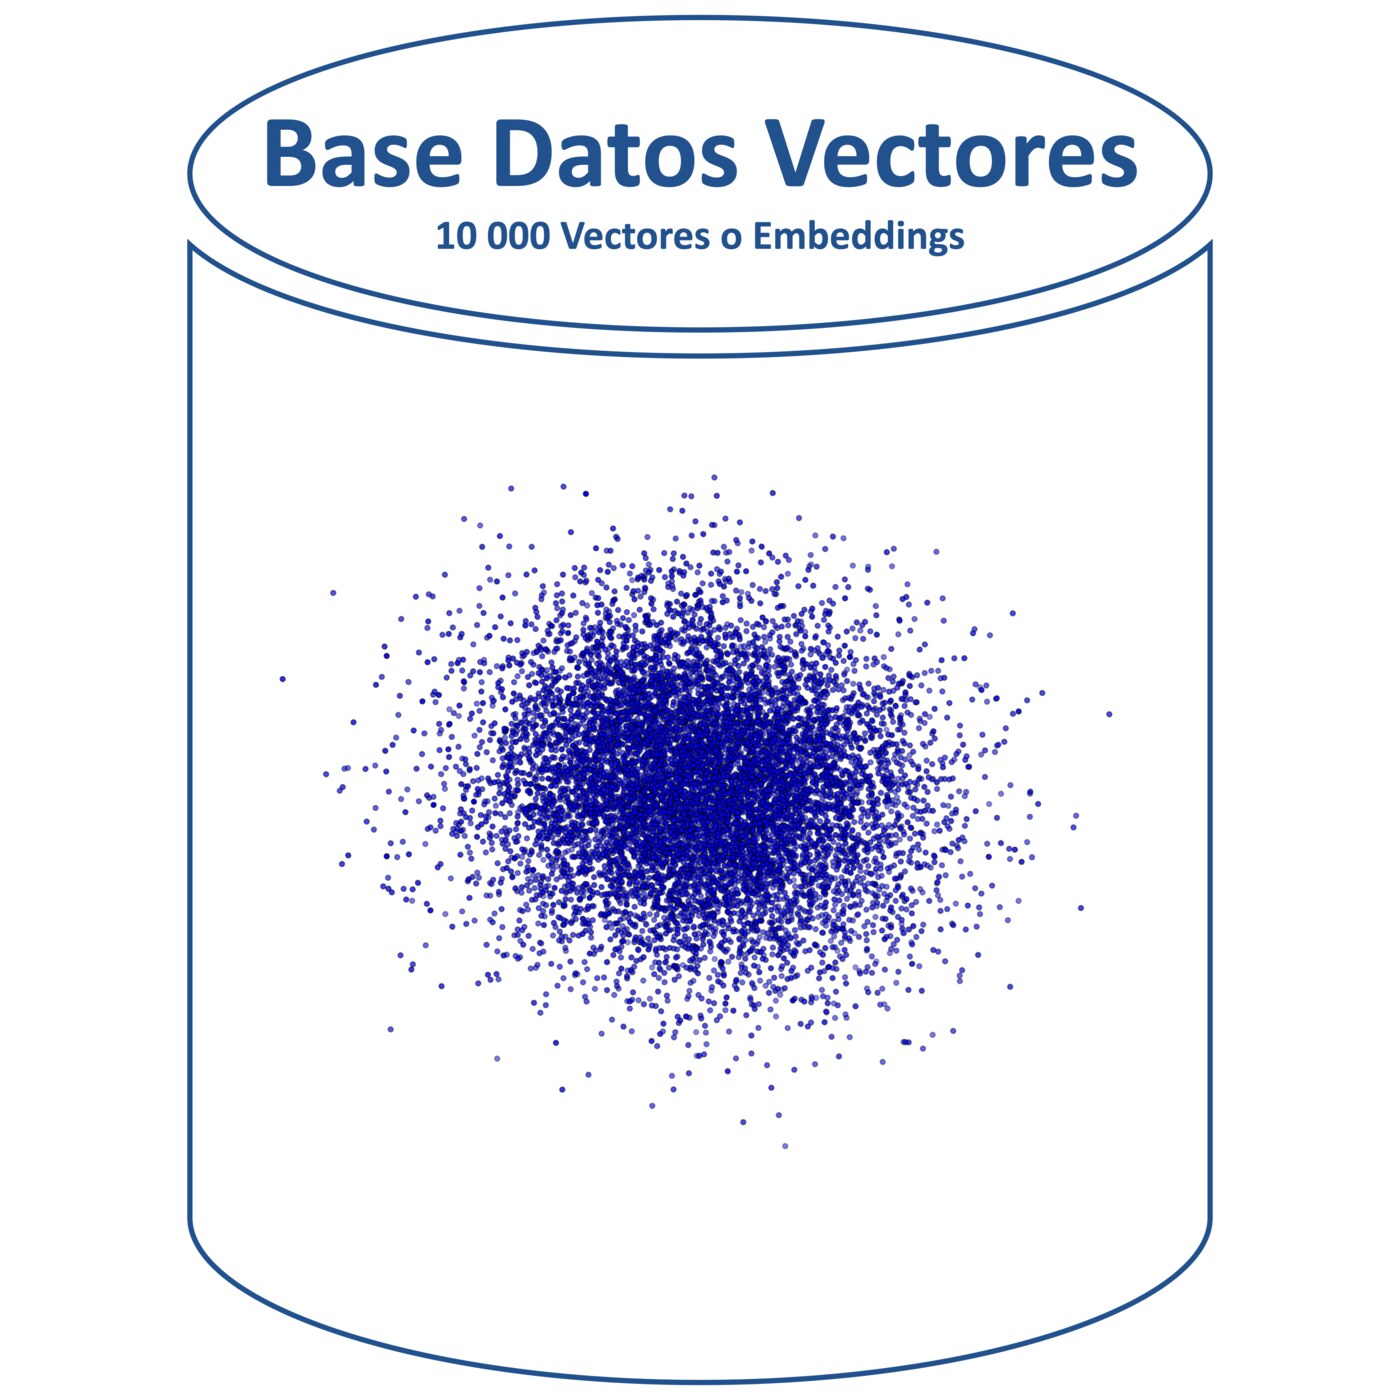
RAG hoạt động qua pipeline gồm các bước chính: trước tiên, tài liệu nguồn được chia thành các đoạn nhỏ (chunks) và chuyển đổi thành vector embedding bằng mô hình embedding; các vector này được lưu vào một vector database để truy xuất nhanh. Khi người dùng gửi một câu hỏi (query), theo tài liệu AWS Prescriptive Guidance, hệ thống chuyển câu hỏi thành vector embedding và tìm kiếm các chunk có độ tương đồng cao nhất, thường là top-k kết quả. Các chunk này được chèn vào prompt như ngữ cảnh bổ sung, sau đó LLM sinh ra câu trả lời cuối cùng dựa trên cả câu hỏi và ngữ cảnh đã truy xuất.
Các thành phần chính của hệ thống RAG
Hệ thống RAG tiêu chuẩn bao gồm các thành phần sau:
- Nạp dữ liệu (data loading): tải tài liệu từ nhiều nguồn như file PDF, trang web, cơ sở dữ liệu, API hoặc dịch vụ đám mây.
- Chia nhỏ văn bản (text splitting): chia tài liệu thành các đoạn phù hợp với kích thước ngữ cảnh của LLM, thường từ 100 đến 500 từ.
- Mô hình embedding: mô hình chuyển văn bản thành vector số, ví dụ Sentence-BERT hoặc bộ embedding đi kèm của nhà cung cấp LLM.
- Vector database: cơ sở dữ liệu chuyên dụng lưu và tìm kiếm vector, ví dụ FAISS, Chroma, Milvus hoặc dịch vụ đám mây như Pinecone.
- Bộ truy xuất (retriever): thực hiện tìm kiếm hàng xóm gần nhất để lấy các chunk liên quan nhất với câu hỏi.
- Bộ tổng hợp câu trả lời (response synthesizer): kết hợp câu hỏi và các chunk đã truy xuất để tạo prompt đầu vào cho LLM.
- Mô hình nền tảng (LLM): mô hình ngôn ngữ lớn đã huấn luyện trước như LLaMA hay Mistral.
Hai framework phổ biến nhất để xây dựng RAG là LangChain và LlamaIndex, cả hai đều dùng giấy phép MIT và viết bằng Python. Tài liệu của LlamaIndex mô tả RAG qua năm giai đoạn: nạp, lập chỉ mục, lưu trữ, truy vấn và đánh giá. Trong khi đó, tài liệu của LangChain phân biệt ba kiến trúc: RAG hai bước (luôn truy xuất trước khi sinh, độ trễ thấp và dễ đoán), RAG dạng agent (mô hình tự quyết định khi nào cần truy xuất) và RAG lai (kết hợp cả hai).
So sánh RAG với fine-tuning và prompt engineering
| Tiêu chí | RAG | Fine-tuning | Prompt engineering |
|---|---|---|---|
| Thời gian cập nhật tri thức | Vài phút (nạp lại chỉ mục) | Vài giờ đến vài ngày | Không áp dụng |
| Cần chuyên gia dữ liệu | Không | Có | Không |
| Trích dẫn nguồn | Có | Không | Không |
| Nguy cơ ảo giác | Giảm đáng kể | Vẫn có thể xảy ra | Vẫn có thể xảy ra |
| Chi phí tính toán | Thấp | Cao | Thấp |
Kết quả đo được trong bài báo gốc
Bài báo gốc báo cáo mô hình RAG đạt điểm Exact Match lần lượt là 44,5 trên Natural Questions, 68,0 trên TriviaQA, 45,2 trên WebQuestions và 52,2 trên CuratedTREC, đồng thời vượt mô hình seq2seq thuần tham số. Trên tập MS-MARCO, RAG đạt ROUGE-L 40,8 so với 38,2 của BART. Các tác giả cũng chỉ ra hai điểm then chốt: mô hình RAG ảo giác ít hơn, và việc thay đổi chỉ mục tri thức (ví dụ từ dữ liệu năm 2016 sang 2018) làm đầu ra thay đổi theo, điều mà mô hình thuần tham số không làm được nếu không huấn luyện lại.
Các chỉ số đánh giá hiệu suất RAG
Để đo lường chất lượng của hệ thống RAG, cần xem xét cả hai khía cạnh: chất lượng truy xuất và chất lượng sinh ra. Theo hướng dẫn đánh giá RAG, các chỉ số phổ biến gồm:
- Recall@k: tỷ lệ tài liệu liên quan thực sự nằm trong top-k kết quả truy xuất, quan trọng khi bỏ sót tài liệu gây tổn thất lớn.
- Precision@k: tỷ lệ kết quả trong top-k thực sự liên quan đến câu hỏi.
- F1@k: điểm cân bằng giữa độ chính xác và độ bao phủ.
- MRR: nghịch đảo vị trí trung bình của kết quả liên quan đầu tiên; giá trị 1 nghĩa là kết quả luôn nằm ở vị trí cao nhất.
- NDCG@k: chỉ số có tính thứ tự, phạt nặng kết quả bị đẩy xuống thấp.
- Độ trung thành (faithfulness): mức độ câu trả lời bám sát ngữ cảnh đã truy xuất, không thêm thông tin ngoài dữ liệu.
- Tuân thủ ngữ cảnh (context adherence): phần trăm câu trả lời chỉ dựa trên các chunk được truy xuất.
Ứng dụng thực tế của RAG
RAG được áp dụng rộng rãi trong nhiều ngành nhờ khả năng kết hợp tri thức chuyên ngành với sức mạnh của LLM. Theo các use case được AWS tổng hợp, các ứng dụng tiêu biểu gồm:
- Tìm kiếm thông tin nội bộ: tạo đoạn trích nổi bật chính xác và cập nhật liên tục khi có tài liệu mới.
- Trợ lý hỏi đáp: truy xuất đoạn tài liệu chứa câu trả lời rồi sinh câu trả lời ngắn gọn.
- Bán lẻ và thương mại điện tử: gợi ý sản phẩm cá nhân hóa theo sở thích kèm thông số chi tiết.
- Sản xuất và vận hành: tra cứu quy trình, hướng dẫn xử lý sự cố và quy chuẩn cập nhật.
- Y tế và pháp lý: bổ sung tri thức chính xác, kịp thời cho bác sĩ và điều tra viên, trong khi con người vẫn ra quyết định cuối cùng.
Theo tài liệu Microsoft Azure, các thách thức thực tế gồm hiểu đúng câu hỏi (kết hợp tìm kiếm từ khoá và vector), truy cập nhiều nguồn dữ liệu, giới hạn số token, thời gian đáp và bảo mật quyền truy cập. Xu hướng phát triển tiếp theo là RAG dạng agent, nơi mô hình tách câu hỏi thành nhiều câu nhỏ, chạy song song và trả lời kèm trích dẫn nguồn.
Nhờ thiết kế mô-đun, RAG cho phép thay thế linh hoạt mô hình embedding hay vector database mà không phải viết lại toàn bộ hệ thống. AWS khuyến nghị bắt đầu bằng RAG cho bài toán hỏi đáp trên tài liệu riêng, dùng fine-tuning cho tác vụ bổ sung như tóm tắt, và kết hợp cả hai khi cần.
Nguồn tham khảo: bài báo gốc Lewis et al. (NeurIPS 2020), tài liệu LlamaIndex, LangChain, Microsoft Azure và AWS Prescriptive Guidance.