K-means là gì: thuật toán phân cụm dữ liệu và cách chọn số cụm
K-means là gì? Đây là thuật toán phân cụm (clustering) được dùng để tự động chia một tập dữ liệu không nhãn thành k cụm, sao cho các điểm trong cùng một cụm gần nhau nhất và giữa các cụm thì xa nhau. Thuật toán này là nền tảng của rất nhiều ứng dụng thực tế: phân khúc khách hàng theo hành vi mua sắm, gom nhóm người dùng theo khu vực địa lý, nén ảnh bằng vector màu, hay tiền xử lý dữ liệu trước khi huấn luyện mô hình khác.
Bài viết này giải thích cơ chế toán học của K-means, lịch sử ra đời, các bước thuật toán, độ phức tạp tính toán, và hai cách chọn số cụm phổ biến nhất là phương pháp khuỷu tay (elbow) và hệ số silhouette.
K-means hoạt động như thế nào
Toán bài toán được phát biểu như sau: cho tập dữ liệu gồm n điểm, mỗi điểm có d đặc trưng, hãy tìm tập k vector trọng tâm (centroid) sao cho tổng bình phương khoảng cách từ mỗi điểm tới trọng tâm gần nhất là nhỏ nhất. Hàm mục tiêu này thường gọi là WCSS (within-cluster sum-of-squares), hay trong tài liệu scikit-learn là inertia.
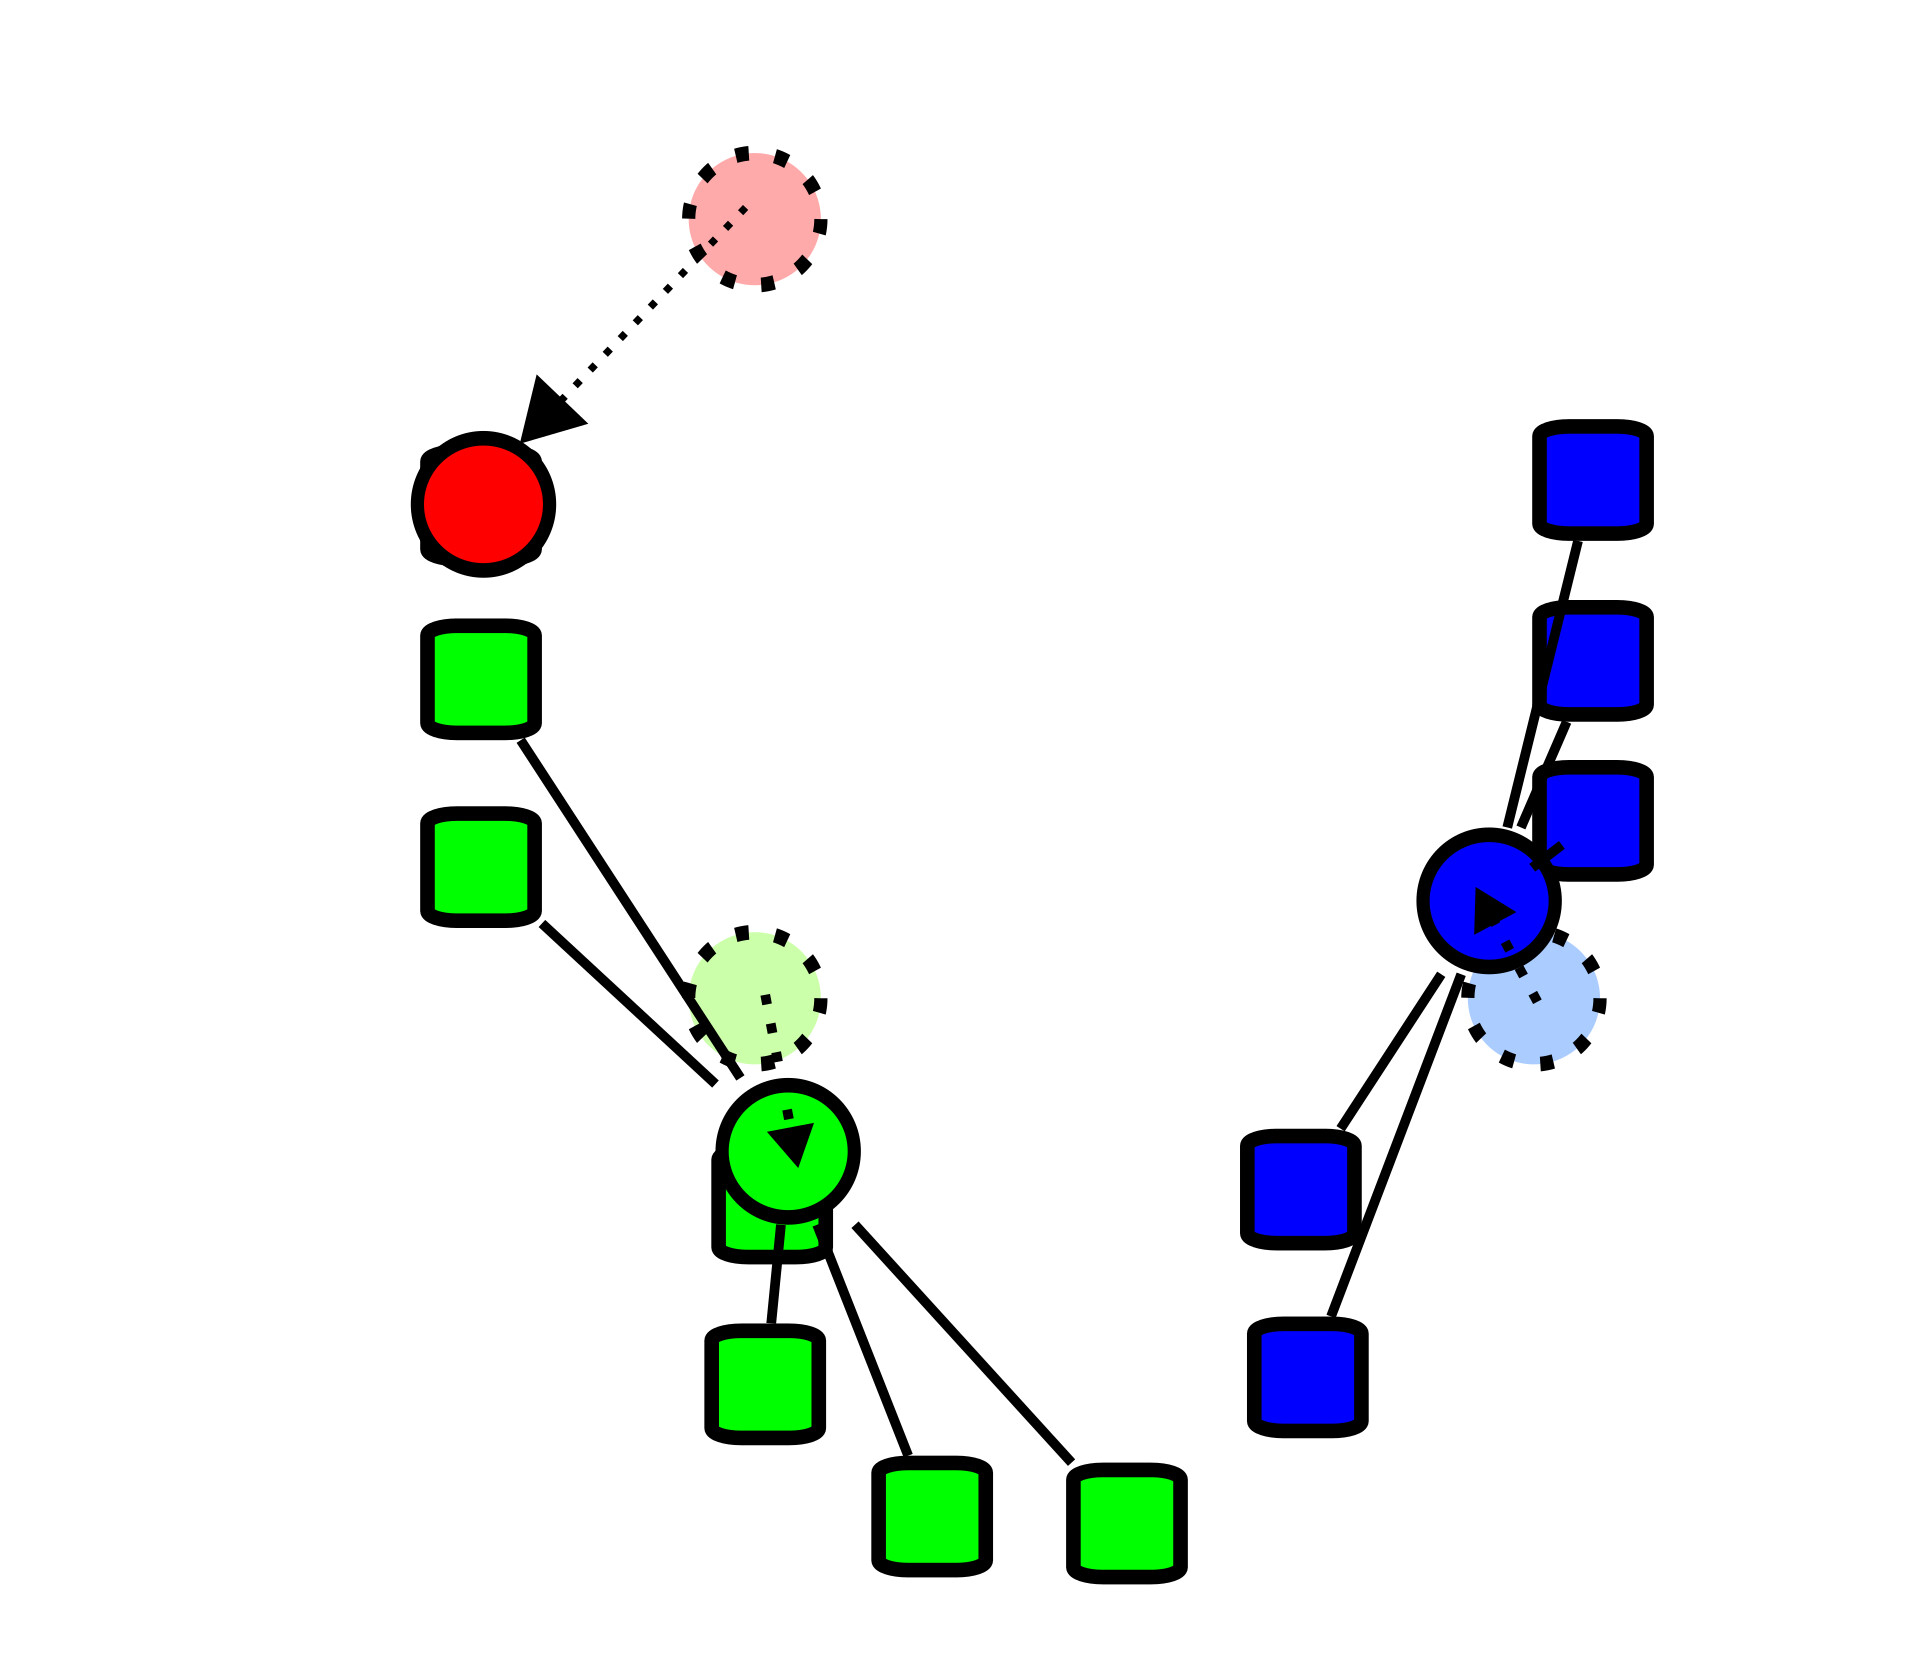
Chu trình thuật toán gồm hai bước lặp đi lặp lại cho tới khi hội tụ:
- Bước gán (assignment): với mỗi centroid hiện có, gán mọi điểm dữ liệu vào centroid gần nó nhất.
- Bước cập nhật (update): tính lại vị trí mới cho từng centroid là trung bình của toàn bộ các điểm vừa được gán cho nó.
Hai bước này lặp cho đến khi phép gán không còn thay đổi, tức hàm WCSS không giảm nữa. Theo tài liệu K-means clustering, mỗi vòng lặp làm WCSS giảm đơn điệu không âm, nên thuật toán luôn hội tụ — nhưng hội tụ không đồng nghĩa với đạt tối ưu toàn cục. Đây chính là điểm yếu cốt lõi của K-means.
Chọn trọng tâm khởi tạo ảnh hưởng tới kết quả
Nếu khởi tạo centroid bằng số ngẫu nhiên, thuật toán có thể rơi vào một cục bộ tối ưu tệ: ví dụ chạy lại nhiều lần trên cùng dữ liệu mà các cụm tìm được hoàn toàn khác nhau. Vì vậy các thư viện hiện đại dùng k-means++ làm mặc định. Cách này chọn trọng tâm đầu tiên ngẫu nhiên hoàn toàn, sau đó mỗi trọng tâm tiếp theo được chọn ngẫu nhiên với xác suất tỷ lệ với bình phương khoảng cách tới trọng tâm gần nhất đã chọn. Theo bài báo k-means++ của Arthur và Vassilvitskii đăng tại hội nghị SODA năm 2007, phương pháp này đảm bảo kết quả trong trường hợp xấu nằm trong O(log k) lần giá trị tối ưu.
Lịch sử phát triển của thuật toán
Ít ai ngờ rằng thuật toán phổ biến này đã có tuổi gần bảy thập niên. Stuart Lloyd thuộc Bell Labs đã đề xuất thuật toán năm 1957 trong một bản ghi nhớ nội bộ tên “Least square quantization in PCM”, dùng để nén tín hiệu trong truyền dữ liệu. Phải mười lăm năm sau đó, bản báo cáo chính thức mới được công bố trên tạp chí IEEE Transactions on Information Theory năm 1982, trang 129–137.
Trong giai đoạn này còn có hai phiên bản song song. Edward Forgy công bố cùng phương pháp vào năm 1965, nên thuật toán còn được gọi là thuật toán Lloyd–Forgy. Joel Max phát triển độc lập một biến thể, được gọi là Lloyd–Max, xuất bản năm 1960. Còn chữ “k-means” trong tên gọi là do James MacQueen dùng lần đầu vào năm 1967 trong bài báo “Some Methods for Classification and Analysis of Multivariate Observations”.
Ví dụ thực tế với bộ dữ liệu Iris
Bộ dữ liệu Iris là ví dụ kinh điển trong giáo trình học máy. Ronald Fisher công bố nó năm 1936 trên tạp chí Annals of Eugenics, gồm 150 bản ghi, chia đều 50 mẫu cho mỗi loài, với 4 đặc trưng đo bằng centimet là chiều dài và chiều rộng của đài hoa (sepal) và cánh hoa (petal). Nguyên liệu thô vẫn được lưu trữ tại kho dữ liệu UCI.
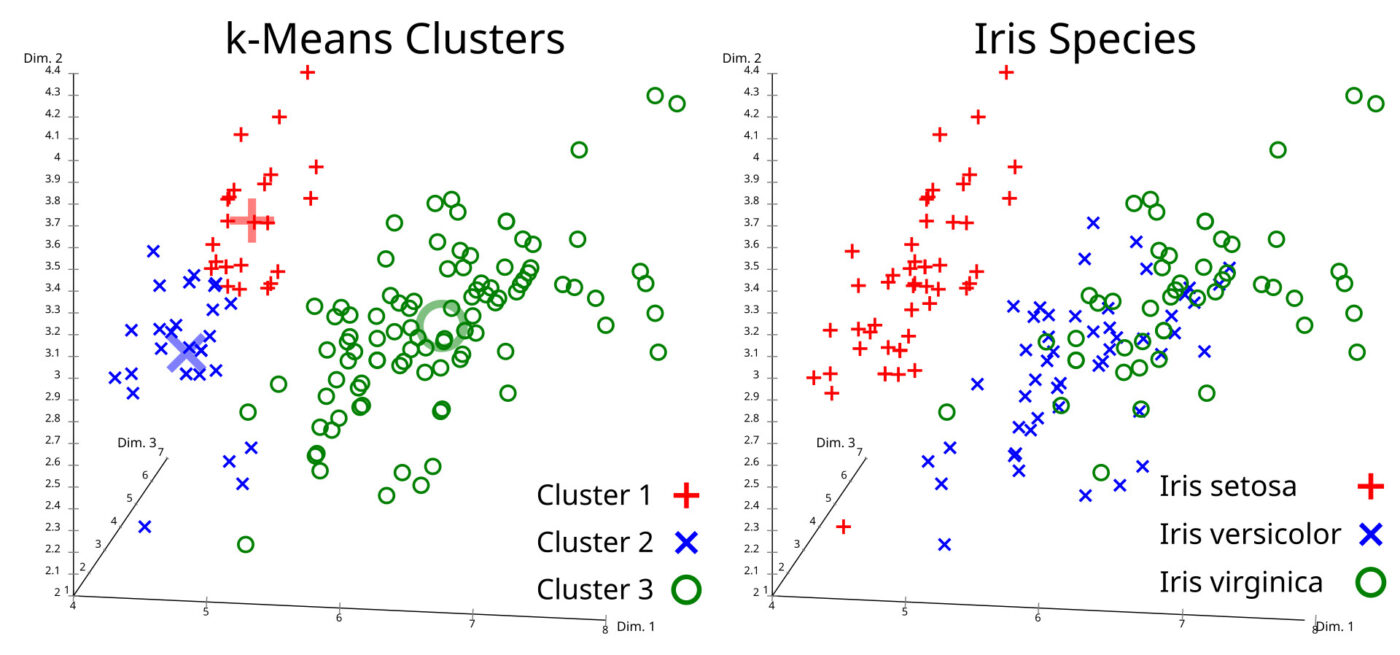
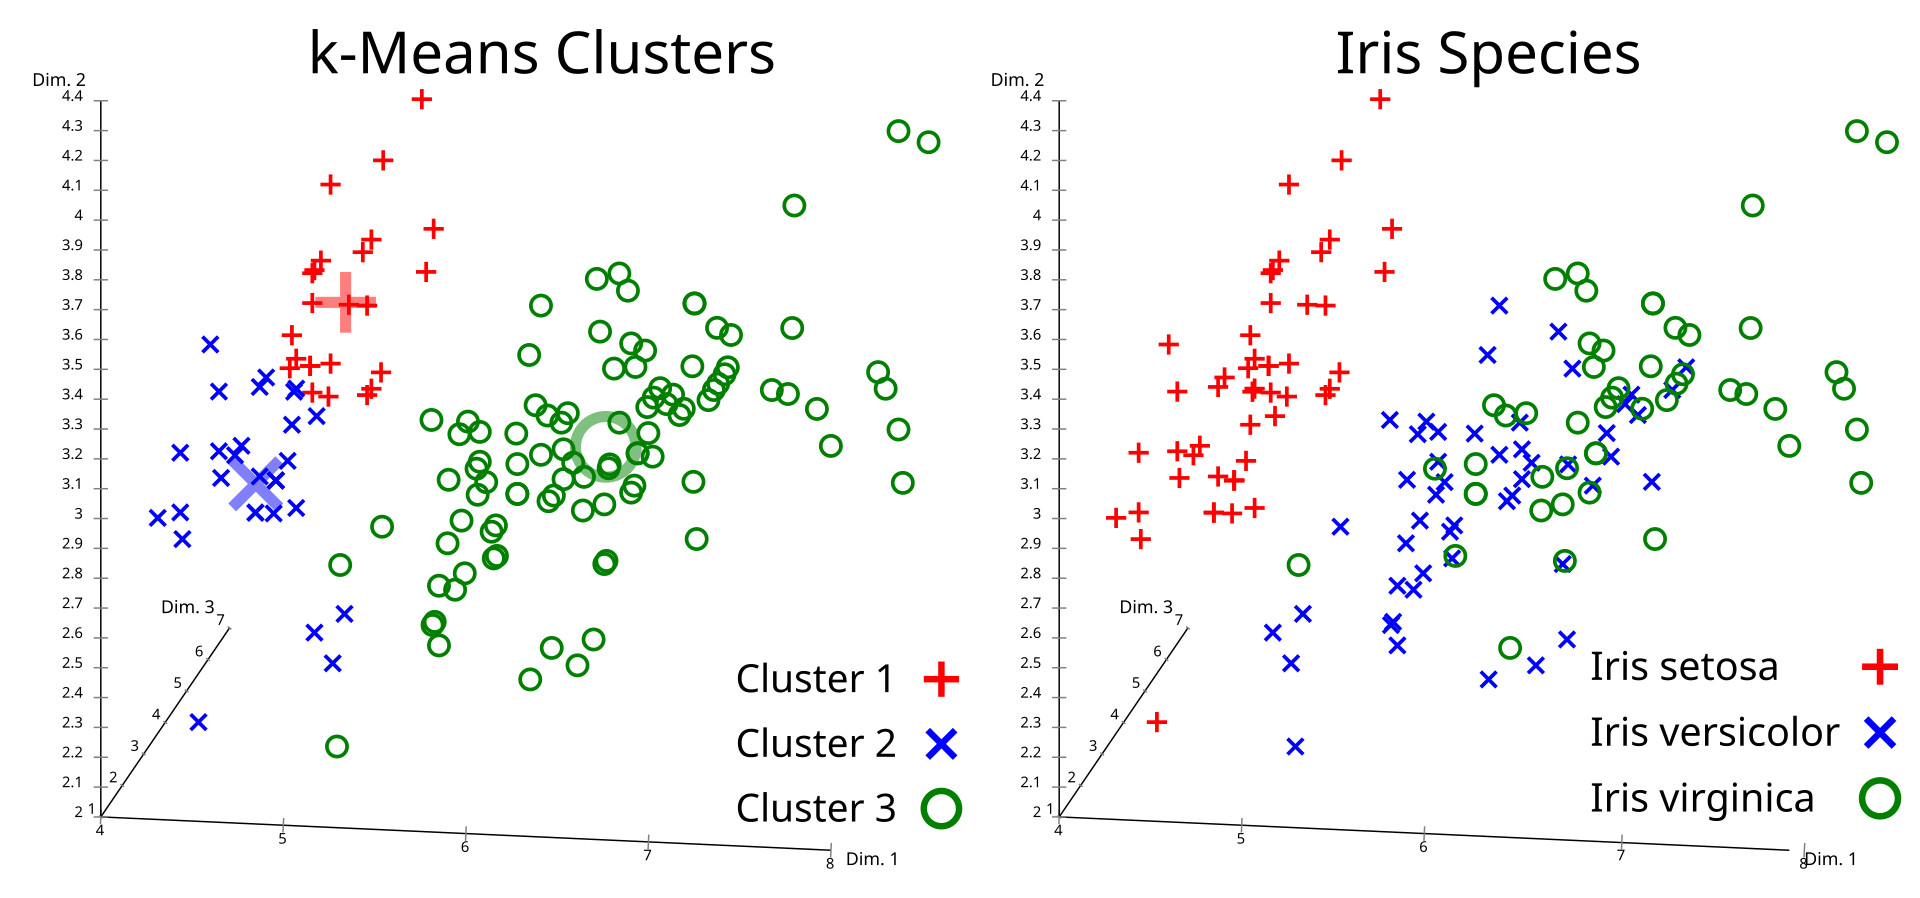
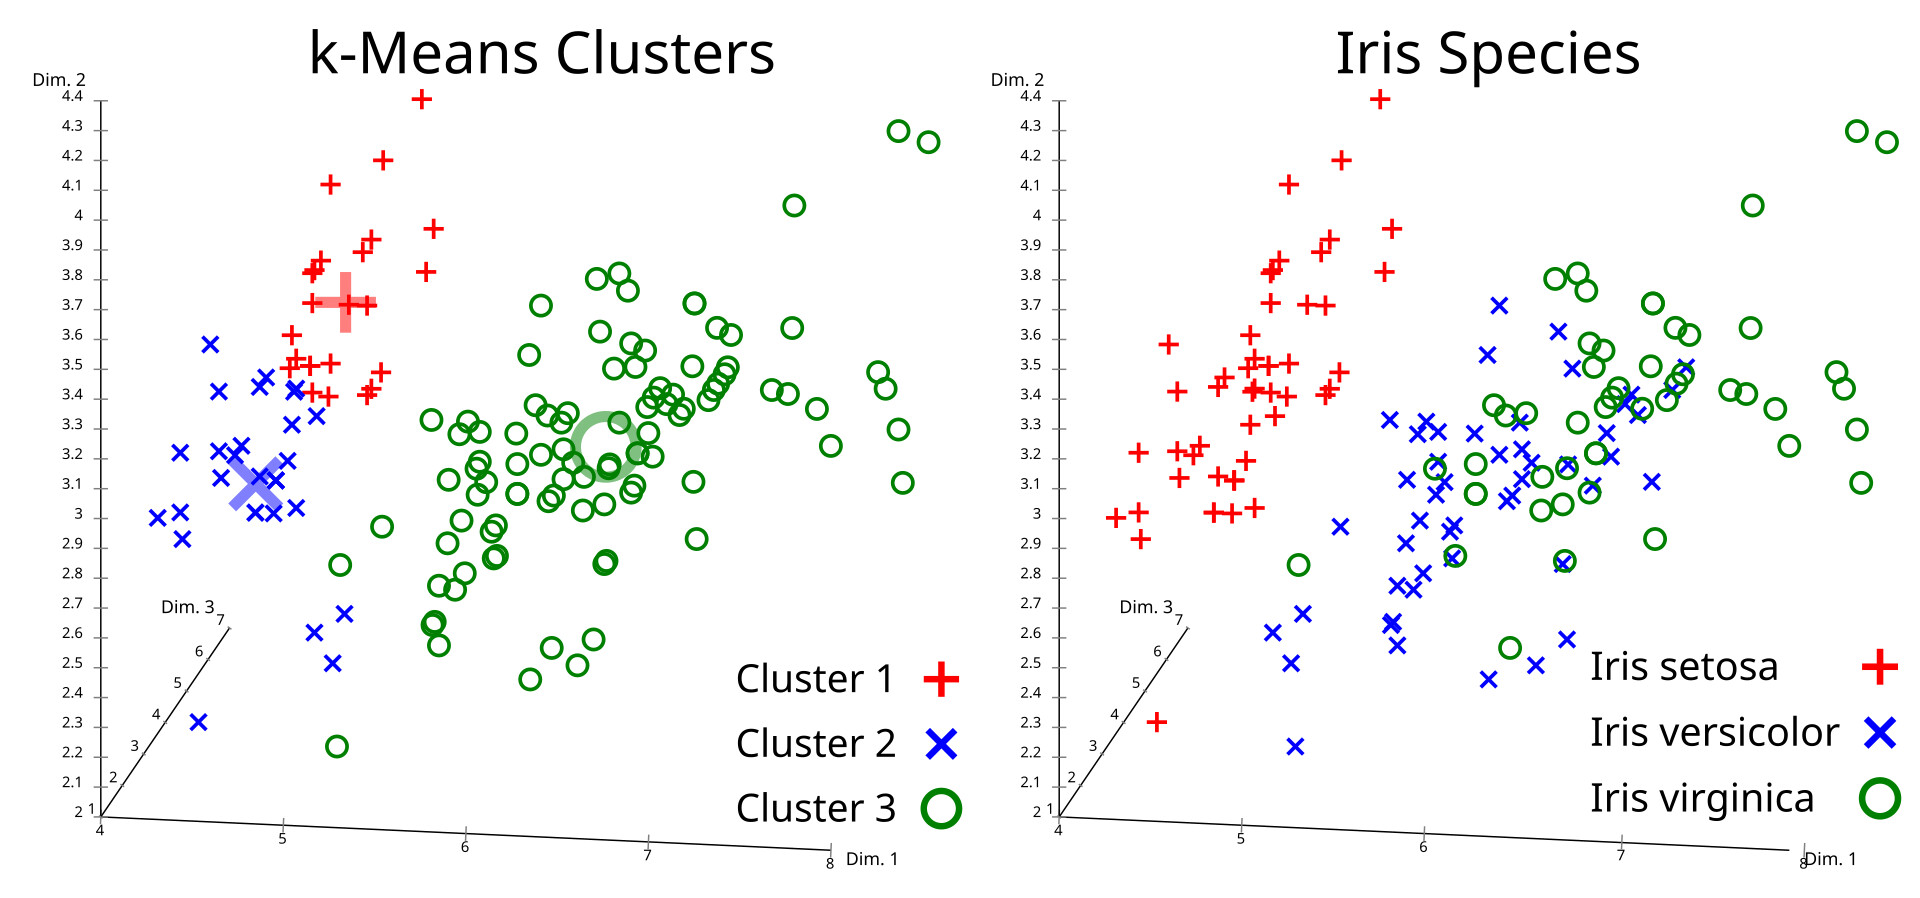
Áp dụng K-means với k bằng 3, thuật toán tìm ra ba cụm, và kết quả gần như trùng khớp với ba loài hoa thật. Hình minh họa dưới đây so sánh cụm do thuật toán suy ra với nhãn loài thực sự, cho thấy K-means hoạt động rất tốt trên dữ liệu này.
| Đặc trưng | Ý nghĩa |
|---|---|
| Sepal length | Chiều dài đài hoa, cm |
| Sepal width | Chiều rộng đài hoa, cm |
| Petal length | Chiều dài cánh hoa, cm |
| Petal width | Chiều rộng cánh hoa, cm |
| Species | Nhãn loài: Setosa, Versicolour, Virginica |
Trang hướng dẫn chính thức của scikit-learn cho biết mảng dữ liệu có kích thước 150 hàng và 4 cột, còn khung dữ liệu đầy đủ tính cả cột nhãn là 150 hàng và 5 cột.
Độ phức tạp tính toán
Một vòng lặp của thuật toán duyệt qua n điểm, so sánh với k trọng tâm trong không gian d chiều, nên chi phí là O(n·k·d). Nếu cần T vòng lặp để hội tụ thì tổng chi phí là O(n·k·d·T). Tài liệu lớp KMeans của scikit-learn ghi độ phức tạp trung bình là O(k·n·T), ẩn đi số chiều d vì xem d là hằng số.
Trường hợp xấu nhất thì đáng ngạc nhiên hơn nhiều. Khi k và d cố định, bài toán tối ưu chính xác chạy trong O(n^(dk+1)), còn thuật toán Lloyd trong trường hợp xấu nhất có thể cần tới 2 mũ lớn nhất bằng căn bậc hai của n vòng lặp — tức là một chi phí lớn hơn nhiều so với đa thức. Với dữ liệu lớn, người ta thường dùng biến thể Mini-batch K-means, chỉ lấy mẫu ngẫu nhiên một lô nhỏ mỗi bước để giảm chi phí.
Cách chọn số K: khuỷu tay và silhouette
Phương pháp khuỷu tay (elbow method)
Khuỷu tay là cách trực quan quen thuộc nhất: vẽ giá trị inertia lên trục tung, số cụm k lên trục hoành, rồi chọn k tại điểm đường cong bắt đầu nằm ngang — tức điểm gập như khuỷu tay. Phương pháp này có từ bài báo của Thorndike năm 1953.
Điểm yếu là nó mang tính chủ quan. Nhiều trường hợp dữ liệu thực tế không có điểm gập rõ ràng, đường cong tròn xuôi và người đọc phải tự quyết định bằng kinh nghiệm.
Hệ số silhouette
Silhouette là cách định lượng, đáng tin hơn. Người đề xuất là Peter Rousseeuw năm 1987 trên tạp chí Computational and Applied Mathematics. Với mỗi điểm, ta tính a là khoảng cách trung bình tới các điểm cùng cụm, và b là khoảng cách trung bình nhỏ nhất tới một cụm khác bất kỳ. Sau đó:
s(i) = (b - a) / max(a, b)
Giá trị s nằm trong khoảng từ âm 1 đến dương 1. Gần 1 nghĩa là điểm khớp rất tốt với cụm của nó; gần 0 nghĩa là hai cụm có chồng lấn; âm nghĩa là điểm bị gán sai cụm. Khi cụm chỉ có một điểm thì s được đặt bằng 0.
Ví dụ minh họa của scikit-learn trên bộ Iris cho ra kết quả đáng suy nghĩ: giá trị silhouette trung bình cao nhất rơi vào k bằng 2 với khoảng 0,705, cao hơn k bằng 3 là 0,588, dù bộ Iris rõ ràng có ba loài thật. Cùng dữ liệu đó cho k bằng 4 là 0,651 và k bằng 6 là 0,486. Đây là minh họa rõ ràng cho thấy con số tối ưu theo chỉ số thống kê không nhất thiết trùng với số cụm “đúng theo thực tế”.
| Số cụm k | Silhouette trung bình trên Iris |
|---|---|
| 2 | 0,705 |
| 3 | 0,588 |
| 4 | 0,651 |
| 5 | 0,561 |
| 6 | 0,486 |
Những giới hạn cần biết trước khi dùng
- Chỉ tìm cục bộ tối ưu. Chạy với nhiều khởi tạo ngẫu nhiên và giữ lại kết quả có inertia thấp nhất là cách khắc phục tiêu chuẩn. Thư viện scikit-learn mặc định khởi tạo bằng k-means++ và tối đa 300 vòng lặp, với ngưỡng dung sai mặc định là 1e-4.
- Yêu cầu cụm hình cầu và kích thước tương đối đều. Dữ liệu dạng thuôn dài hoặc cụm có mật độ khác nhau sẽ cho kết quả sai.
- Nhạy với dữ liệu nhiễu và giá trị ngoại lai. Trung tâm bị kéo lệch bởi một điểm xa, nên cần tiền xử lý hoặc chuẩn hoá dữ liệu trước.
- Chỉ dùng cho dữ liệu số. Dữ liệu phân loại cần mã hoá trước; cách mã hoá ảnh hưởng lớn tới kết quả.
Tóm lại, K-means vẫn là lựa chọn hợp lý khi cần một thuật toán nhanh, dễ hiểu và hoạt động ổn định trên dữ liệu số quy mô vừa. Hãy dùng k-means++ khi khởi tạo, chạy nhiều lần với các hạt giống khác nhau, và kiểm tra kết quả bằng silhouette chứ không chỉ dựa vào đồ thị khuỷu tay. Tài liệu chi tiết về cách dùng và các tham số có tại trang hướng dẫn phân cụm của scikit-learn.