Autoencoder là gì: cách nén và tái tạo dữ liệu bằng mạng nơ-ron
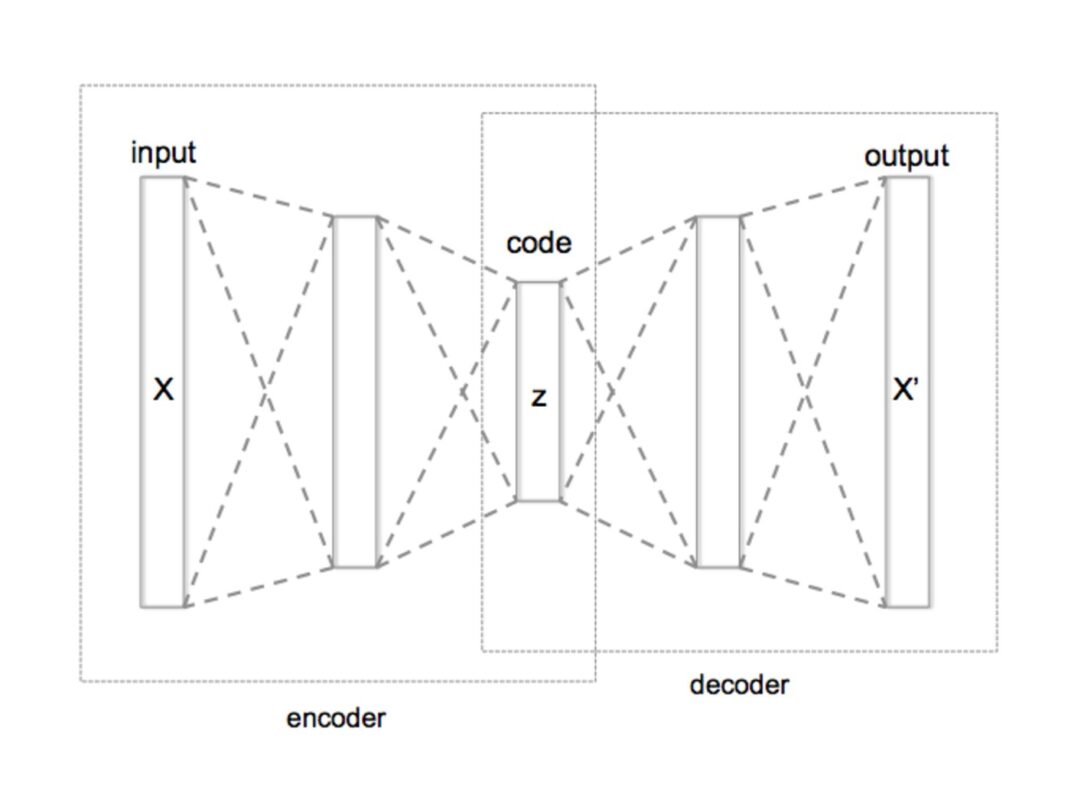
Autoencoder là gì? Đây là kiến trúc mạng nơ-ron hai phần, gồm encoder nén dữ liệu đầu vào thành một mã nhỏ hơn và decoder dựng lại dữ liệu gốc từ mã đó. Mô hình không cần nhãn để huấn luyện, nên nó thuộc nhóm học không giám sát và được dùng làm nền tảng cho nhiều bài toán khác.
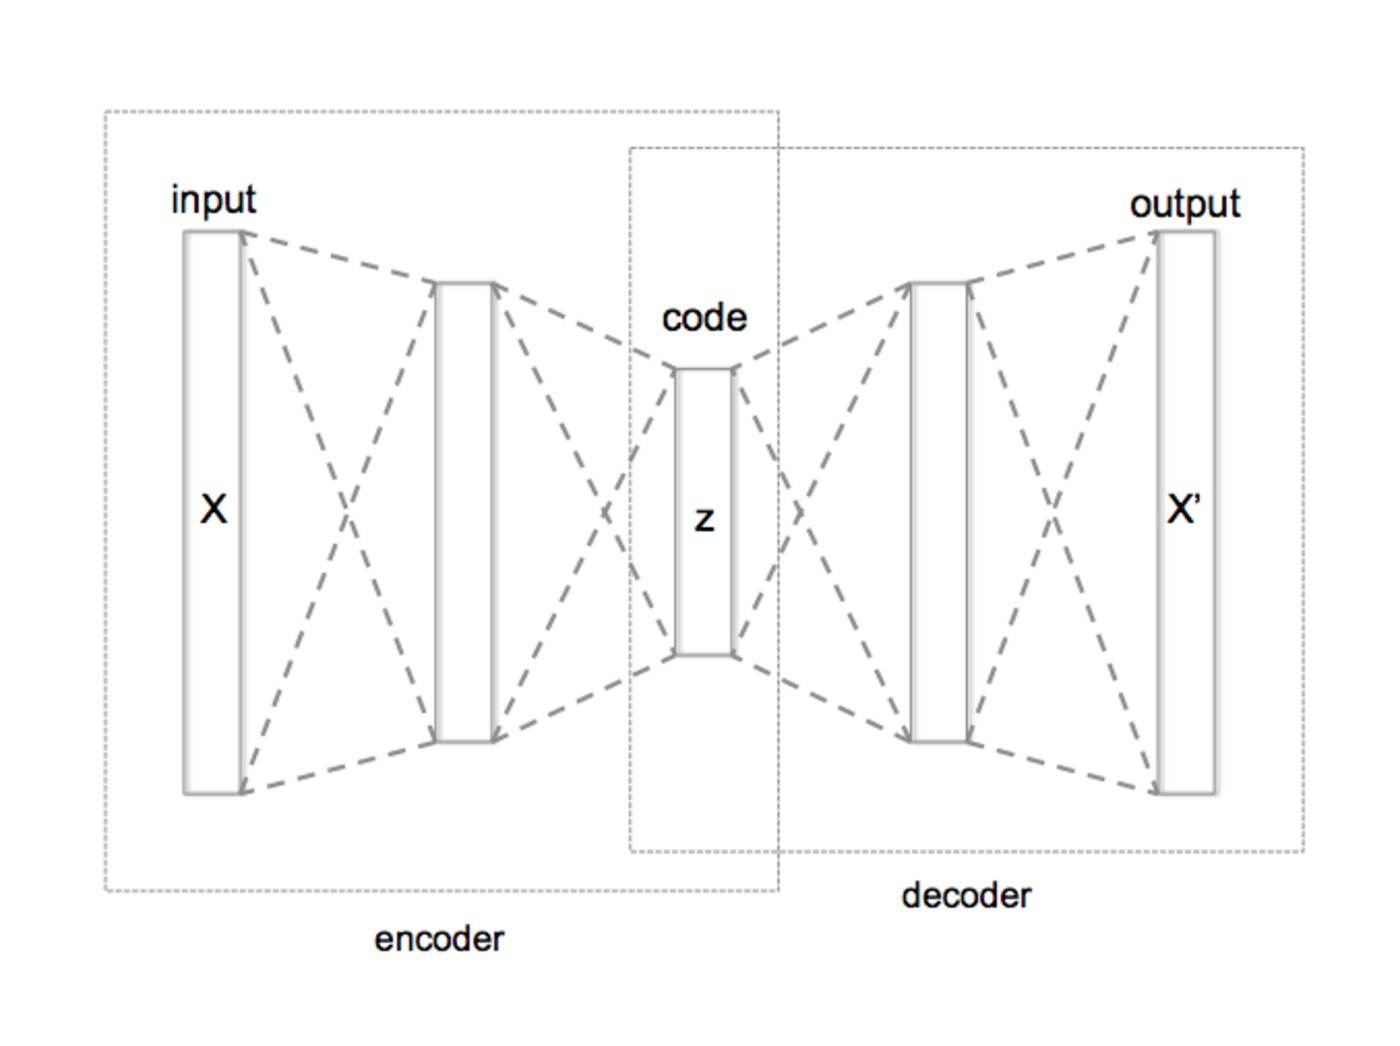
Cấu trúc của một autoencoder
Giả sử dữ liệu đầu vào là một ảnh chữ số viết tay kích thước 8×8, tức 64 giá trị pixel nguyên. Bộ dữ liệu load_digits của scikit-learn đúng như vậy: mỗi mẫu có 64 chiều, tổng cộng 1.797 ảnh chia làm 10 lớp chữ số. Đưa ảnh này vào encoder, ta thu được một vector mã chỉ còn 3 chiều. Decoder nhận vector 3 chiều ấy và trả về một bản 64 pixel gần với ảnh gốc.
Điểm cốt lõi nằm ở chỗ tầng ẩn của autoencoder hẹp hơn đầu vào. Nếu ta cho phép mã rộng bằng hoặc bằng số chiều đầu vào, mô hình chỉ cần học cách chép y nguyên đầu vào sang đầu ra và trở thành một máy sao chép vô dụng. Chính cái cổ chai buộc mô hình phải chọn ra thông tin quan trọng nhất, giống như cách nén ZIP buộc phần mềm tìm ra cấu trúc lặp trong dữ liệu.
Quá trình huấn luyện chỉ tối ưu một hàm chi phí tái tạo: sai khác giữa đầu ra và đầu vào. Nếu ta còn thêm một số hạng phạt độ dài của mã thì tổng chi phí là tổng của hai thành phần đó.
Autoencoder tuyến tính chính là PCA
Một kết quả lý thuyết quan trọng: khi cả encoder và decoder đều là hàm tuyến tính, và hàm chi phí là bình phương trung bình, thì toàn bộ bài toán tối ưu giảm về phân tích thành phần chính. Giá trị kích hoạt ở tầng ẩn chính là toạ độ dọc theo các vector riêng đầu tiên của ma trận hiệp phương sai dữ liệu, còn đầu ra chính là phép chiếu trực giao của dữ liệu lên không gian con đó.
Nói cách khác, với một lớp ẩn tuyến tính, bạn không học được gì mà PCA chưa làm được. Chỉ khi đưa hàm kích hoạt phi tuyến vào, autoencoder mới vượt qua được giới hạn đó và trở thành một dạng PCA phi tuyến. Đây là lý do các bài nghiên cứu đầu tiên về autoencoder nhiều lớp đều so sánh trực tiếp với PCA.
Các biến thể quan trọng
Autoencoder khử nhiễu
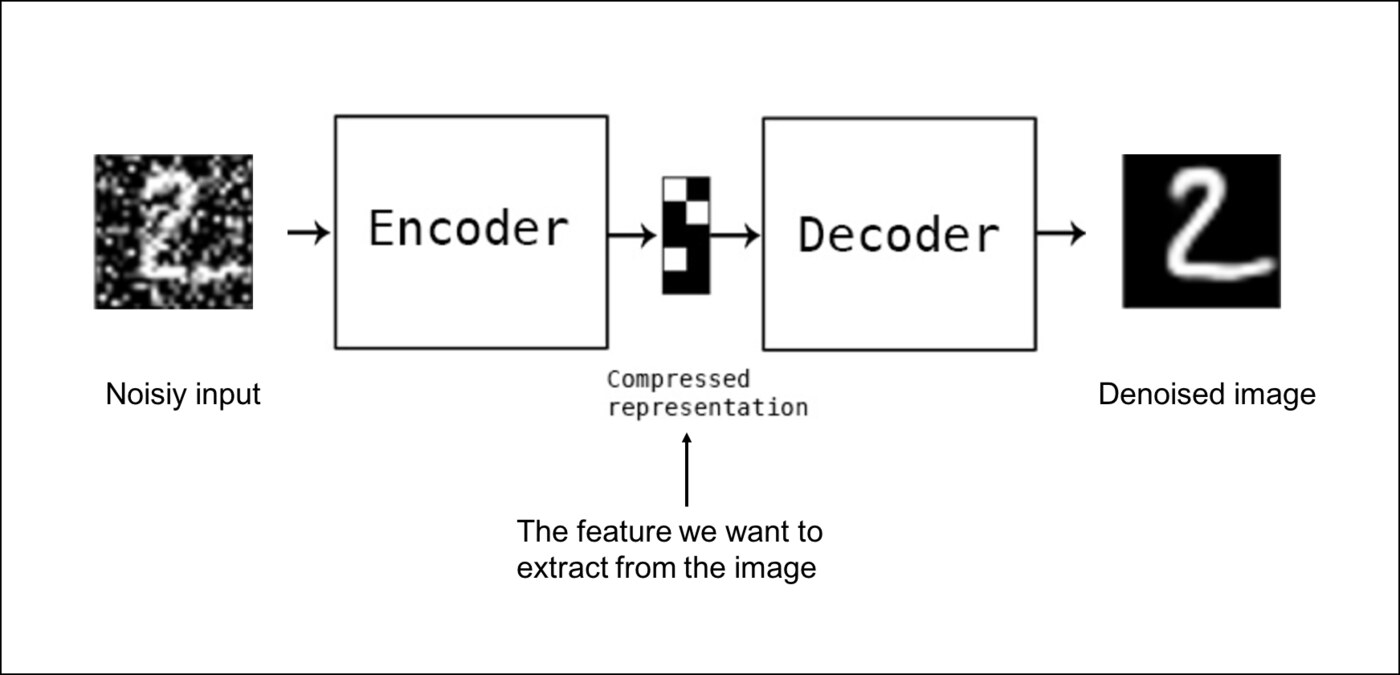
Ta thêm nhiễu ngẫu nhiên vào dữ liệu trước khi đưa vào mô hình, rồi bắt mô hình tái tạo lại bản sạch. Nhiễu có thể là nhiễu Gaussian, che khuất ngẫu nhiên hay nhiễu muối tiêu. Kết quả là một mô hình đã học được biểu diễn đặc trưng ổn định hơn trước nhiễu, nhờ điều kiện bắt mô hình phải đẩy thông tin nhiễu ra khỏi mã.
Autoencoder thưa
Ở đây ta thêm hình phạt khiến phần lớn phần tử mã tiến gần bằng không, buộc mô hình dùng mã một cách tiết chế. Biến thể thưa còn cho phép tầng ẩn rộng hơn đầu vào, chẳng hạn chỉ giữ các giá trị kích hoạt lớn nhất trong mỗi mẫu.
Autoencoder co giãn
Biến thể này cộng thêm một hàm phạt đo bình phương chuẩn Frobenius của ma trận Jacobi của encoder, tức là biến dạng cục bộ của đầu vào không được thay đổi mạnh ở tầng mã.
Autoencoder biến phân
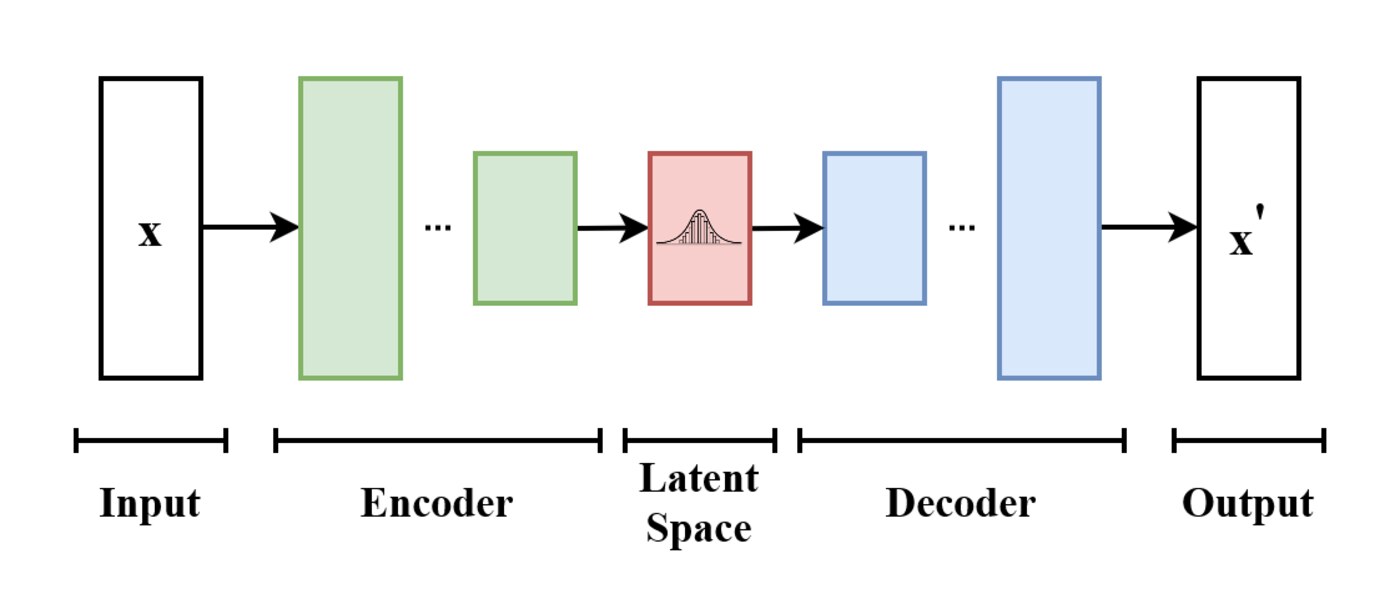
VAE là bước nhảy lớn nhất. Thay vì xuất ra một điểm trong không gian mã, encoder của VAE xuất ra một phân phối, thường là Gaussian đa chiều. Bài báo gốc của Kingma và Welling năm 2013 giới thiệu thủ thuậc tái tham số hoá để lấy mẫu được trong khi vẫn truyền được gradient về ngược, kèm một hạng phạt là phân khoảng Kullback-Leibler giữa phân phối mã và phân phối tiền tiêu chuẩn.
Bản ví dụ chính thức trên Keras dùng latent_dim bằng 2 và bộ lọc tích chập 32 rồi 64 kênh. Tổng số tham số phần encoder tính ra là 69.076, và trong quá trình huấn luyện hàm chi phí tái tạo rơi từ 473,80 xuống còn 144,20 sau 30 vòng lặp.
So sánh các biến thể
| Biến thể | Đầu vào khi huấn luyện | Mã nhận được | Công dụng chính |
|---|---|---|---|
| Tuyến tính | Dữ liệu gốc | Một điểm | PCA, giảm chiều tuyến tính |
| Khử nhiễu | Dữ liệu đã nhiễu | Một điểm | Làm sạch dữ liệu, tiền xử lý |
| Thưa | Dữ liệu gốc | Mã thưa | Tách đặc trưng dễ đọc |
| Co giãn | Dữ liệu gốc | Mã ổn định cục bộ | Tránh biến dạng vùng |
| Biến phân | Dữ liệu gốc | Phân phối xác suất | Sinh dữ liệu mới, mã theo cụm |
Ba ứng dụng thực tế
- Nén và giảm chiều. Mã của tầng ẩn là một dạng nén học được, dùng để giảm số chiều trước khi đưa vào mô hình khác. Hinton và Salakhutdinov từng dùng một tầng cổ chai 30 đơn vị cho bộ MNIST và cho thấy sai khác tái tạo nhỏ hơn so với 30 thành phần chính đầu tiên của PCA, đồng thời mã dễ phân cụm hơn.
- Phát hiện bất thường. Chỉ huấn luyện trên dữ liệu bình thường rồi coi sai khác tái tạo là điểm bất thường, đặt ngưỡng ở khoảng phân vị 95 của tập kiểm định. Cần lưu ý mô hình đôi khi tái tạo được cả mẫu lạ, nên đây chỉ là tín hiệu cảnh báo chứ không phải phán quyết.
- Tiền huấn luyện đặc trưng. Huấn luyện encoder trên dữ liệu không nhãn rồi chỉ giữ lại phần encoder làm đầu vào cho các bài toán có nhãn, giảm đáng kể nhu cầu dữ liệu gán nhãn.
Nguồn tham khảo
Đọc thêm tại bài Autoencoder trên Wikipedia, phần biến thể VAE tại Variational autoencoder, bài gốc của Kingma và Welling trên arXiv 1312.6114, ví dụ xây dựng VAE với số liệu tham số tại Keras Generative VAE, thông tin bộ dữ liệu ảnh chữ số 8×8 tại scikit-learn load_digits và bài tổng quan học biểu diễn tại arXiv 1206.5538.