Biểu thức chính quy (tên tiếng Anh là regular expression, thường gọi tắt là regex) là một mẫu văn bản dùng để mô tả một họ những chuỗi ký tự cụ thể. Bạn có thể dùng nó để tìm kiếm, thay thế hoặc kiểm tra dữ liệu. Trong lập trình, regex xuất hiện khắp mọi nơi: lọc địa chỉ email, phân tích nhật ký máy chủ, tách chuỗi theo dấu phân cách, hay kiểm tra định dạng mã đơn hàng. Tuy nhiên, điều thú vị hơn cả cách dùng là cách máy tính thực sự hiểu và thực thi biểu thức chính quy.
Thuật toán Thompson (tên đầy đủ là McNaughton-Yamada-Thompson) là phương pháp chuẩn để biến một biểu thức chính quy bất kỳ thành một máy trạng thái hữu hạn phi xác định, viết tắt là NFA (nondeterministic finite automaton). Nếu bạn đã từng dùng lệnh grep hoặc hàm re.search trong Python mà tự hỏi chúng hoạt động thế nào, câu trả lời nằm ở chỗ biểu thức của bạn được biến đổi thành một cỗ máy trạng thái trước khi bắt đầu so khớp văn bản.
Về bản chất, biểu thức chính quy và máy trạng thái hữu hạn là hai cách khác nhau để mô tả cùng một họ ngôn ngữ. Biểu thức chính quy thân thiện với con người: bạn có thể nhìn thấy ngay ý nghĩa của một mẫu. Máy trạng thái thân thiện với máy tính: nó chỉ có các trạng thái và các cung chuyển, không có khái niệm trừu tượng. Công việc của thuật toán Thompson chính là làm cầu nối giữa hai cách biểu diễn đó.
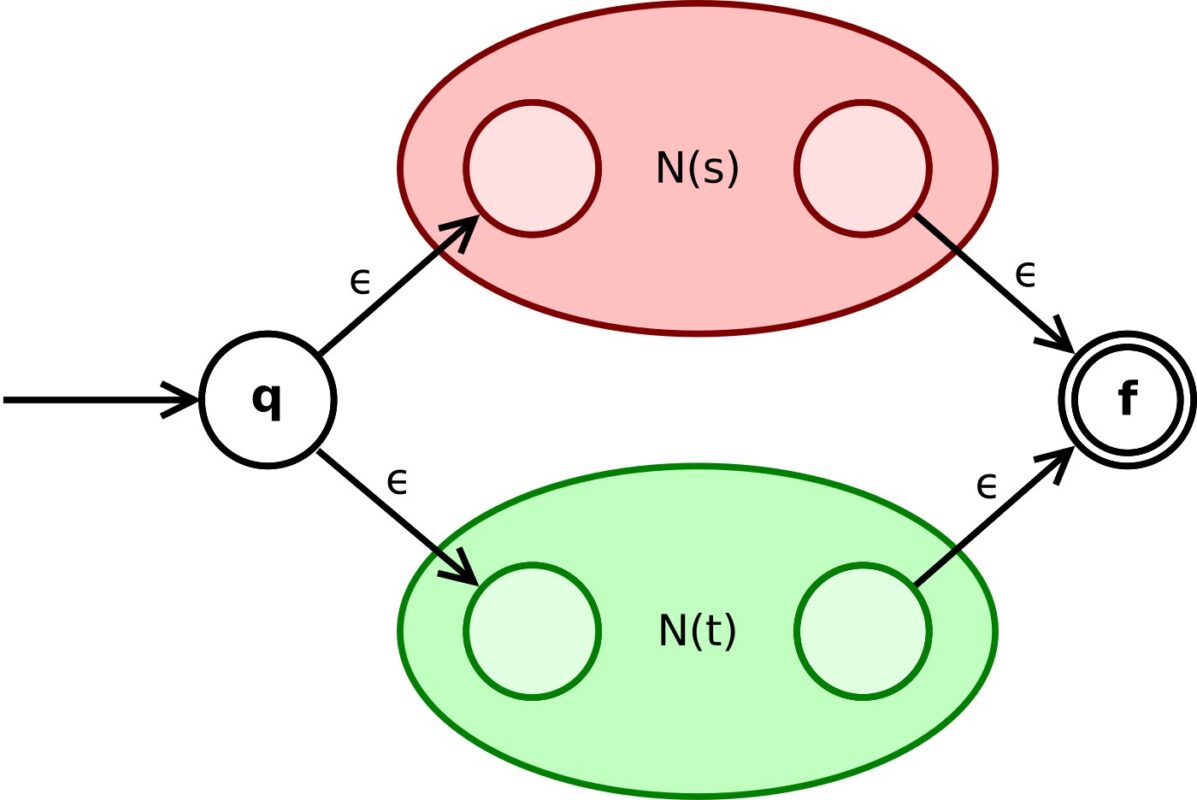
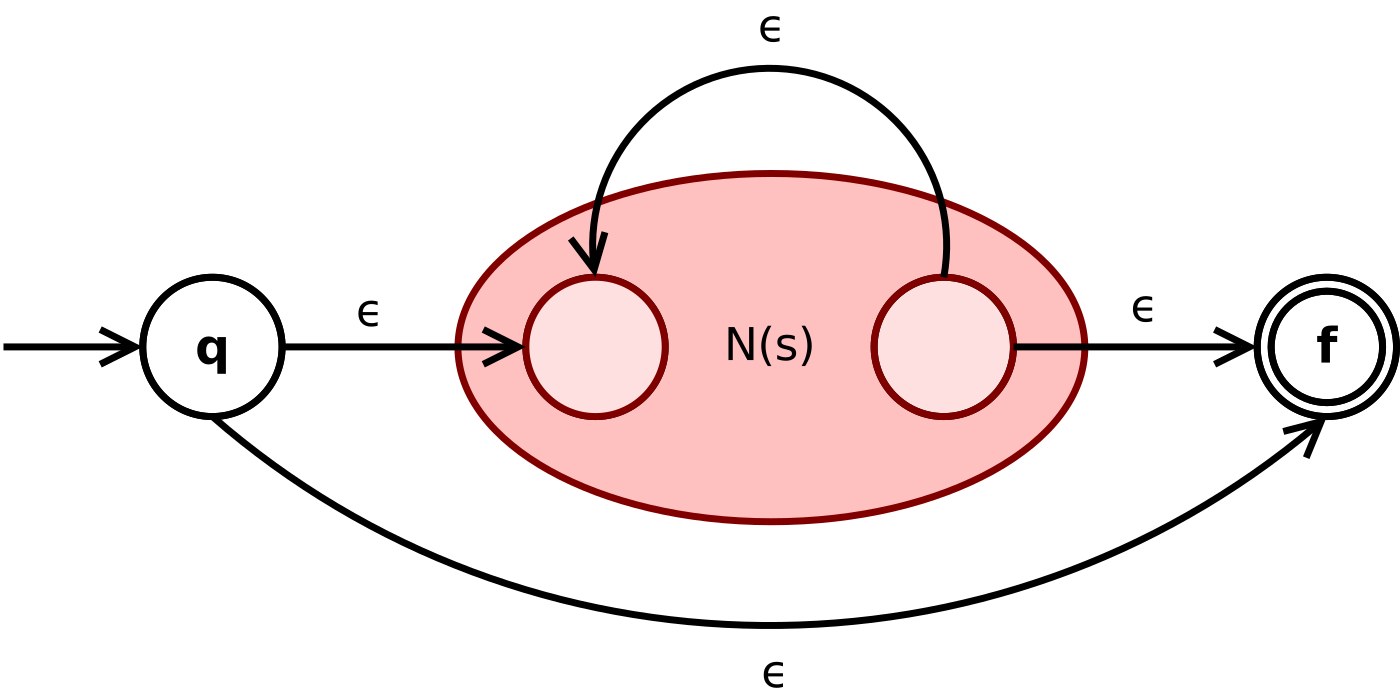
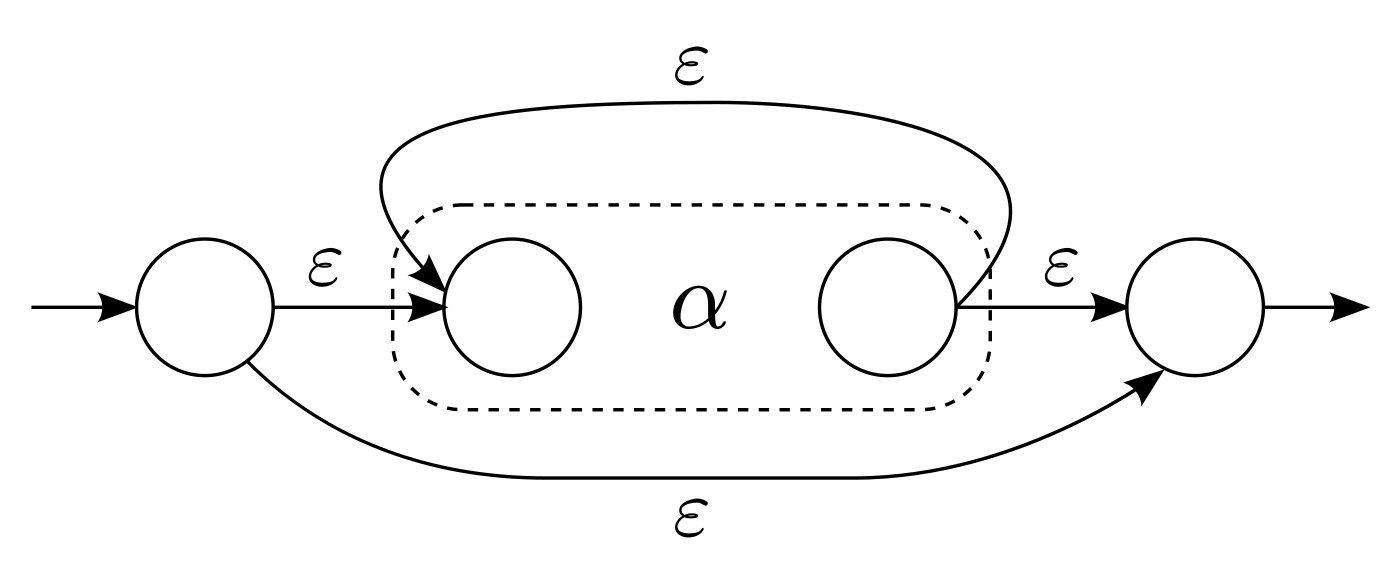
Thuật toán dựng NFA theo kiểu quy nạp cấu trúc. Nó bắt đầu từ hai trường hợp cơ bản nhất rồi lắp ghép. Trường hợp cơ bản thứ nhất là biểu thức rỗng, được biểu diễn bằng một trạng thái đầu nối bằng chuyển epsilon tới một trạng thái cuối. Trường hợp cơ bản thứ hai là một ký tự đơn lẻ, được biểu diễn bằng hai trạng thái nối bằng một cung có nhãn là chính ký tự đó. Từ hai khối này, thuật toán ghép chúng lại thành những phép toán phức tạp hơn: phép hợp nhất (ký hiệu dấu gạch đứng) nối hai NFA con bằng hai chuyển epsilon tách ra, phép nối tiếp (chỉ viết cạnh nhau) nối trạng thái cuối của NFA thứ nhất vào trạng thái đầu của NFA thứ hai, còn toán tử lặp Kleene (dấu sao) bọc một NFA con giữa hai chuyển epsilon quay vòng.
Điểm đáng chú ý về cấu trúc thuật toán là mọi NFA sinh ra đều có đúng một trạng thái đầu, không nào dẫn tới nó, và đúng một trạng thái cuối, không nào dẫn tới từ nó. Nhờ tính chất này, khi so sánh hai biểu thức chính quy xem chúng có mô tả cùng một họ chuỗi hay không, ta chỉ cần dựng NFA cho từng bên rồi so các nhãn cung và tên trạng thái sau khi đổi tên cho khớp.
Một ví dụ kinh điển minh hoạ sức mạnh của biểu thức chính quy là mẫu (0|1(01*00)*1)*, mô tả tất cả các chuỗi nhị phân biểu diễn cho bội của 3. Khi áp dụng thuật toán Thompson, ta được một NFA với cấu trúc cây cú pháp bên phải, bên trái là NFA kết quả với trạng thái vào và ra của mỗi biểu thức con được tô màu khác nhau. Từ NFA này, ta có thể tiếp tục dùng phép lũy thừa tập hợp (powerset construction) để chuyển thành DFA, rồi tối ưu bằng thuật toán tối thiểu hóa để thu được một DFA nhỏ nhất tương đương.
Lợi ích lớn nhất của cách tiếp cận dựa trên thuật toán Thompson nằm ở hiệu năng. Nếu biểu thức có độ dài m và chuỗi cần so khớp có độ dài n, thời gian so khớp theo thuật toán mô phỏng NFA là tích của m và n. So sánh với cách tiếp cận quay lui thử và sai (backtracking), phương pháp này không bao giờ rơi vào tình huống thử hàng nghìn cách rồi lùi lại, nên thời gian chạy luôn dự đoán được. Đây chính là lý do các thư viện regex nghiêm túc như RE2 của Google hay regex engine của Rust đều xây dựng trên NFA thay vì quay lui.
Tuy nhiên, cái giá của hiệu năng ổn định là giới hạn về biểu thức. Vì bản chất của ngôn ngữ chính quy, thuật toán không thể xử lý các mẫu dùng tham chiếu ngược (backreference), tức là một mẫu yêu cầu kiểm tra xem chuỗi con nào đó có xuất hiện lại hay không. Tính năng này dễ dùng nhưng lại mang lại sức chứa năng vô hạn, và bất kỳ công cụ nào dựa trên NFA nghiêm túc đều sẽ từ chối mẫu dạng đó.
Nói tóm lại, biểu thức chính quy không chỉ là một cú pháp tìm kiếm văn bản mà là một ngôn ngữ hình thức có cấu trúc. Thuật toán Thompson biến cú pháp viết tay của con người thành mô hình toán học mà máy tính chạy được với thời gian chặt chẽ, nhờ đó nền tảng lý thuyết này ngày càng được ưu dụng rộng rãi trong thiết kế trình phân tích cú pháp, trình phân tích từ vựng, và cả trong lĩnh vực trí tuệ nhân tạo.
Bạn có thể tra cứu thêm định nghĩa chuẩn tại bài Thompson’s construction trên Wikipedia và đọc so sánh các biểu thức chính quy tại Regular expression.