Vector database là gì? Vector database là hệ quản trị dữ liệu được thiết kế riêng để lưu trữ, tìm kiếm và so sánh các vector đặc trưng (embedding) có số chiều cao. Nhờ cơ chế tìm kiếm gần xấp xỉ bằng cách so sánh khoảng cách, vector database trở thành hạ tầng không thể thiếu cho các ứng dụng AI, đặc biệt là hệ thống truy xuất ngữ cảnh (RAG), tìm kiếm ngữ nghĩa và gợi ý nội dung.
Khác với cơ sở dữ liệu quan hệ truyền thống tìm kiếm theo giá trị chính xác, vector database trả lời câu hỏi “những thứ giống với cái này” – tức là đo mức độ tương đồng ngữ nghĩa giữa các đoạn văn bản, hình ảnh hoặc âm thanh.
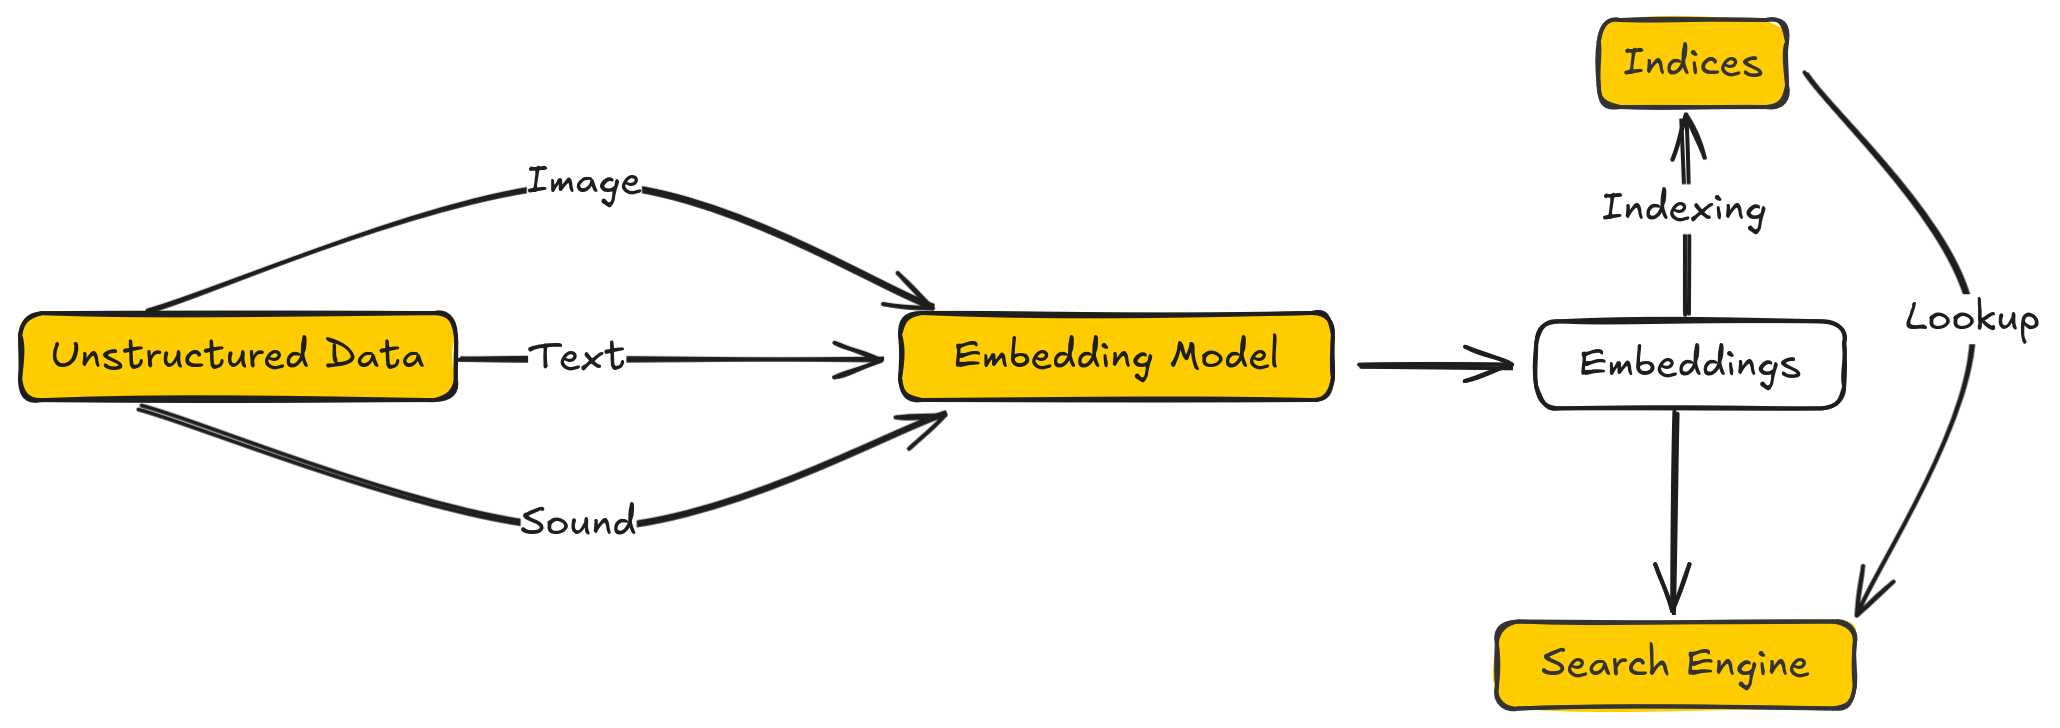
Vector database hoạt động như thế nào
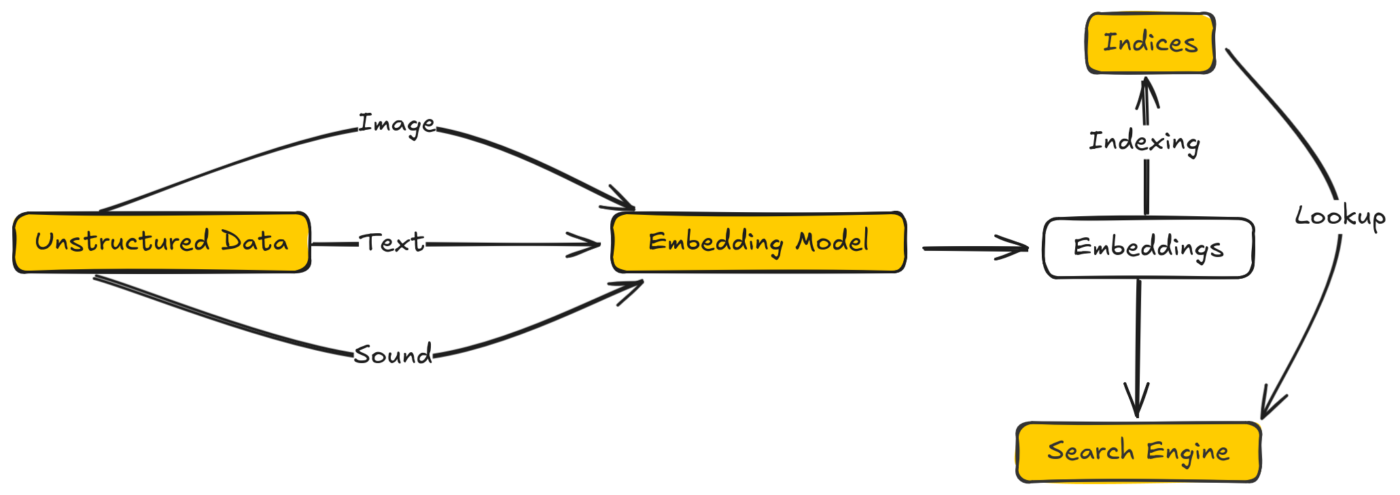
Quy trình gồm ba bước: đầu tiên, mô hình AI (chẳng hạn text embedding của OpenAI hoặc mô hình mã nguồn mở như bge-m3) biến mỗi đoạn văn bản thành một mảng số có chiều dài cố định, ví dụ 768 hoặc 1536 phần tử. Thứ hai, các vector này được lưu vào cơ sở dữ liệu kèm metadata. Thứ ba, khi người dùng gửi câu hỏi, câu hỏi cũng được chuyển thành vector rồi hệ thống tìm những vector gần nhất theo khoảng cách.
Các phép đo khoảng cách phổ biến gồm:
- Cosine similarity: so góc giữa hai hướng vector, phù hợp khi chỉ quan tâm hướng nghĩa chứ không quan tâm độ lớn.
- Dot product: tăng tốc tìm kiếm, thường dùng khi vector đã được chuẩn hoá đơn vị.
- Euclidean distance: khoảng cách thẳng, hợp với vector chưa chuẩn hoá.
Các thuật toán chỉ mục giảm thời gian tìm kiếm
So sánh tuyến tính toàn bộ vector rất tốn khi dữ liệu lớn, nên các hệ thống dùng cấu trúc chỉ mục đặc biệt:
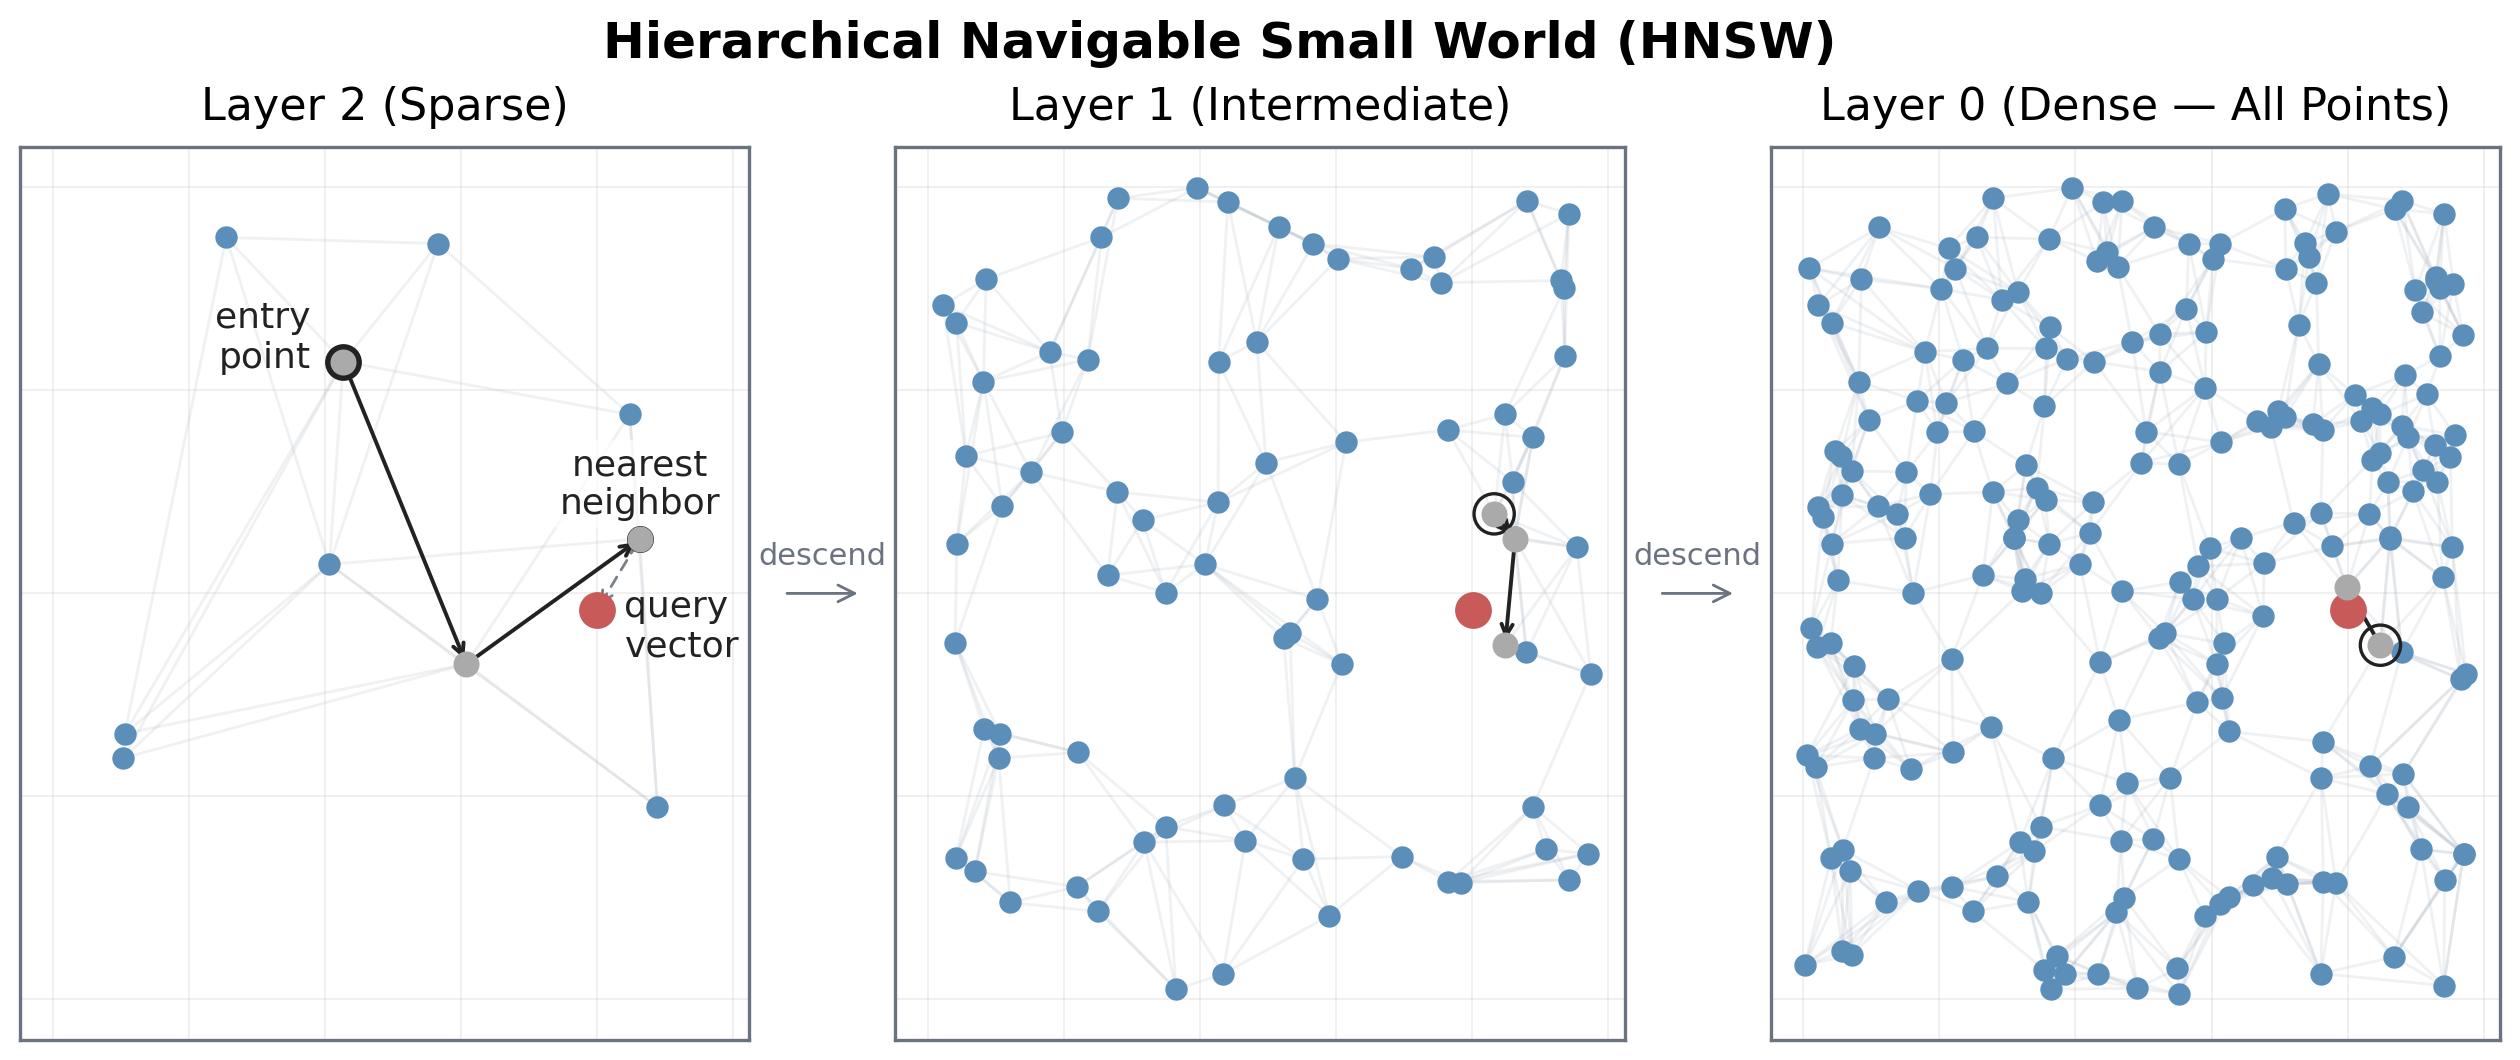
- HNSW – mạng lưới phân cấp đồ thị, xây dựng đồ thị với nhiều tầng lớn, tìm kiếm nhanh và chính xác, là lựa chọn phổ biến nhất.
- IVF – Inverted File, chia không gian thành các cụm rồi tìm trong một vài cụm gần truy vấn nhất.
- DiskANN – chỉ mục tối ưu cho dữ liệu nằm trên ổ cứng, phù hợp quy mô hàng triệu vector.
- ScaNN – thuật toán của Google, đánh đổi giữa độ chính xác và tốc độ tìm kiếm.
Điểm mấu chốt của các chỉ mục này là khả năng lọc sớm: nếu biết trước metadata cần dùng (ví dụ chỉ tìm trong tài liệu tiếng Việt của một thương hiệu), hệ thống loại bỏ phần lớn vector trước khi so sánh, nhờ vậy tốc độ tăng vọt.
Các vector database phổ biến
Bảng dưới đây so sánh một số lựa chọn mã nguồn mở và thương mại phổ biến nhất:
| Hệ thống | Kiểu chạy | Điểm mạnh |
|---|---|---|
| Milvus | Phân tán, Kubernetes | Quy mô rất lớn, hệ sinh thái Zilliz |
| Qdrant | Độc lập, Rust | Lọc metadata mạnh, payload filtering hiệu quả |
| Weaviate | Độc lập, Go | Tích hợp sẵn vectorizer và hybrid search |
| pgvector | Mở rộng PostgreSQL | Dùng chung hạ tầng với dữ liệu quan hệ |
| Chroma | Python, nhẹ | Prototype nhanh, phù hợp ứng dụng nhỏ |
| Pinecone | Cloud, SaaS | Không cần vận hành, có free tier |
Với hệ thống đã dùng PostgreSQL, thêm pgvector thường là lựa chọn hợp lý nhất vì gom cơ sở dữ liệu về một nơi, giảm chi phí vận hành và giữ được tính nhất quán giao dịch. Ngược lại, nếu dữ liệu vector lên tới hàng chục triệu vector và cần lọc phức tạp, Qdrant hoặc Milvus thường nhanh hơn đáng kể.
Vector database trong kiến trúc RAG
Vector database là thành phần trung tâm của RAG – kiến trúc giúp mô hình ngôn ngữ trả lời dựa trên tài liệu riêng thay vì trí nhớ huấn luyện. Luồng xử lý điển hình gồm hai giai đoạn:
- Ingest: tách tài liệu thành các đoạn nhỏ, mã hoá từng đoạn thành vector rồi nạp vào cơ sở dữ liệu kèm nguồn, thời gian và mức độ tin cậy.
- Query: câu hỏi được mã hoá, tìm top-k đoạn gần nhất, đưa vào ngữ cảnh cho LLM sinh câu trả lời kèm trích dẫn.
Đây là cấu trúc quen thuộc trong RAG. Bản chất của vector database chính là lớp lưu trữ bên dưới, nơi phép tìm kiếm gần nhất được thực hiện.
Những thách thức khi triển khai
- Chi phí bộ nhớ: vector chiều cao tốn dung lượng, cần nén (quantization) hoặc giảm số chiều.
- Chọn mô hình embedding: đổi mô hình là phải mã hoại toàn bộ dữ liệu, cần kế hoạch từ trước.
- Đánh giá chất lượng: cần bộ câu hỏi kiểm thử để đo tỉ lệ đúng của top-k kết quả, không thể dựa vào cảm nhận chủ quan.
- Lọc metadata: điều kiện lọc phức tạp có thể làm mất lợi thế tốc độ của chỉ mục vector.
Xu hướng hiện nay là kết hợp vector search với full-text search trong kiểu hybrid search, kết hợp thêm mô hình xếp hạng lại (reranker) để tăng chất lượng. Vector database giờ không còn đứng riêng lẻ mà ngày càng được tích hợp vào các nền tảng dữ liệu hiện đại. Bạn có thể tham khảo tài liệu chính thức của Qdrant hoặc dự án pgvector để bắt đầu.