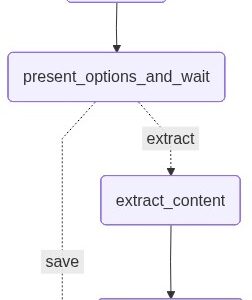
LangGraph: Xây dựng Agentic AI workflows có trạng thái
LangGraph là gì? LangGraph là framework mã nguồn mở của LangChain giúp xây dựng agentic AI workflows có trạng thái, quản lý vòng đời phức tạp và cấu trúc phân…
Xem thêm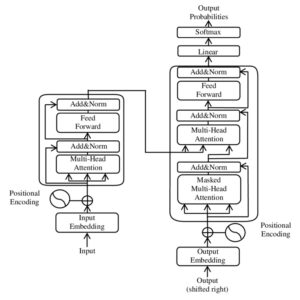
Mixture of Experts: Kiến trúc LLM hiệu quả với router thông minh
Mixture of Experts (MoE) là kiến trúc mô hình ngôn ngữ lớn chỉ kích hoạt một tập hợp con tham số mỗi token, giúp tăng hiệu năng suất tính toán…
Xem thêm
Phi-3 Mini và SmolLM: LLM siêu nhỏ chạy trên điện thoại mà không cần server
LLM chạy trực tiếp trên điện thoại đã ngừng là mơ và bắt đầu có mặt trong thực tế nhờ những mô hình siêu nhỏ như Phi-3 Mini (Microsoft) và…
Xem thêm
GGUF Quantization cho LLM: Tối ưu bộ nhớ, tốc độ và chất lượng
GGUF Quantization cho LLM: Tối ưu bộ nhớ, tốc độ và chất lượng Khi triển khai Large Language Models trên máy tính cá nhân, giới hạn lớn nhất không phải…
Xem thêm
LoRA & QLoRA: Fine-tune LLM trên GPU consumer mà không cần server đắt
LoRA & QLoRA: Fine-tune LLM hiệu quả trên GPU consumer mà không cần server đắt tiền Trong thời đại AI sinh tạo ngày nay, việc fine-tune mô hình ngôn ngữ…
Xem thêm
Speculative Decoding: Tăng tốc inference LLM 2-3x với draft model
Speculative decoding là kỹ thuật tăng tốc độ inference của Large Language Models (LLM) lên 2-3x mà không làm giảm chất lượng đầu ra. Ý tưởng cốt lõi: sử dụng…
Xem thêm
Multimodal AI: GPT-4o và Gemini Pro tích hợp văn bản, hình ảnh, âm thanh
Multimodal AI: GPT-4o và Gemini Pro tích hợp văn bản, hình ảnh, âm thanh GPT-4o multimodal interface demo: hiển thị đầu vào văn bản, hình ảnh và âm thanh Trí…
Xem thêm
Đánh giá RAG: Precision, Recall, Faithfulness trong Retrieval-Augmented Generation
Đánh giá RAG: Precision, Recall, Faithfulness trong Retrieval-Augmented Generation Khi xây dựng hệ thống RAG (Retrieval-Augmented Generation), việc đo lường chất lượng retrieval và generation là cực kỳ quan trọng….
Xem thêm Đánh giá RAG: Precision, Recall, Faithfulness trong Retrieval-Augmented Generation
Đánh giá RAG: Precision, Recall, Faithfulness trong Retrieval-Augmented Generation Khi xây dựng hệ thống RAG (Retrieval-Augmented Generation), việc đo lường chất lượng retrieval và generation là cực kỳ quan trọng….
Xem thêm
Vector Database so sánh: Pinecone, Weaviate, Qdrant, Chroma
Vector Database so sánh: Pinecone, Weaviate, Qdrant, Chroma Trong kiến trúc Retrieval-Augmented Generation (RAG), Vector Database đóng vai trò lưu trữ và tìm kiếm các embedding của dữ liệu. Không…
Xem thêm