Trong kiến trúc Retrieval-Augmented Generation (RAG), Vector Database đóng vai trò lưu trữ và tìm kiếm các embedding của dữ liệu. Không phải mọi hệ thống vector đều như nhau. Pinecone, Weaviate, Qdrant và Chroma mỗi cái có triết lý, điểm mạnh và điểm yếu riêng. Bài viết này so sánh chi tiết 4 nền tảng phổ biến nhất để bạn chọn đúng công cụ cho dự án AI của mình.
Pinecone: Managed Cloud-Native, triết lý serverless
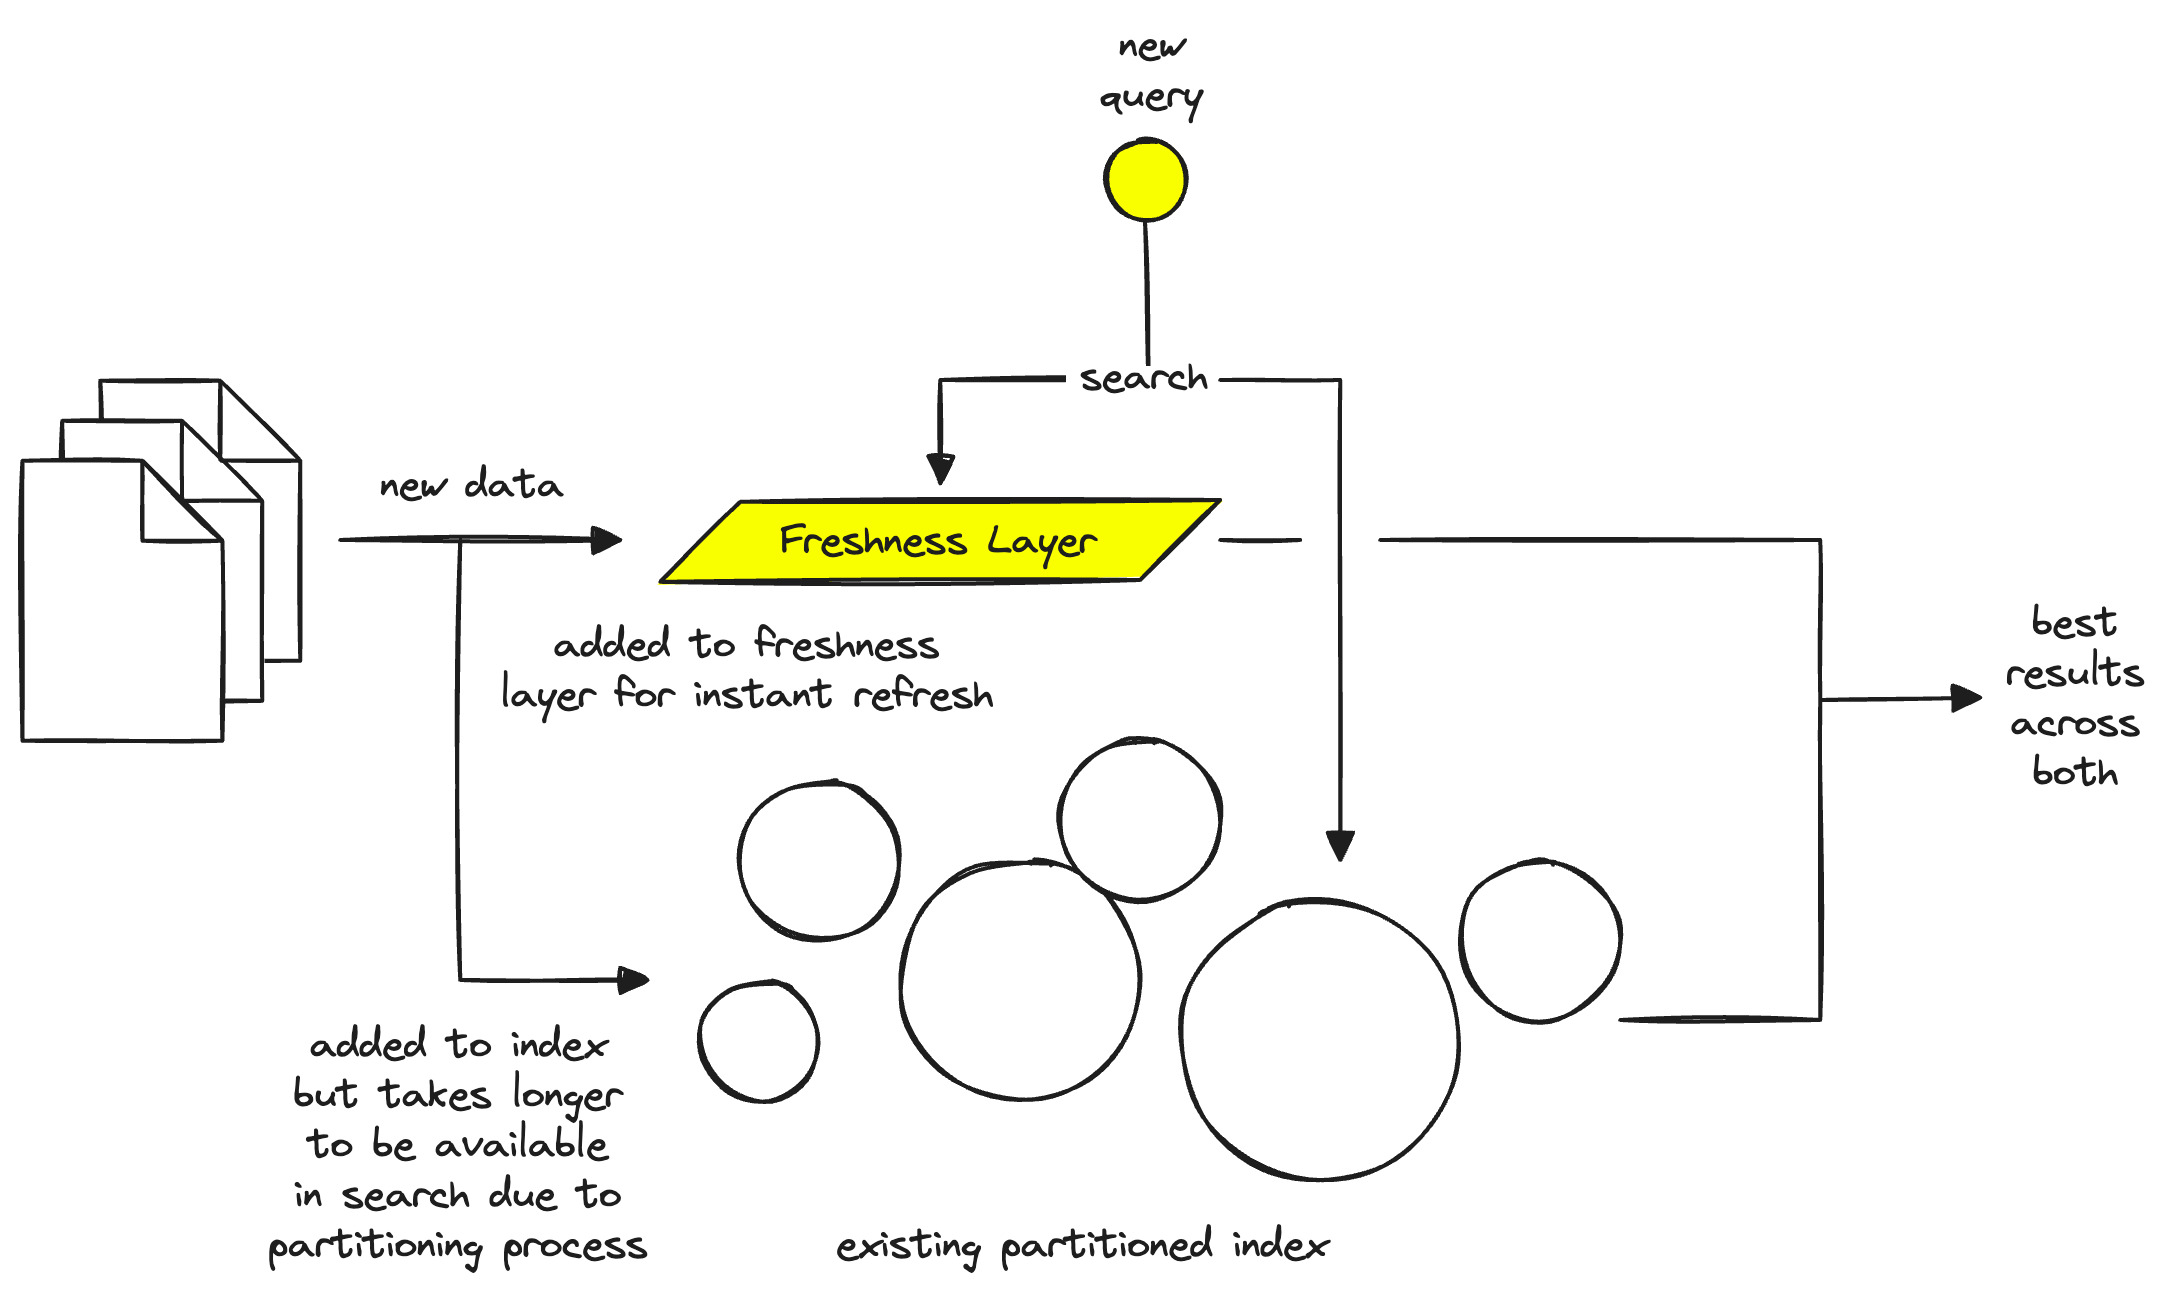
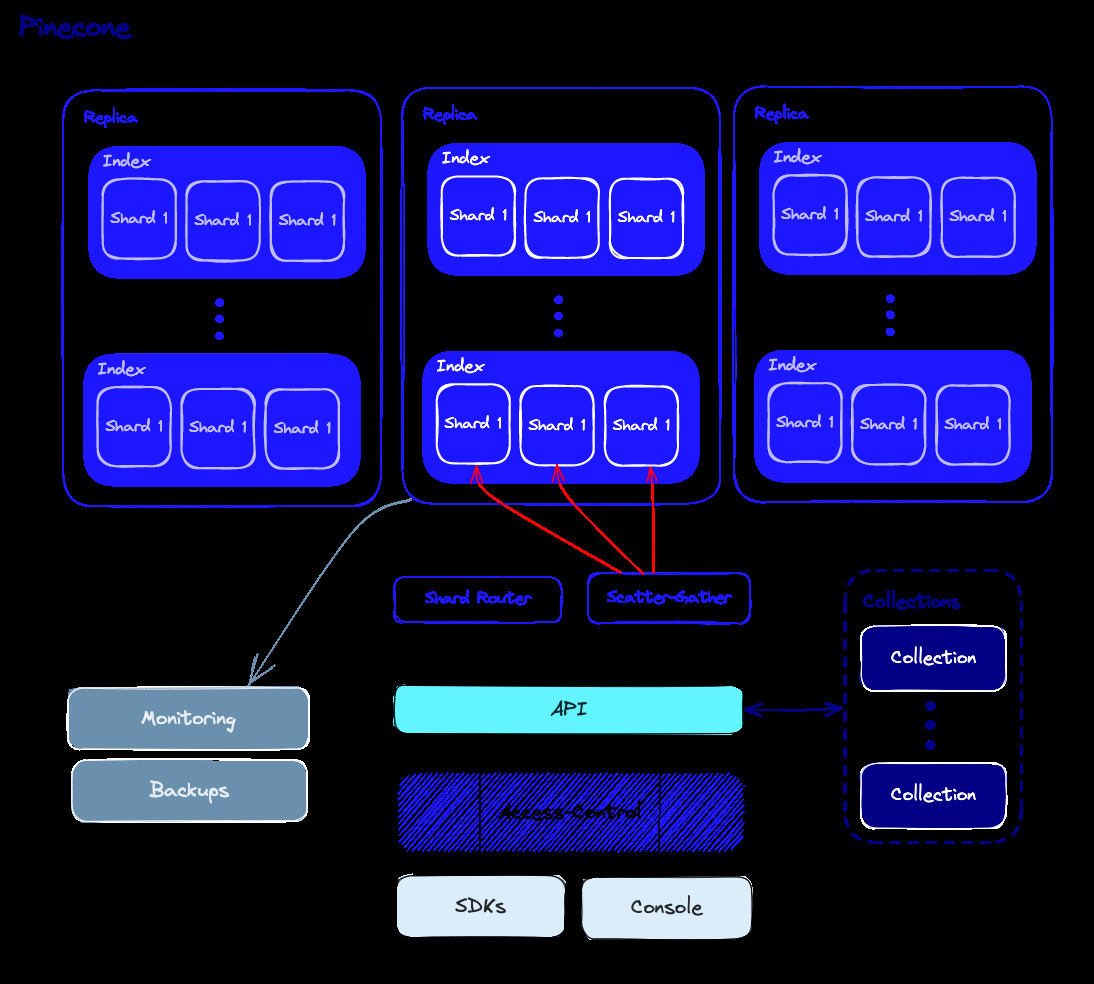
Pinecone ra đời năm 2019, định hình lại dòng Vector Database managed. Dịch vụ này lo toàn bộ infrastructure: sharding, replication, index tuning. Developer chỉ cần gọi API upsert, query, fetch.
Điểm mạnh lớn nhất là serverless architecture. Pinecone tự động scale theo traffic, không cần giữ node luôn chạy. Tên index, namespace, metadata filter đều có sẵn. Pricing theo read unit / write unit / storage, phù hợp workload biến động.
Nhược điểm: lock-in vendor. Không self-host được, phụ thuộc hoàn toàn vào cloud Pinecone. Giá có thể đắt khi vector count lên hàng tỷ. Hạn chế tùy biến index parameters so với các lựa chọn open-source.
Weaviate: Open-Source kết hợp vector + object storage
Weaviate khác biệt ở chỗ lưu object và vector cùng chỗ. Bạn có thể chèn document JSON, schema tự động sinh vector, rồi query hybrid (vector + keyword) ngay. Tính năng GraphQL và REST API đều có sẵn.
Weaviate hỗ trợ nhiều vectorizer modules: text2vec-openai, text2vec-cohere, img2vec-clip, generative-openai. Module này cho phép RAG pipeline chạy hoàn toàn bên trong database, không cần external embedding service. Multi-tenancy bằng multiTenancy flag cũng rất linh hoạt.
Phiên bản Weaviate Cloud (WCD) managed giống Pinecone, nhưng mã nguồn mở hoàn toàn. Bạn có thể tự host bằng Docker, Kubernetes, hoặc dùng weaviate-embedded cho dev local.
Qdrant: Rust engine, hiệu năng cực cao
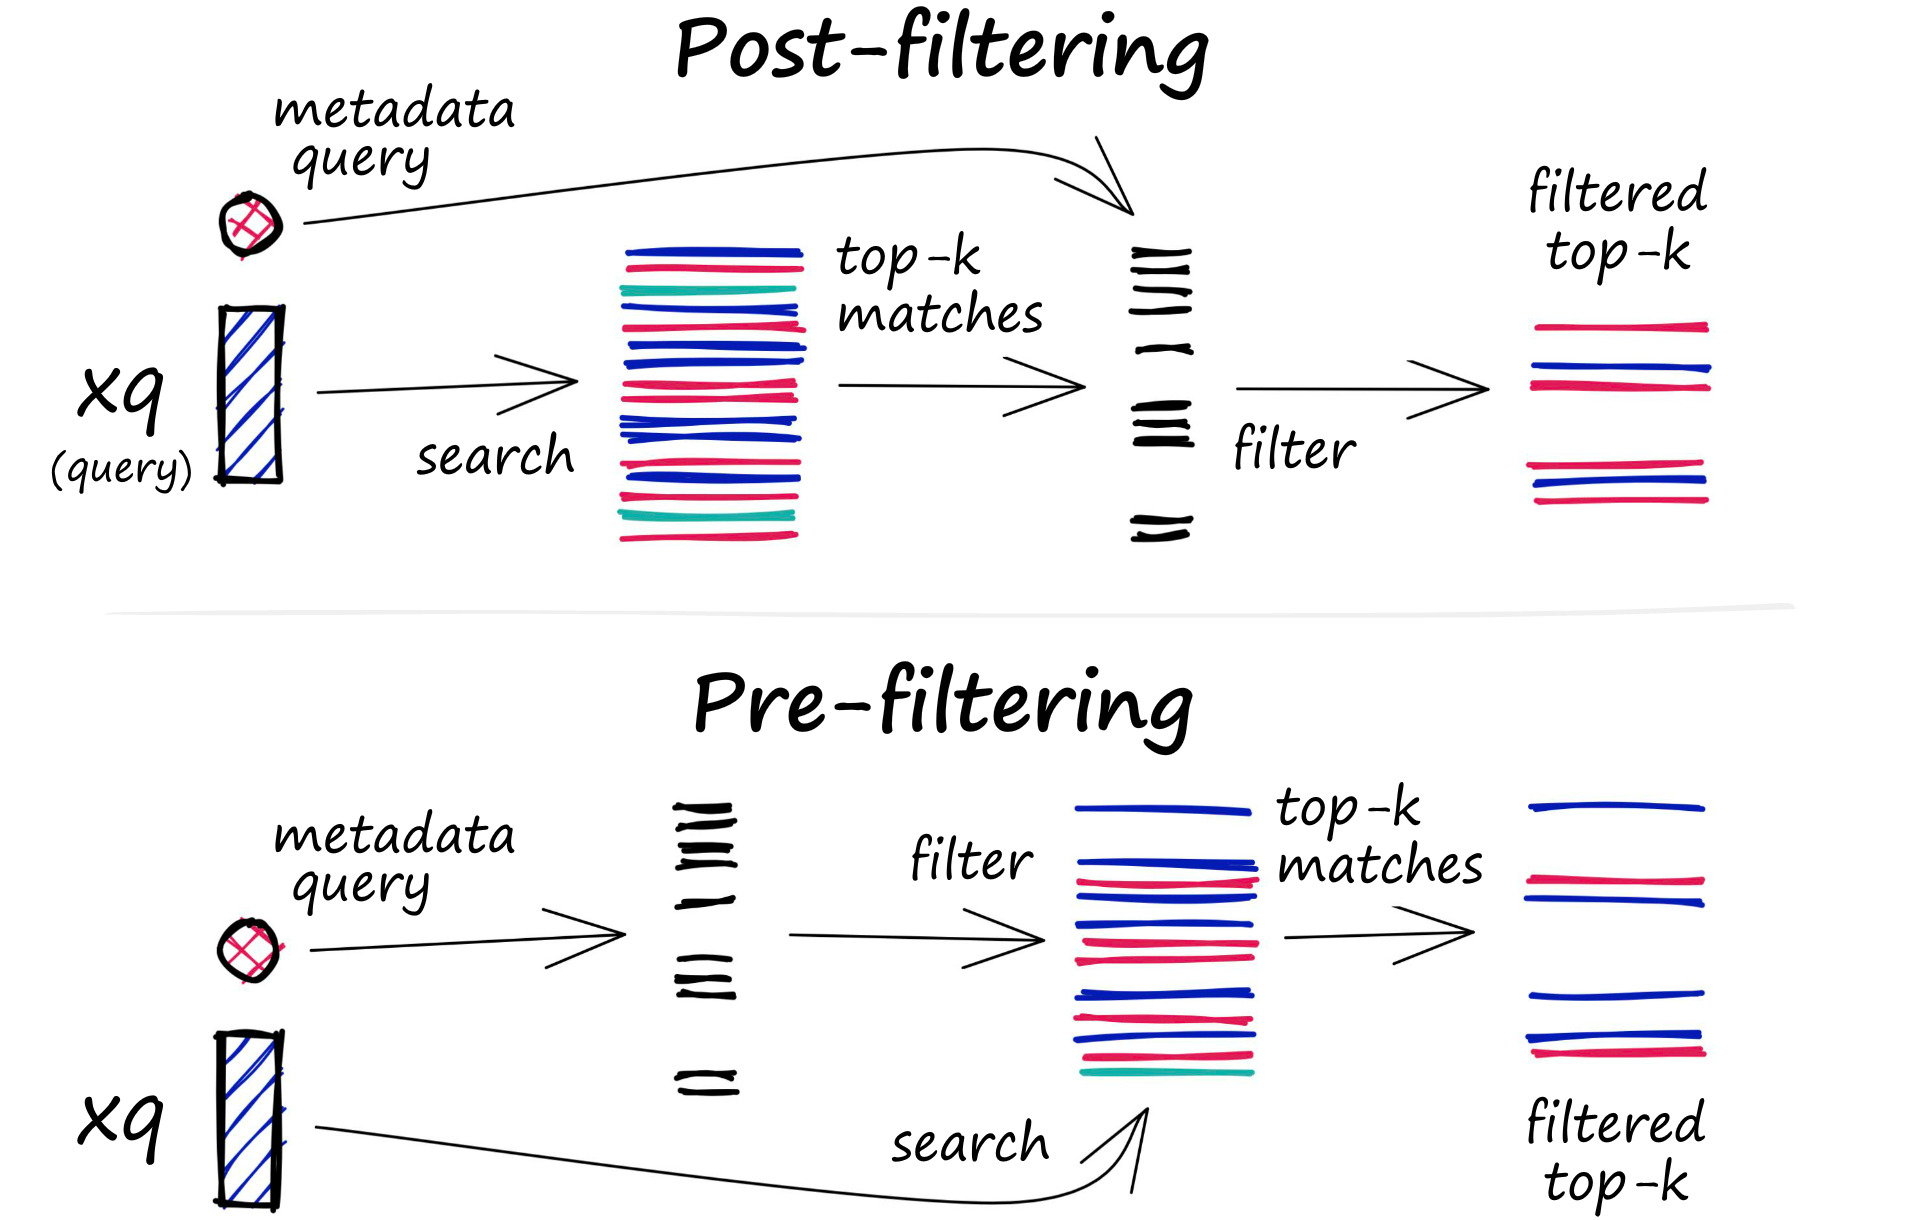
Qdrant viết bằng Rust, tập trung vào tốc độ và hiệu năng. Hỗ trợ HNSW index với nhiều metric: Cosine, Euclid, Dot product. Payload filter (metadata) được tối ưu bằng sparse vector index, cho phép pre-filter và post-filter hiệu quả.
Qdrant có tính năng recommend – tìm kiếm dựa trên positive/negative vectors thay vì query vector thuần. Rất hữu ích cho recommendation system bên trong RAG. Phiên bản Qdrant Cloud cung cấp managed service, trong khi bản self-host hoàn toàn miễn phí.
Performance benchmark của Qdrant thường cao hơn Weaviate và Chroma trên dataset lớn nhờ Rust runtime. Tuy nhiên, ecosystem xung quanh (client libraries, tutorials) vẫn nhỏ hơn Pinecone một chút.
Chroma: Developer-first, nhẹ và đơn giản
Chroma nhắm vào developer muốn chạy vector search nhanh mà không cần config phức tạp. Chỉ vài dòng Python import chromadb là có thể upsert và query. Chroma lưu documents, embeddings, metadata cùng collection.
Điểm đặc biệt là embeddings function. Bạn có thể truyền hàm embedding bất kỳ, Chroma tự động tính và lưu. Collection có thể persist xuống disk bằng chromadb.PersistentClient. Rất tiện cho prototype và notebook.
Nhược điểm: hiệu năng không bằng Qdrant hay Pinecone trên dataset lớn. Tính năng nâng cao như multi-tenancy, role-based access, monitoring còn hạn chế. Phù hợp prototype, nhỏ vừa, không phải production enterprise.
Bảng so sánh tóm tắt
Pinecone
- Pinecone: managed, serverless, đắt, lock-in, scaling tự động, phù hợp production nhanh.
Weaviate
- Weaviate: open-source, hybrid search, GraphQL, vectorizer modules, self-host hoặc cloud.
Qdrant
- Qdrant: Rust, nhanh, payload filter mạnh, recommend API, tốt cho hiệu năng.
Chroma
- Chroma: nhẹ, developer-first, Python native, dễ prototype, hạn chế production lớn.
Nếu cần pricing rõ ràng: Pinecone bản free tier có nhưng nhanh chán; Weaviate và Qdrant self-host miễn phí; Chroma hoàn toàn miễn phí local. Quyết định thường cân bằng giữa thời gian ra mắt và kiểm soát chi phí dài hạn.
Làm sao chọn đúng Vector Database cho RAG?
Trước tiên, đặt câu hỏi về quy mô dữ liệu. Dưới 1 triệu vector, Chroma đủ dùng. Từ 1 triệu đến 100 triệu, Qdrant hoặc Weaviate self-host tiết kiệm hơn Pinecone. Trên 100 triệu, Pinecone serverless hoặc Weaviate Cloud có lợi thế quản lý.
Thứ hai, hybrid search có phải yêu cầu bắt buộc? Weaviate và Qdrant đều hỗ trợ vector + keyword filter tốt. Pinecone có sparse vector nhưng cần config thêm. Chroma hybrid còn đang phát triển.
Thứ ba, ecosystem. Pinecone tích hợp sẵn LangChain, LlamaIndex. Qdrant cũng có client cho cả hai. Weaviate có tích hợp sâu với generative modules. Chroma cũng hỗ trợ LangChain nhưng ít tính năng enterprise hơn.
Cuối cùng, RAG use case cụ thể. Nếu cần agentic retrieval với metadata phức tạp, Qdrant payload filter mạnh nhất. Nếu cần generative RAG trong-database, Weaviate có lợi. Nếu cần triển khai nhanh không quan tâm cost, Pinecone. Nếu cần dev local hoặc learning project, Chroma là lựa chọn tốt nhất.
Không có lựa chọn duy nhất tốt nhất. Hiểu rõ từng database – managed, open-source, hiệu năng, pricing – giúp bạn build RAG application bền vững thay vì phải migrate giữa chừng.