Diffusion model là họ mô hình trí tuệ nhân tạt tạo ra hình ảnh, âm thanh hoặc văn bản bằng cách bắt đầu từ nhiễu ngẫu nhiên rồi lặp đi lặp lại điều nhiễu. Nhờ cách tiếp cận đảo ngược quá trình làm mờ, các hệ thống như Stable Diffusion hay DALL-E tạo được hình ảnh chất lượng cao mà không cần mạng thần kinh phải nhớ toàn bộ phân phối dữ liệu thật.
Diffusion model hoạt động như thế nào
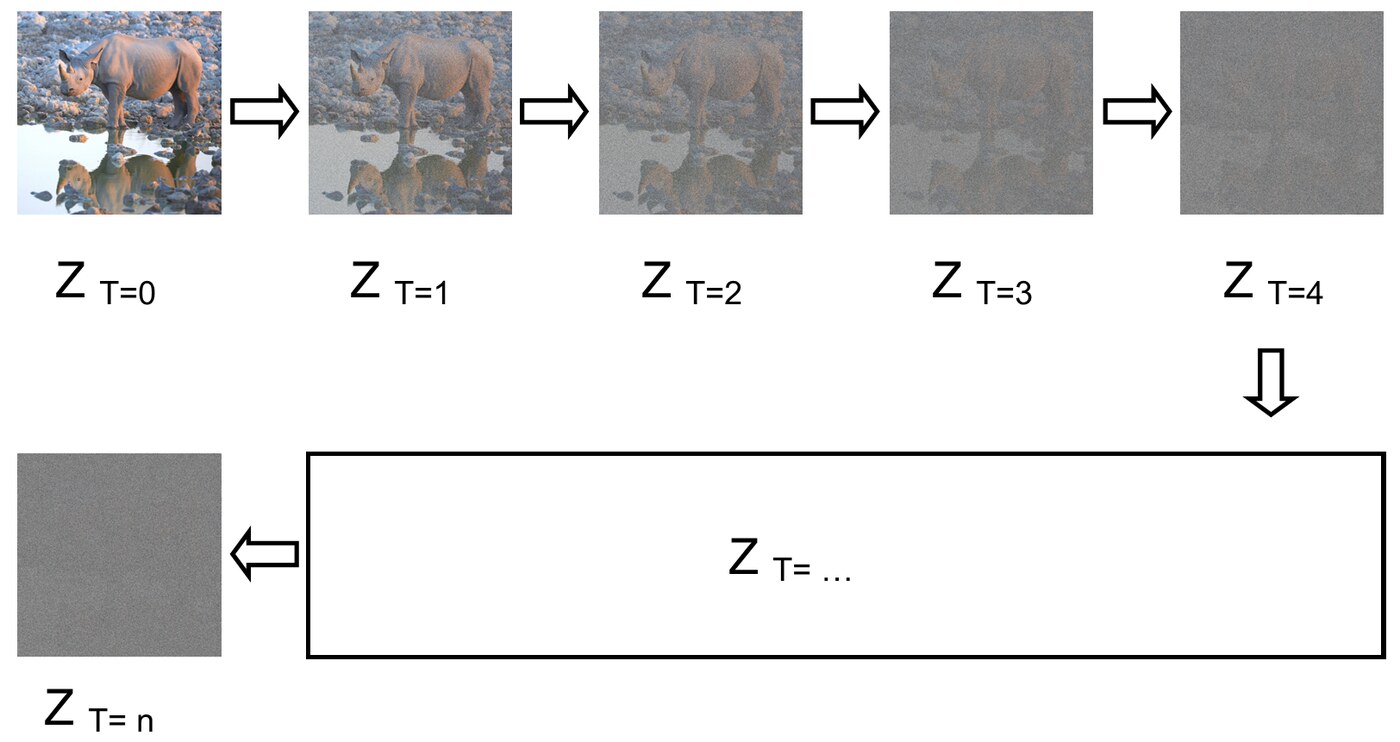
Ý tưởng gốc đến từ vật lý nhiệt động. Mỗi bức ảnh được xem là một điểm trong không gian của tất cả các ảnh có thể có. Tập hợp các ảnh tự nhiên tạo thành một đám mây dữ liệu, và quá trình khuếch tán liên tục thêm nhiễu Gaussian vào từng điểm sẽ khiến đám mây đó loãng dần cho tới khi nó trở nên không phân biệt được với phân phối nhiễu thuần túy.
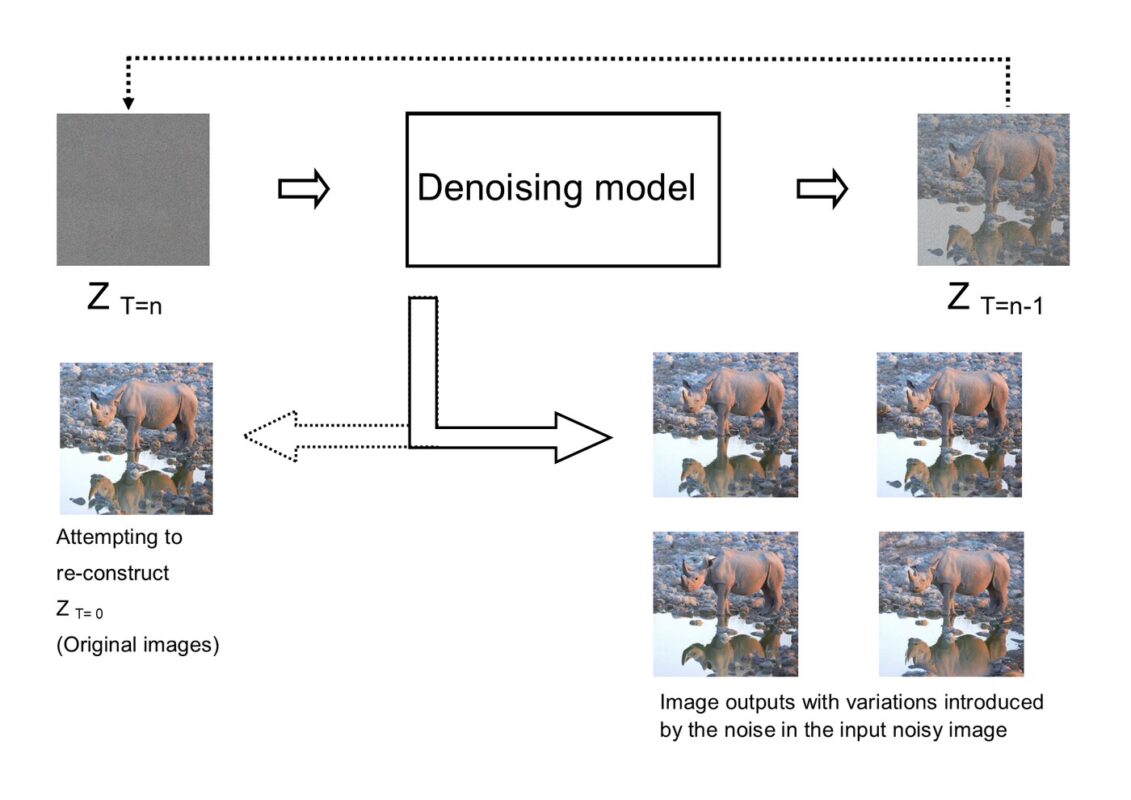
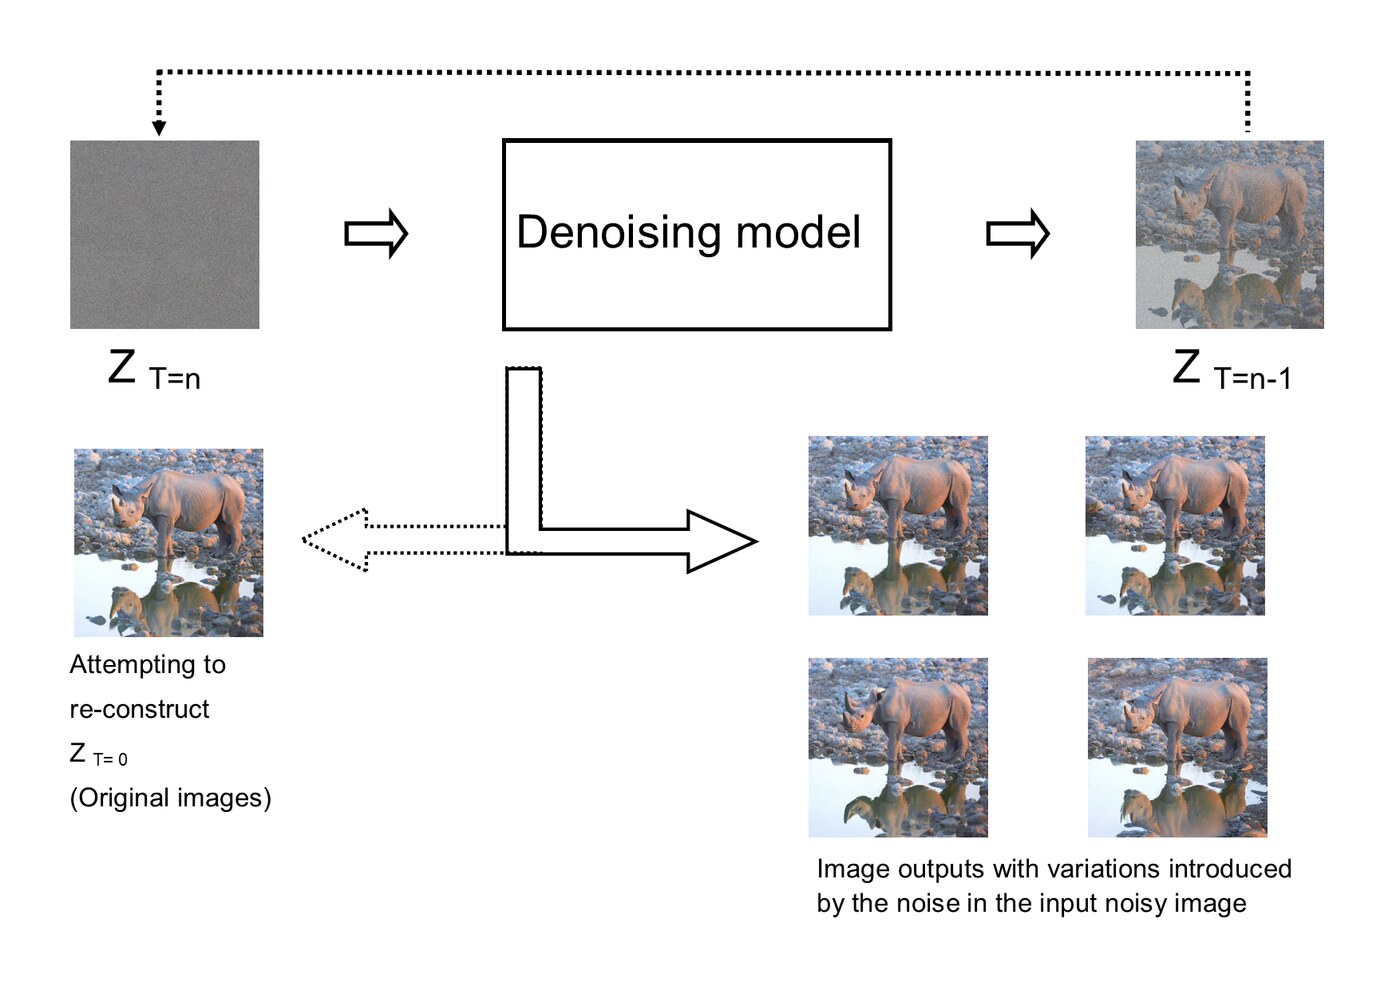
Vì vậy, mô hình học cách đi ngược lại quá trình này. Nó nhận một ảnh đã nhiễu và dự đoán ảnh gốc trông sẽ như thế nào, từ đó loại bỏ một phần nhiễu. Lặp lại hàng trăm bước, ảnh dần sắc nét trở lại. Phần mô hình đảm nhiệm việc loại nhiễu thường được gọi là backbone, và phần lớn các công trình hiện nay dùng kiến trúc U-Net hoặc Transformer cho lớp này.
Tiến trình thuần và tiến trình nghịch
Mô hình khuếch tán xác suất, hay DDPM, được giới thiệu vào năm 2020, đưa cách trên vào một khung hình thức chặt chẽ dựa trên suy luận biến thiên. Tiến trình thuần lấy ảnh gốc rồi liên tục trộn nhiễu theo một lịch trình cố định gồm T bước. Ở mỗi bước, hệ số giữ lại phần tín hiệu và hệ số nhân với nhiễu được chọn sao cho tổng phương sai luôn bằng một. Hệ quả là biến thể cuối cùng có phân phối gần với nhiễu Gaussian đơn vị.
Tiến trình nghịch là phần cần học: một mạng nơ-ron nhận ảnh nhiễu ở bước t cùng thông tin về bước đó, rồi xuất ra ảnh nhiễu ở bước t trừ một. Nhờ vậy, quá trình suy luận có thể bắt đầu từ bất kỳ điểm nào trong đám mây nhiễu. Có những cách lấy mẫu tốn hàng nghìn bước, cũng có cách rút xuống còn vài chục bước mà chất lượng gần như không đổi.
Ứng dụng thực tế ngoài ảnh
Ban đầu, khuếch tán được xem là kỹ thuật xử lý ảnh: khử nhiễu, tô màu vùng bị che, nâng độ phân giải. Ngày nay nó xuất hiện trong sinh văn bản, tạo âm thanh và cả trong học tăng cường. Mô hình sinh ảnh phổ biến thường ghép diffusion với bộ mã hóa văn bản và các lớp chú ý chéo, nhờ đó câu lệnh của người dùng mới trở thành điều kiện để tạo ảnh.
So sánh nhanh các hướng sinh ảnh
| Phương pháp | Cơ chế chính | Điểm mạnh | Điểm yếu |
|---|---|---|---|
| GAN | Hai mạng đối kháng | Sinh nhanh | Huấn luyện không ổn định, dễ vỡ cấu trúc |
| Diffusion | Khử nhiễu từng bước | Chất lượng cao, dễ kiểm soát | Chậm hơn khi lấy mẫu |
| Flow matching | Học đường đi của dữ liệu | Ít bước lấy mẫu hơn | Yêu cầu huấn luyện lớn hơn |
Điều kiện cần biết trước khi dùng
- Cần GPU tương đối mạnh nếu tự huấn luyện, vì mỗi vòng lặp phải chạy cả tiến trình thuần lẫn tiến trình nghịch.
- Số bước lấy mẫu quyết định trực tiếp tới tốc độ và độ mịn của kết quả, nên tăng bước không phải lúc nào cũng tốt.
- Mô hình được huấn luyện trên tập ảnh có nhãn nên thường tái tạo được bố cục, màu sắc và cả phong cách của dữ liệu gốc.
- Bản quyền dữ liệu huấn luyện vẫn là câu hỏi mở khi dùng thương mại, cần kiểm tra giấy phép của từng nguồn ảnh.
Kiến thức nền tảng về mô hình sinh ảnh nằm ở bài Knowledge Distillation là gì: Nén mô hình AI thông minh, bài viết giải thích cách rút gọn mô hình lớn xuống kích thước nhỏ hơn mà vẫn giữ chất lượng dự đoán. Bạn cũng nên đọc bài tổng quan về diffusion model trên Wikipedia để có định nghĩa học thuật đầy đủ kèm công thức gốc.
Kết luận
Diffusion model đổi cách chúng ta nhìn về bài toán sinh nội dung: thay vì ghi nhớ phân phối dữ liệu, mô hình học cách hoàn tác một quá trình phá hủy thông tin. Chính nhờ tính ổn định đó, kỹ thuật này nhanh chóng trở thành nền tảng cho phần lớn công cụ tạo ảnh phổ biến hiện nay, và các hướng tối ưu về tốc độ lấy mẫu vẫn là nơi các nhóm nghiên cứu đang tập trung cải tiến.