Kiến trúc Transformer là gì? Nền tảng của mô hình ngôn ngữ hiện đại
Transformer là kiến trúc mạng nơ-ron deep learning được giới thiệu trong bài báo “Attention Is All You Need” năm 2017, thay đổi căn bản cách các mô hình xử lý chuỗi dữ liệu. Thay vì dựa vào mạng hồi quy (RNN) hoặc tích chập (CNN), Transformer chỉ sử dụng cơ chế Attention để mô hình hóa quan hệ giữa các vị trí trong chuỗi.
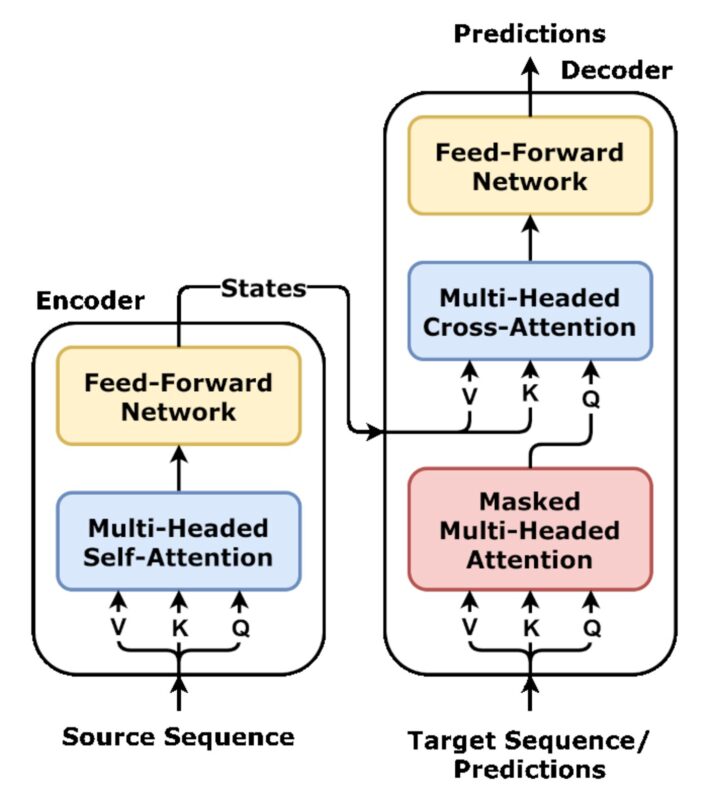
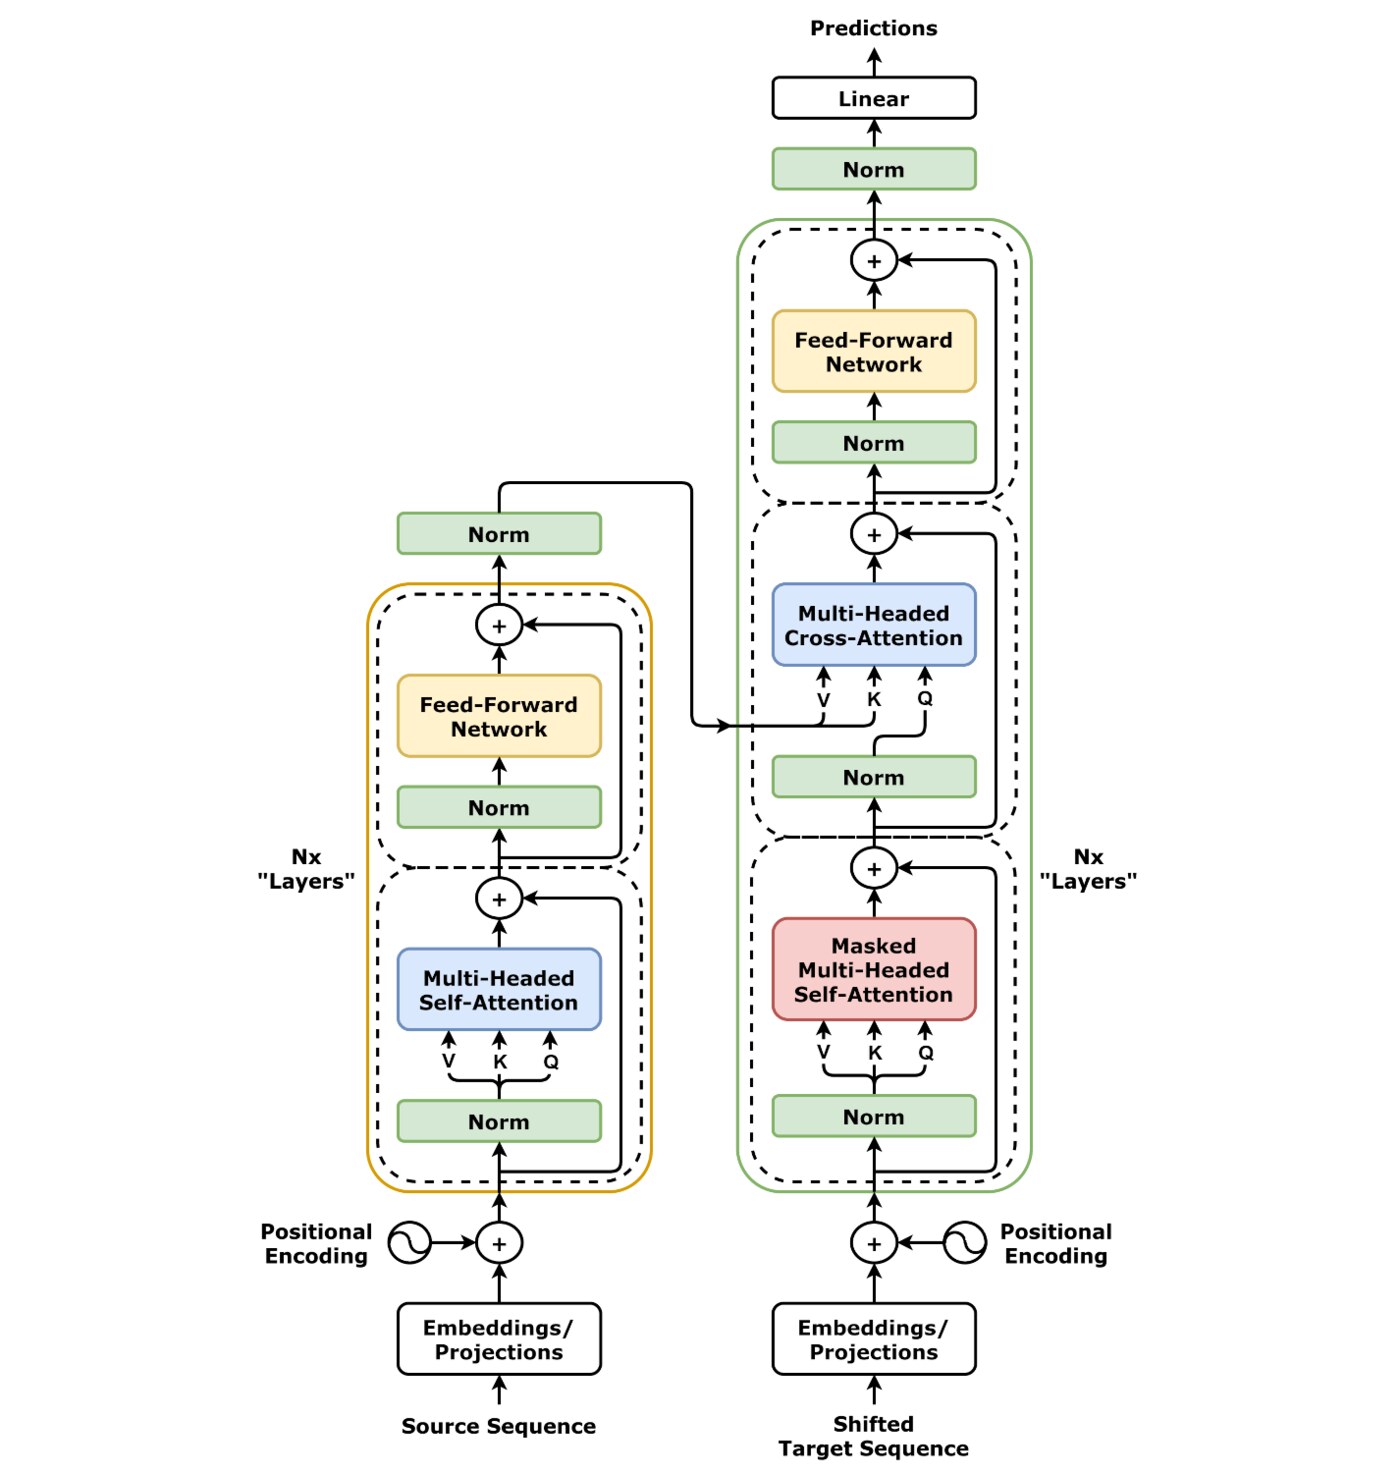
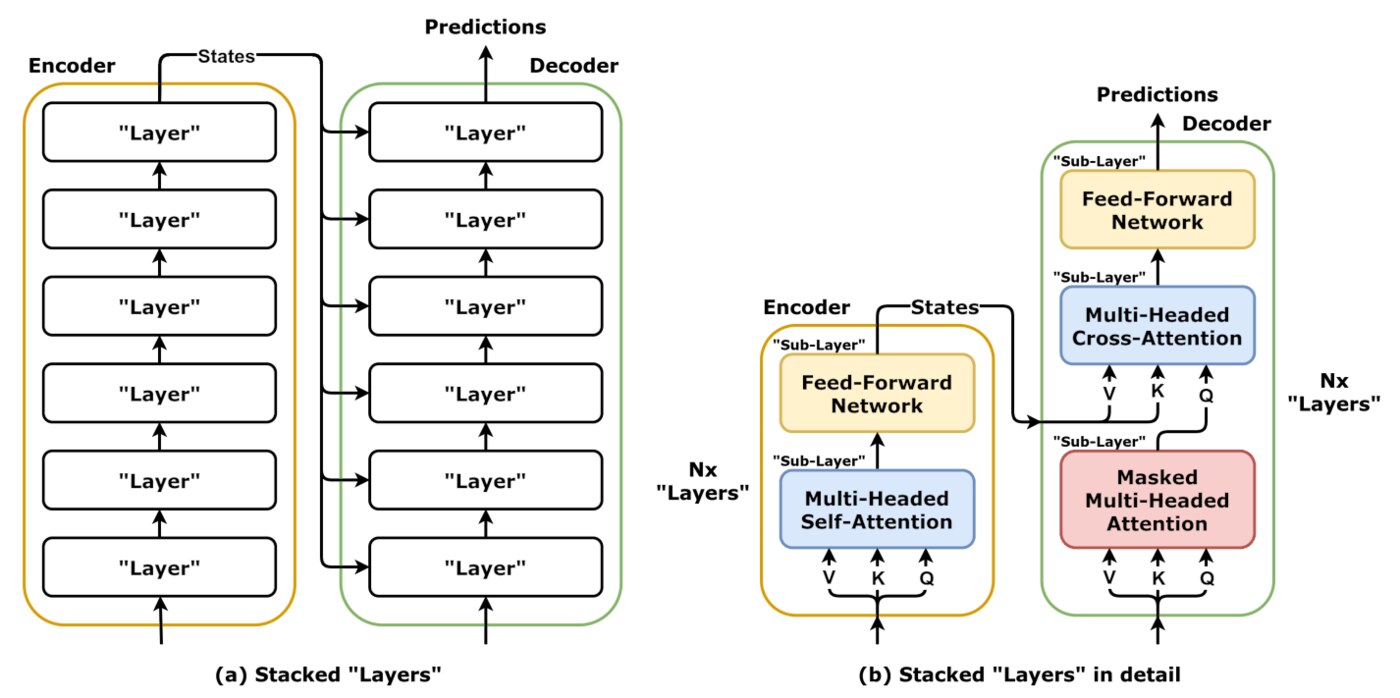
Kiến trúc này gồm một bộ mã hóa (encoder) và một bộ giải mã (decoder), mỗi lớp xếp chồng hai thành phần chính: lớp self-attention và mạng feed-forward. Nhờ bỏ hẳn tính tuần tự, toàn bộ câu đầu vào được xử lý song song, nhờ đó mô hình huấn luyện nhanh hơn và mở rộng quy mô dễ hơn. Bài báo gốc đạt 28,4 BLEU trên bộ dịch WMT 2014 Anh–Đức và 41,8 BLEU trên Anh–Pháp, đều là kết quả tốt nhất thời điểm đó với một mô hình đơn.
Cơ chế Self-Attention hoạt động ra sao
Self-attention biến mỗi token thành ba vector: truy vấn (query), khóa (key) và giá trị (value). Tương tác giữa các token được tính bằng tích phân nhân Q với K, chia cho căn bậc hai của số chiều, rồi đưa qua hàm softmax để thành trọng số. Đầu ra là tổng có trọng số của toàn bộ vector giá trị tương ứng.
Công thức thu gọn của một đầu attention: Attention(Q,K,V) = softmax(QKᵀ / √d_k) · V. Chính phép tích QKᵀ chính là nơi “chú ý” được phân bổ: token nào trong câu liên quan đến token đang xử lý sẽ nhận trọng số cao hơn.
Multi-Head Attention
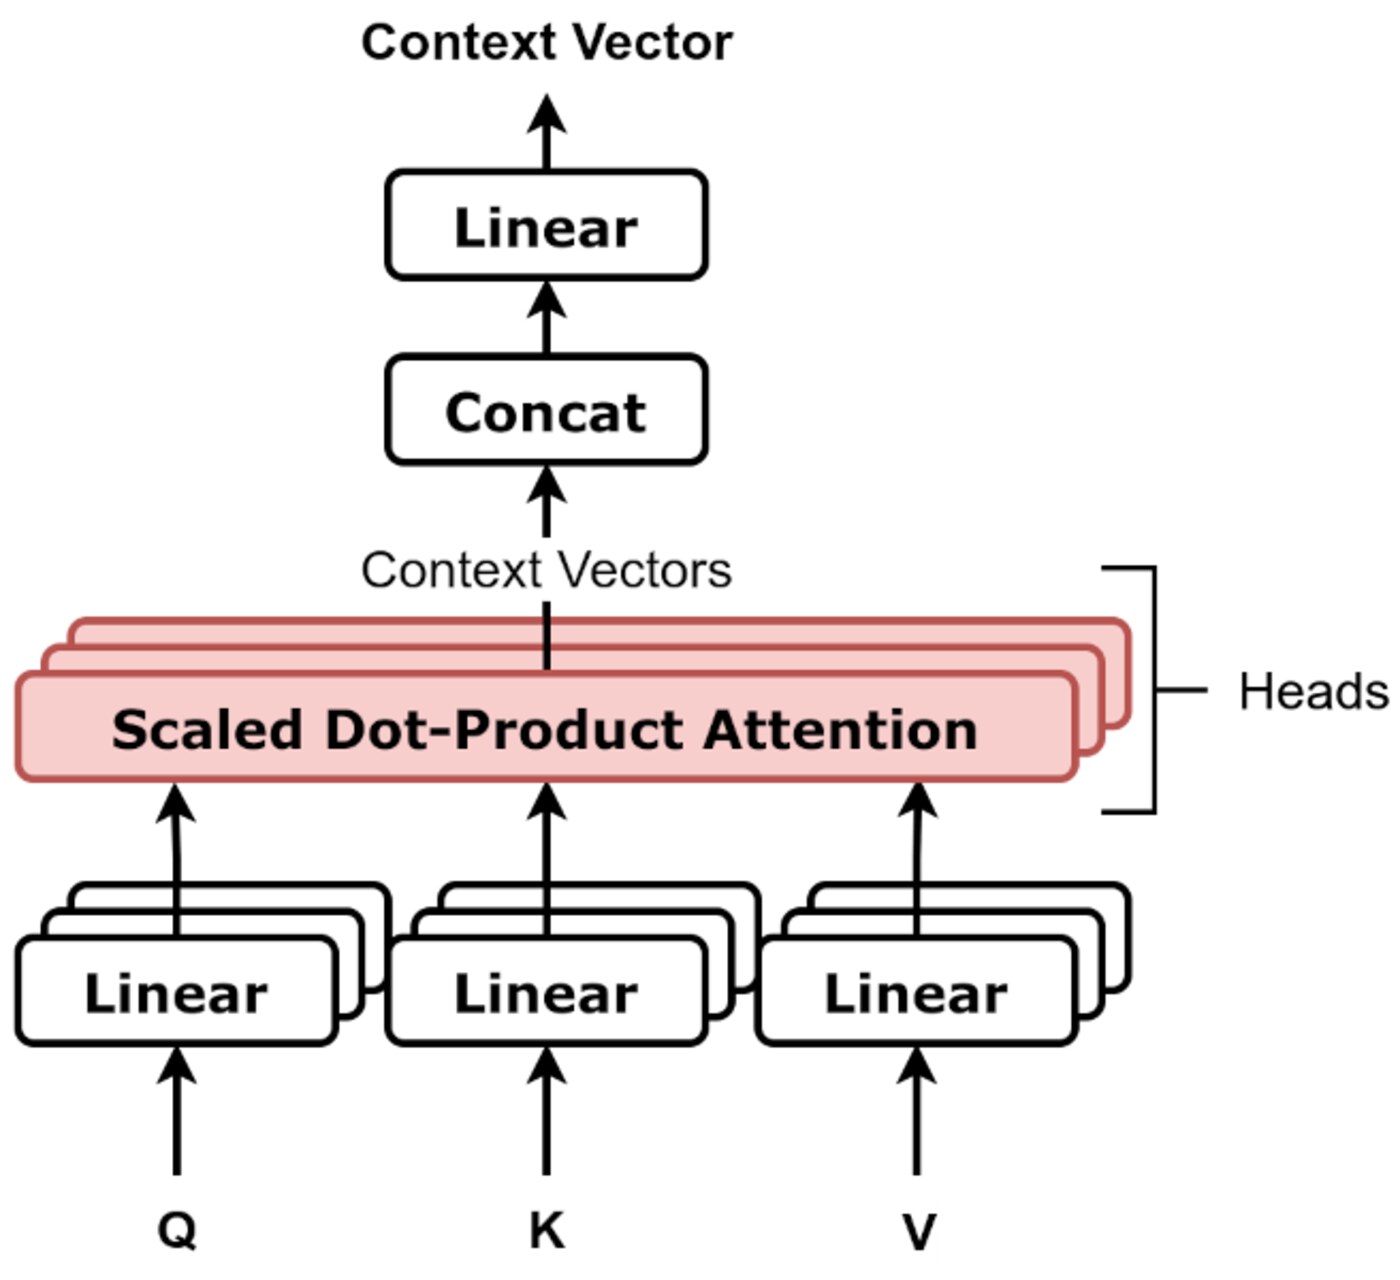
Kiến trúc không dùng một đầu attention duy nhất mà chạy nhiều đầu song song, mỗi đầu chiếu vào một không gian con khác nhau của Q, K, V bằng các ma trận học được khác nhau. Kết quả của các đầu được nối lại rồi chiếu qua một lớp tuyến tính.
Ý tưởng đằng sau đó rất trực quan: các quan hệ ngôn ngữ thường đa dạng. Một đầu có thể tập trung vào các từ giống nhau về nghĩa, một đầu khác theo dõi cấu trúc cú pháp, đầu khác nữa bám theo các từ dừng chức năng. Mỗi đầu học một cách nhìn riêng, rồi ghép lại thành biểu diễn giàu thông tin hơn.
Positional Encoding: bổ sung thông tin thứ tự
Self-attention bản chất là thao tác không phụ thuộc vị trí — hoán đổi thứ tự các token vẫn cho ra cùng một tập phép tính. Vì vậy Transformer phải chủ động thêm thông tin vị trí. Bài báo gốc dùng hàm sin và cos ở nhiều tần số khác nhau, cộng trực tiếp vào vector đầu vào của từng token.
Ý tưởng là khoảng cách giữa token thứ nhất và thứ hai luôn bằng nhau với khoảng cách giữa token thứ 5 và thứ 6, nên tần số sin phải thay đổi theo khoảng cách đó. Ngày nay nhiều mô hình dùng RoPE (rotary positional embedding) hoặc ALiBi, với các phép biến đổi được học hoặc suy ra từ khoảng cách tương đối giữa các vị trí.
Encoder, Decoder và các biến thể
Kiến trúc gốc là mô hình encoder-decoder đầy đủ. Chỉ dùng phần encoder tạo ra BERT, phù hợp với nhiệm vụ hiểu ngôn ngữ như phân loại, trích xuất thực thể. Chỉ dùng phần decoder tạo ra các mô hình sinh văn bản như GPT. Ngày nay phần lớn mô hình ngôn ngữ lớn đều thuộc nhóm decoder-only, nhờ cách sinh văn bản tự hồi quy tự nhiên và dễ mở rộng.
Vì sao Transformer thắng RNN và CNN
- Song song hóa toàn bộ: RNN phải xử lý từng bước một, còn Transformer tính toàn bộ chuỗi cùng lúc trên GPU.
- Đường dẫn thông tin ngắn: khoảng cách giữa hai token bất kỳ chỉ qua một phép attention, không phụ thuộc vị trí.
- Dễ mở rộng: tăng số lớp và số chiều tăng năng lực một cách đều đặn, nền tảng cho các mô hình hàng trăm tỉ tham số.
- Tự chú ý tới toàn cục: cơ chế attention cho phép mô hình tự quyết định vị trí nào quan trọng, thay vì phải học trọng số cố định như CNN.
Đổi lại, Transformer có chi phí bậc hai theo độ dài chuỗi, vì ma trận QKᵀ có kích thước vuông. Với văn bản rất dài, các biến thể như FlashAttention, sparse attention hay sliding window được dùng để giảm chi phí tính toán và bộ nhớ.
Ứng dụng thực tế
Transformer không chỉ dùng cho xử lý ngôn ngữ tự nhiên. Cùng một nguyên lý attention được áp dụng rộng rãi trong thị giác máy tính (Vision Transformer), âm thanh, và mô hình đa phương thức. Trong tìm kiếm, nó là xương sống của hệ thống dự án hóa truy vấn. Trong sinh học, các biến thể được dùng để dự đoán cấu trúc protein.
Tóm tắt
Kiến trúc Transformer đã thay đổi ngành xử lý ngôn ngữ nhờ ba quyết định thiết kế: bỏ truy tuần tự, đặt self-attention làm trung tâm, và thêm thông tin vị trí bằng encoding. Nhờ đó, mọi mô hình ngôn ngữ lớn ngày nay đều dùng Transformer làm nền tảng, và mọi biến thể cải tiến — từ RoPE đến FlashAttention — đều xoay quanh việc làm cho lõi attention rẻ hơn và mở rộng được xa hơn.