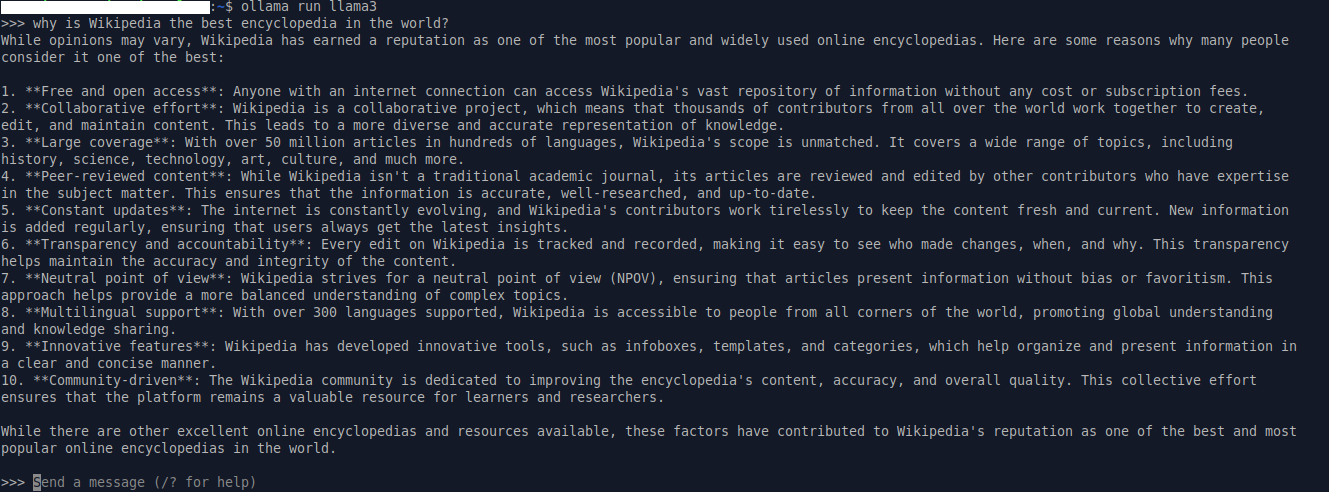
Ollama là công cụ mã nguồn mở giúp chạy các mô hình ngôn ngữ lớn (LLM) trên máy local một cách đơn giản, không cần cấu hình server hay GPU cluster phức tạp. Với Ollama, bạn có thể chạy Llama 3, Mistral, Gemma, Phi-3, và hàng trăm mô hình khác chỉ với một dòng lệnh, hoàn toàn miễn phí và riêng tư.
Vì sao chạy LLM local?
Chạy LLM qua API của OpenAI, Anthropic, hoặc Google có nhiều ưu điểm nhưng cũng gây ra vấn đề lớn: chi phí_API liên tục tăng, dữ liệu gửi lên server nước ngoài, phụ thuộc internet, và giới hạn token per request. Ollama giải quyết mọi vấn đề này bằng cách đưa toàn bộ inference về máy local.
- Bảo mật dữ liệu: Không có thông tin nào rời khỏi máy. Phù hợp cho doanh nghiệp xử lý dữ liệu nhạy cảm, y tế, tài chính.
- Không giới hạn token: Gọi LLM bao nhiêu lần tùy ý, không lo quota hay bill surprise.
- Hoạt động offline: Chạy được cả khi không có internet, lý tưởng cho du lịch hoặc vùng xa.
- Chấp nhận được: Với GPU RTX 3060 12GB hoặc Apple M1 16GB, mô hình 7B parameters chạy ổn định ở 15-25 tokens/giây.
Cài đặt Ollama
Quá trình cài đặt cực kỳ đơn giản trên mọi nền tảng:
| Hệ điều hành | Lệnh cài đặt |
|---|---|
| macOS | brew install ollama hoặc tải từ ollama.com/download |
| Linux | curl -fsSL https://ollama.com/install.sh | sh |
| Windows | Tải installer từ ollama.com/download |
Sau cài đặt, chạy lệnh test:
$ ollama --version
ollama version 0.6.x

# Kéo và chạy mô hình lần đầu
$ ollama run llama3.1:8b
>>> Xin chào, bạn có thể giúp tôi viết code Python không?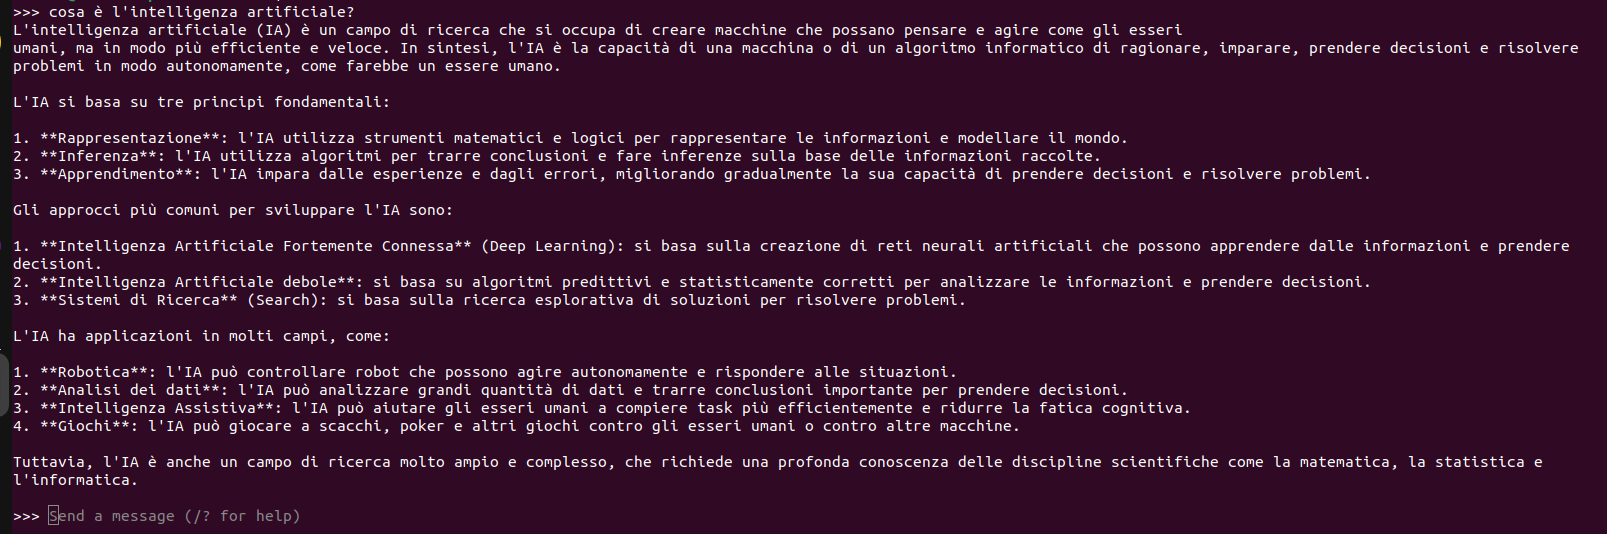
Các mô hình phổ biến trên Ollama
Ollama hỗ trợ hàng trăm mô hình từ nhiều nhà phát triển. Dưới đây là những lựa chọn tốt nhất theo mục đích sử dụng:
| Mô hình | Kích thước | RAM yêu cầu | Điểm mạnh |
|---|---|---|---|
| llama3.1:8b | 4.7 GB | 8 GB | Cân bằng tốc độ-chất lượng, hỗ trợ 128K context |
| mistral:7b | 4.1 GB | 8 GB | Coding, instruction following, GPQA |
| gemma2:9b | 5.4 GB | 10 GB | Google research, multilingual, reasoning |
| phi3:mini | 2.2 GB | 4 GB | Nhẹ nhất, chạy được trên laptop 4GB RAM |
| qwen2.5:7b | 4.4 GB | 8 GB | Multilingual, coding, toán học |
| codellama:13b | 7.4 GB | 12 GB | Code generation chuyên biệt |
Mô hình(lớn hơn) thường cho kết quả tốt hơn, nhưng cần nhiều RAM/VRAM hơn. Quy tắc đơn giản: RAM khả dụng (GB) × 2 ≈ kích thước mô hình tối đa (GB).
Sử dụng API endpoint
Ollama chạy server local ở localhost:11434, tương thích OpenAI API format. Bạn có thể dùng nó với bất kỳ tool nào hỗ trợ OpenAI API:
# REST API trực tiếp
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "Giải thích về Docker container",
  "stream": false
}'

# Chat API (tương thích OpenAI format)
curl http://localhost:11434/v1/chat/completions -d '{
  "model": "llama3.1:8b",
  "messages": [{"role": "user", "content": "Hello"}]
}'
Với Python, dùng thư viện openai hoặc requests:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"  # không cần key thực
)

response = client.chat.completions.create(
    model="llama3.1:8b",
    messages=[{"role": "user", "content": "Viết hàm Python sort"}]
)
print(response.choices[0].message.content)
Tích hợp với IDE và công cụ phát triển
Ollama tích hợp tốt với nhiều công cụ phổ biến:
- Continue (VS Code/JetBrains extension): Gợi ý code bằng LLM local, tương tự GitHub Copilot nhưng hoàn toàn miễn phí.
- LM Studio: Giao diện desktop đẹp, drag-and-drop model, built-in chat UI, hỗ trợ RAG.
- Open WebUI: Chat interface giống ChatGPT nhưng chạy trên máy local qua Docker.
- Cursor IDE: Hỗ trợ kết nối Ollama backend cho AI coding suggestions.
- Obsidian + Smart Connections: Tích hợp LLM local vào hệ thống ghi chú.
Thực hành: Xây dựng chatbot local với Python
Ví dụ đơn giản tạo một chatbot chạy hoàn toàn offline:
import requests

API_URL = "http://localhost:11434/api/chat"

def chat_with_local_llm(messages, model="llama3.1:8b"):
    response = requests.post(API_URL, json={
        "model": model,
        "messages": messages,
        "stream": False
    })
    return response.json()["message"]["content"]

# Vòng lặp chat
history = []
print("Chatbot local (gõ 'exit' để thoát)")
while True:
    user_input = input("Bạn: ")
    if user_input.lower() == "exit":
        break
    history.append({"role": "user", "content": user_input})
    reply = chat_with_local_llm(history)
    history.append({"role": "assistant", "content": reply})
    print(f"Bot: {reply}")
Tối ưu hiệu suất trên máy yếu
Nếu máy chỉ có 8GB RAM hoặc không có GPU NVIDIA:
- Chọn mô hình nhỏ:
phi3:mini(2.2GB),qwen2.5:3b(2GB) chạy mượt trên laptop 8GB. - Sử dụng(quantization): Mô hình Q4_K_M (4-bit) nhỏ hơn 50% so với F16 nhưng chất lượng giảm không đáng kể.
- macOS Apple Silicon: Metal API hỗ trợ inference tự động, M1 Pro/Max chạy 14B models ổn định.
- Linux AMD: Ollama hỗ trợ ROCm cho GPU AMD, nhưng cần cài đặt driver đúng phiên bản.
Kết luận
Ollama làm cho AI local trở nên dễ tiếp cận hơn bao giờ hết. Chỉ cần một máy tính phổ thông, bạn đã có thể chạy mô hình AI mạnh mẽ cho coding, viết content, phân tích dữ liệu — hoàn toàn miễn phí và bảo mật. Bắt đầu với ollama run llama3.1:8b, sau đó khám phá các mô hình khác phù hợp nhu cầu.
Tham khảo thêm: Ollama Model Library | Ollama GitHub Repository | Open WebUI Documentation