Retrieval-Augmented Generation (RAG) là kiến trúc dùng dữ liệu truy xuất từ nguồn bên ngoài để bổ sung kiến thức cho mô hình ngôn ngữ lớn (LLM) trước khi sinh câu trả lời. RAG giải quyết trực tiếp ba vấn đề lớn của LLM thuần: mốc cắt kiến thức cũ, thiếu dữ liệu nội bộ của doanh nghiệp, và khả năng bịa đặt thông tin (hallucination) khi không có nguồn để đối chiếu.
Bài viết này giải thích RAG hoạt động theo bốn bước cốt lõi, cách xây vector database, vì sao hybrid search tốt hơn semantic search thuần, và lý do RAG rẻ hơn nhiều so với fine-tuning mô hình riêng.
Vì sao LLM thuần chưa đủ dùng?
Mô hình ngôn ngữ lớn được huấn luyện trên tập dữ liệu đóng băng tại một thời điểm nhất định. Sau khi huấn luyện, dữ liệu đó không thay đổi nữa, tạo ra một khoảng trống kiến thức. Hỏi mô hình về tin tức tuần trước, hay tính năng mới trên dòng điện thoại vừa ra mắt, bạn thường nhận được câu trả lời nghe rất tự tin nhưng hoàn toàn sai.
Ngoài ra, mô hình tổng quát thiếu chiều sâu trong lĩnh vực chuyên ngành. Dữ liệu y tế về bệnh hiếm hoặc liệu pháp tiên tiến có thể tồn tại trên web nhưng xuất hiện quá ít để huấn luyện đúng cách, đòi hỏi cả chuyên gia để diễn giải ngữ cảnh. Với dữ liệu nội bộ của công ty thì đơn giản hơn: dữ liệu đó không công khai, và không thể đưa vào tập huấn luyện của mô hình dùng chung vì lý do bảo mật.
Điểm nguy hiểm nhất là mô hình không phân biệt được điều mình biết với điều mình không biết. Nó luôn sinh ra thứ gì đó, kèm giọng điệu chắc chắn. Trong y tế, một báo cáo sai nhưng thuyết phục có thể dẫn tới điều trị nguy hiểm hoặc không điều trị. RAG ra đời để thêm một lớp bằng chứng vào giữa câu hỏi và câu trả lời.
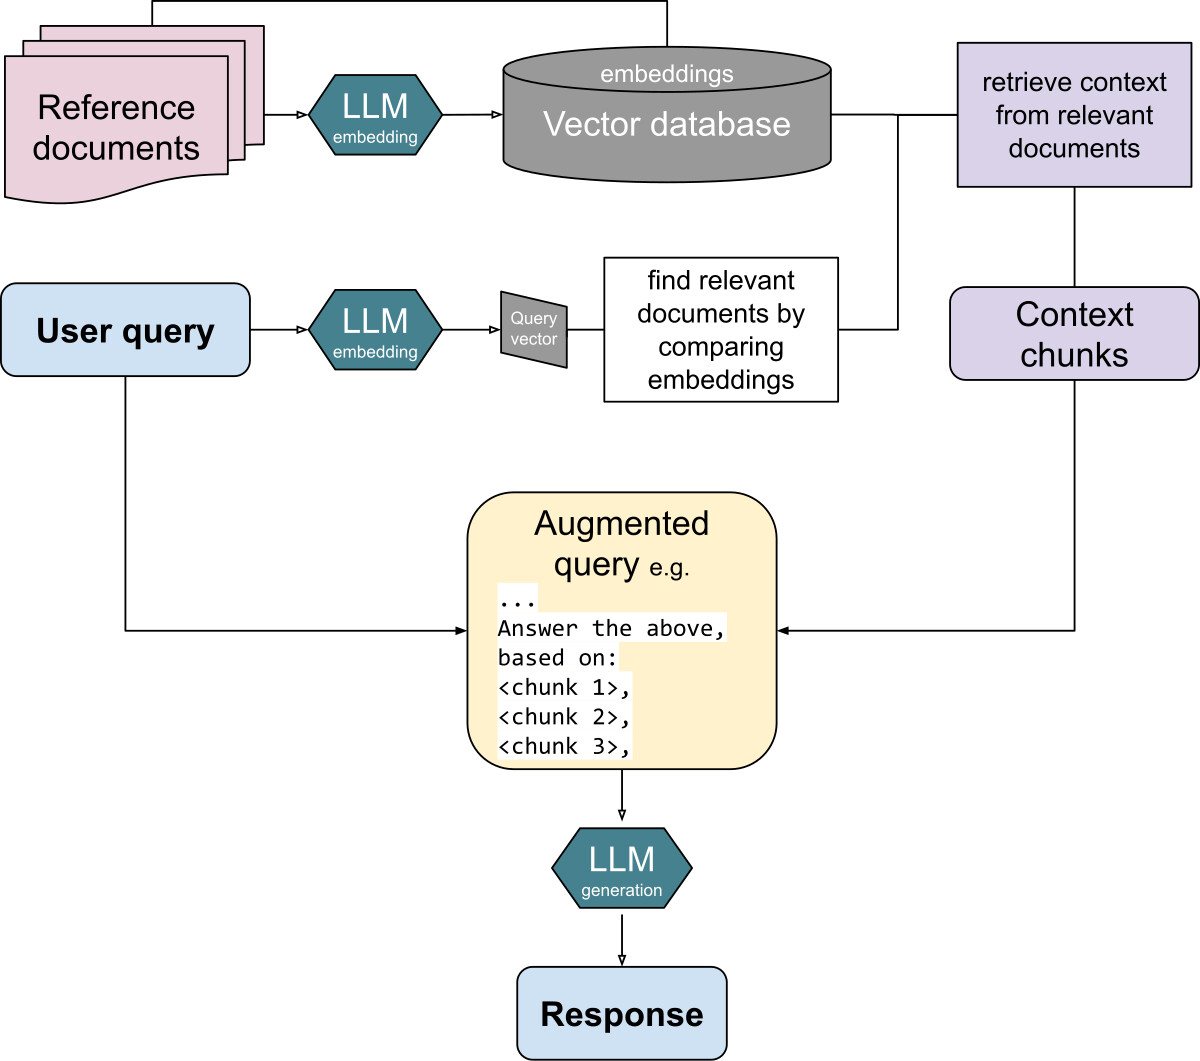
Kiến trúc RAG: bốn bước cốt lõi
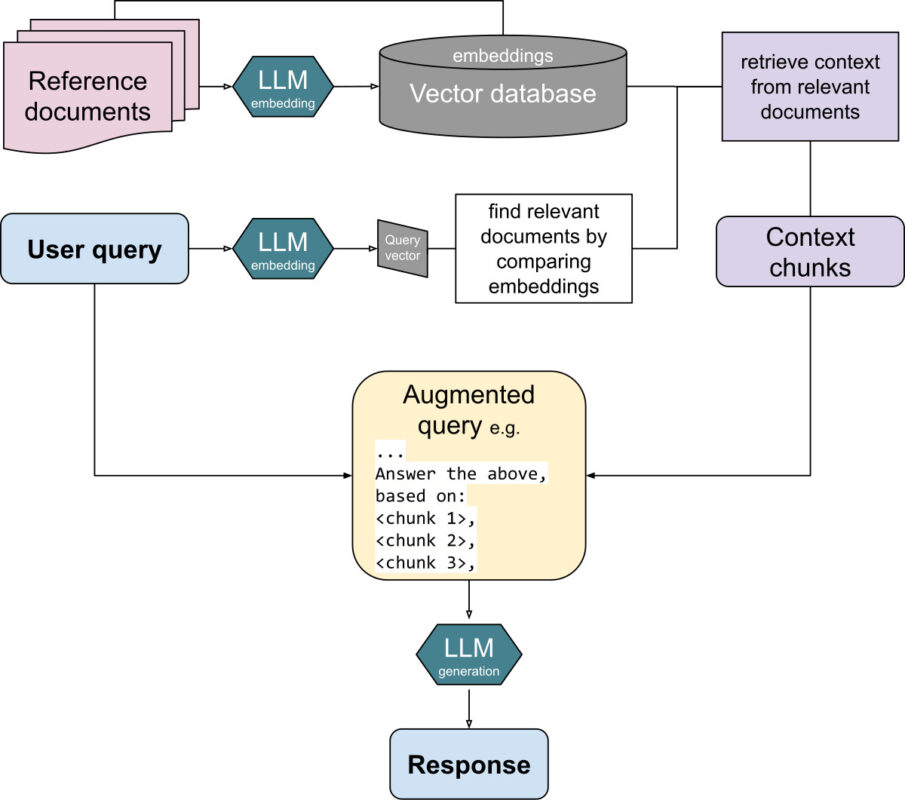
RAG chia quy trình thành bốn giai đoạn rõ ràng, mỗi giai đoạn có thể tối ưu độc lập:
1. Ingestion (Nạp dữ liệu)
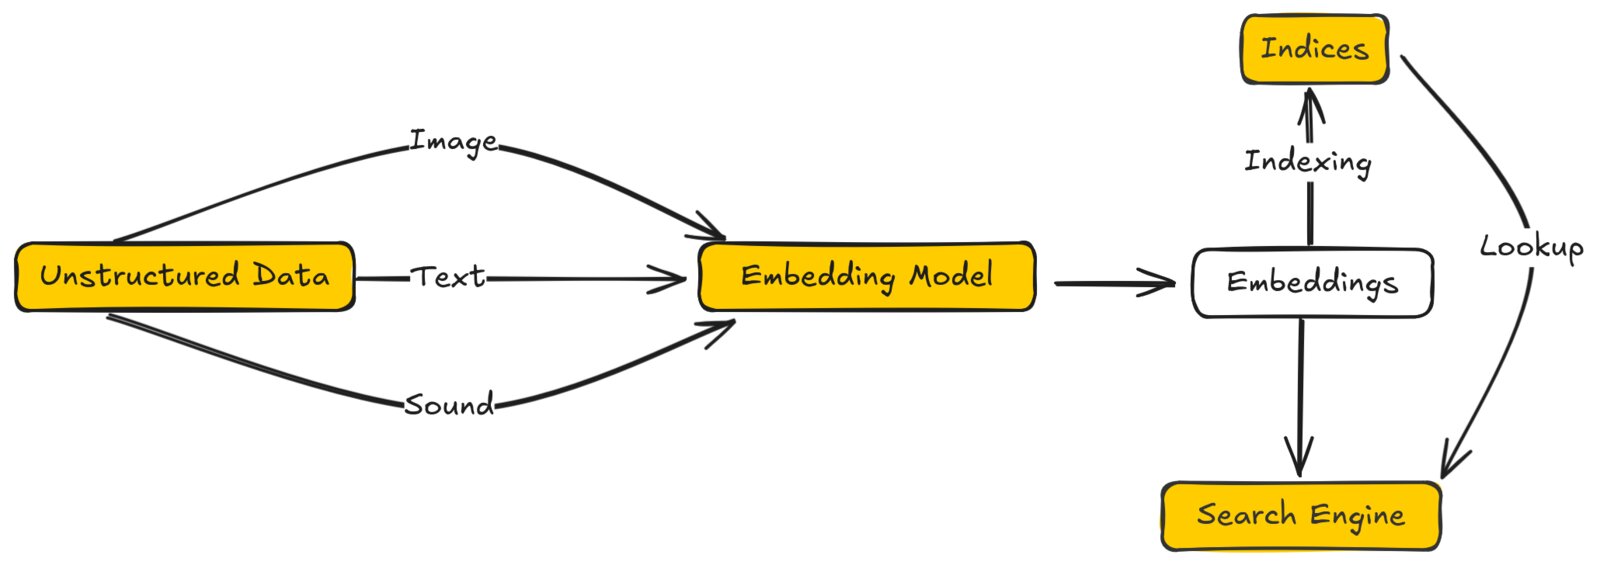
Dữ liệu thô từ PDF, email, wiki nội bộ hay cơ sở dữ liệu được làm sạch rồi chia nhỏ thành các đoạn (chunk). Mỗi đoạn đưa qua một mô hình embedding để biến thành vector biểu diễn ý nghĩa, rồi nạp vào vector database. Bước này thường chạy ngoại tuyến, tách biệt từ luồng người dùng, trừ khi chỉ số cần cập nhật theo thời gian thực.
2. Retrieval (Truy xuất)
Câu hỏi của người dùng cũng được embed thành vector, rồi so khớp với các vector đã lưu để tìm đoạn nội dung liên quan. Semantic search hiểu được ý nghĩa, nên truy vấn “cách hoàn tiền” vẫn khớp với đoạn nói về “quy trình rút tiền”.
3. Augmentation (Bổ sung)
Các đoạn truy xuất được ghép vào prompt cùng câu hỏi, đóng vai trò ngữ cảnh để mô hình có căn cứ trả lời. Đây là bước quyết định chất lượng, vì mô hình chỉ sinh căn cứ trên những gì được đưa vào.
4. Generation (Sinh văn bản)
LLM sinh câu trả lời dựa trên ngữ cảnh đó, thường kèm trích dẫn nguồn để người dùng tự kiểm chứng.
Chunking: khâu quyết định chất lượng
Chunking quá lớn thì mỗi vector chứa quá nhiều chủ đề không liên quan, khiến mô hình bị nhiễu. Chunking quá nhỏ thì câu mất ngữ cảnh, đoạn lấy ra không đủ ý để trả lời. Hai chiến lược phổ biến:
- Fixed-size chunking: chia theo số ký tự cố định, chẳng hạn 500 ký tự với chồng lấn 50 ký tự. Đơn giản, dễ triển khai, phù hợp văn bản đồng nhất như tin tức hay log.
- Semantic chunking: dùng embedding để tìm các điểm ranh giới nội dung rồi cắt tại đó, giữ câu đầy đủ. Tốn kém hơn nhưng kết quả truy xuất tốt hơn với tài liệu dài có cấu trúc rõ.
Thực tế nhiều đội dùng cả hai: semantic chunking cho tài liệu, fixed-size kèm chồng lấn cho dữ liệu không chuẩn hoá.
Hybrid search: vì sao vector thuần là chưa đủ
Semantic search bỏ lỡ những truy vấn chứa mã định danh, mã sản phẩm, tên biến hoặc thuật ngữ hiếm. Ví dụ hỏi “lỗi ERR_4031 trong module billing” sẽ không tìm được gì vì embedding không giữ nguyên chuỗi ký tự đó. Hybrid search kết hợp vector thưa (lexical, so khớp từ khoá) với vector dày (semantic), rồi rerank lại kết quả bằng một mô hình chấm điểm.
Trong thực tế, hybrid search cho độ chính xác cao hơn hẳn vector thuần, đặc biệt với kho tài liệu kỹ thuật nơi mã lỗi và tên hàm xuất hiện nhiều. Chi phí thêm chỉ là một bước truy xuất nữa và mô hình rerank.
RAG có rẻ hơn fine-tuning không?
Rõ ràng là rẻ hơn, và rẻ hơn nhiều. So sánh ba hướng xử lý tri thức:
| Hướng | Chi phí ban đầu | Cập nhật kiến thức | Trích dẫn nguồn |
|---|---|---|---|
| Prompt dài kèm tài liệu | Thấp | Không giới hạn | Không |
| Fine-tuning | Cao (dữ liệu, GPU, thời gian huấn luyện) | Cần huấn luyện lại | Không |
| RAG | Thấp (chỉ làm chỉ mục) | Cập nhật index là xong | Có |
Điểm mấu chốt: càng gửi nhiều token vào context, chi phí mỗi lượt gọi LLM càng cao. RAG chỉ đưa vào đúng đoạn liên quan, nên chi phí suy giảm ngược với chất lượng trả lời.
RAG trong kiến trúc AI agent
Phiên bản RAG cổ điển là một lượt truy xuất rồi sinh luôn. Khi có agent, các bước này trở thành phép toán của agent: nó tự viết lại câu hỏi cho tốt, gọi thêm công cụ truy xuất, đánh giá ngữ cảnh có thực sự liên quan không, dùng suy luận để quyết định tin hay bỏ tin trước khi đưa vào prompt cuối. Nhờ đó agent có thể lặp lại truy xuất nhiều vòng thay vì chỉ một lần.
Muốn tìm hiểu sâu hơn phần cơ bản, bạn có thể đọc bài giới thiệu chi tiết tại Pinecone: Retrieval-Augmented Generation. Bài bốn bước thành phần RAG thực nghiệm trong các kho vector như Pinecone, Qdrant hay ChromaDB đều dùng chung nguyên lý trên.
Đánh giá hệ thống RAG thế nào?
Không có bộ câu hỏi mẫu và câu trả lời kỳ vọng thì không biết hệ thống có hoạt động không. Bộ đánh giá đó gọi là ground truth evaluation, và nó phải được duy trì liên tục, không phải làm một lần lúc ra mắt. Khi RAG trả lời sai, bạn cần biết lỗi nằm ở khâu truy xuất, chunking, embedding hay prompt. Ba chỉ số thường theo dõi:
- Recall@K: đoạn cần thiết có nằm trong K kết quả truy xuất đầu không.
- Context precision: bao nhiêu phần trăm ngữ cảnh đưa vào thực sự liên quan.
- Answer faithfulness: câu trả lời có bám sát ngữ cảnh hay tự bịa thêm.
Nếu recall thấp thì lỗi ở chunking hoặc embedding. Nếu recall cao nhưng câu trả lời vẫn sai thì lỗi ở augmentation hoặc bản thân mô hình.
Lỗi thường gặp khi triển khai RAG
- Bỏ qua bước đánh giá: không có ground truth thì mọi tối ưu đều là đoán mò.
- Chunking không theo ngữ nghĩa: cắt giữa câu, cắt mất tiêu đề điều kiện.
- Không lọc nguồn: dữ liệu cũ hoặc sai trong kho làm câu trả lời sai một cách rất thuyết phục.
- Bỏ qua quyền truy cập: RAG phải tôn trọng phân quyền như truy vấn database, nếu không sẽ rò rỉ dữ liệu nội bộ qua câu trả lời.
- Tin vào vector thuần: bỏ qua lexical search cho mã định danh và thuật ngữ hiếm.
Kết luận
RAG biến một mô hình ngôn ngữ lớn “biết nhiều nhưng không chắc” thành hệ thống “biết đúng những gì bạn cần và trích dẫn được”. Với doanh nghiệp, đó là con đường nhanh nhất để đưa tài liệu nội bộ vào chatbot mà không phải đầu tư huấn luyện mô hình riêng. Với kỹ sư, nó là kiến trúc bắt buộc cho mọi tính năng AI cần dữ liệu cập nhật, trích dẫn nguồn, hoặc tuân thủ quyền truy cập.
Bắt đầu đơn giản: chunking cố định, một vector database, hybrid search, prompt có trích dẫn. Đo lại bằng bộ câu hỏi thật của bạn. Sau đó mới mở rộng thêm rerank, query rewriting hay agent. Bắt đầu sớm, đo sớm, tối ưu sau cũng được.