Zero Trust là gì: Kiến trúc bảo mật không tin tưởng mặc định
Zero Trust (ZT) không chỉ là một cụm từ quảng bá, mà là một kiến trúc bảo mật hoàn toàn thay đổi cách tư duy về phòng vệ mạng doanh…
Xem thêm
io_uring là gì: API I/O bất đồng bộ hiệu năng cao của nhân Linux
io_uring là giao diện lập trình ứng dụng (API) I/O bất đồng bộ dành riêng cho nhân Linux, cho phép tiến trình gửi hàng loạt yêu cầu đọc ghi mà…
Xem thêm
eBPF là gì: Công nghệ lập trình trong nhân Linux hiện đại
eBPF là gì? eBPF (extended Berkeley Packet Filter) là công nghệ cho phép chạy các chương trình nhỏ gọn, an toàn ngay bên trong nhân Linux mà không cần sửa…
Xem thêm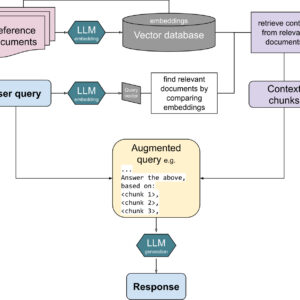
LlamaIndex là gì: Framework RAG kết nối dữ liệu nội bộ với LLM
LlamaIndex là framework mã nguồn mở viết bằng Python (và TypeScript) giúp kết nối dữ liệu riêng tư của doanh nghiệp với các mô hình ngôn ngữ lớn. Nếu bạn…
Xem thêm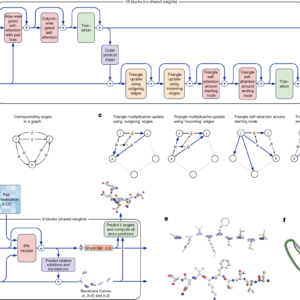
AlphaFold là gì: Trí tuệ nhân tạo dự đoán cấu trúc protein
AlphaFold là gì: Cách AI thay đổi sinh học cấu trúc AlphaFold là hệ thống trí tuệ nhân tạo của DeepMind giải quyết một trong những bài toán khó nhất…
Xem thêm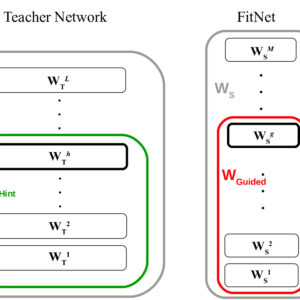
Knowledge Distillation là gì: Nén mô hình AI thông minh
Knowledge Distillation (cất giữ tri thức) là quá trình chuyển kiến thức từ một mô hình lớn sang một mô hình nhỏ hơn. Bất ngờ thay, người học nhỏ không…
Xem thêm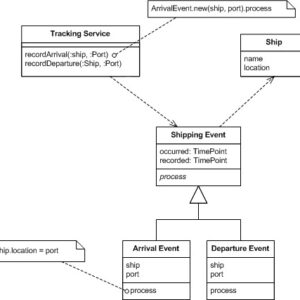
Event Sourcing là gì – Nguyên lý và Ứng dụng thực tế
Event Sourcing là một kiến trúc phần mềm lưu toàn bộ thay đổi trạng thái ứng dụng dưới dạng một chuỗi sự kiện bất biến, thay vì chỉ giữ lại…
Xem thêm
LoRA và QLoRA: Tinh chỉnh mô hình ngôn ngữ lớn tiết kiệm bộ nhớ
LoRA và QLoRA là hai kỹ thuật giúp bạn tinh chỉnh mô hình ngôn ngữ lớn (LLM) mà không cần toàn bộ bộ nhớ VRAM mà một con GPU thương…
Xem thêm
Vector database là gì: Cơ sở dữ liệu tìm kiếm ngữ nghĩa cho AI
Vector database là gì? Vector database là hệ quản trị dữ liệu được thiết kế riêng để lưu trữ, tìm kiếm và so sánh các vector đặc trưng (embedding) có…
Xem thêm
Speculative Decoding là gì: Tăng tốc suy luận LLM gấp nhiều lần
Speculative Decoding là gì: Tăng tốc suy luận LLM Speculative Decoding là kỹ thuật tối ưu nhằm tăng tốc quá trình suy luận (inference) của mô hình ngôn ngữ lớn…
Xem thêm