Thuật toán Dijkstra là thuật toán tìm đường ngắn nhất trên đồ thị có trọng số, được Edsger W. Dijkstra đề xuất vào năm và phổ biến rộng rãi nhờ tính đơn giản và hiệu quả. Trong bài viết này chúng ta sẽ đi từ trực giác, phân tích thuật toán, code tham khảo cho từng ngôn ngữ và cuối cùng là so sánh với các thuật toán tìm đường khác.
Thuật toán Dijkstra là gì
Dijkstra giải quyết bài toán: cho một đồ thị với các cạnh có trọng số khác nhau (ví dụ thời gian, quãng đường, chi phí), tìm tổng trọng số nhỏ nhất để đi từ đỉnh nguồn s tới đỉnh đích t. Điểm mấu chốt là mọi trọng số đều không âm — đây là giả định bắt buộc, vì thuật toán dựa vào việc một đường đi đã chốt là ngắn nhất rồi thì không còn đường nào đi tiếp qua nó tốt hơn được nữa.
Khác biệt cốt lõi giữa Dijkstra và các thuật toán tìm đường khác nằm ở điều kiện đường ngắn nhất. BFS (duyệt theo chiều rộng) chỉ đúng khi mọi cạnh có cùng trọng số. Dijkstra tổng quát hoá điều đó: nó thay “số bước” bằng “tổng trọng số” và dùng một hàng đợi ưu tiên để luôn mở rộng đỉnh gần nhất với khoảng cách nhỏ nhất.
Nguyên lý hoạt động
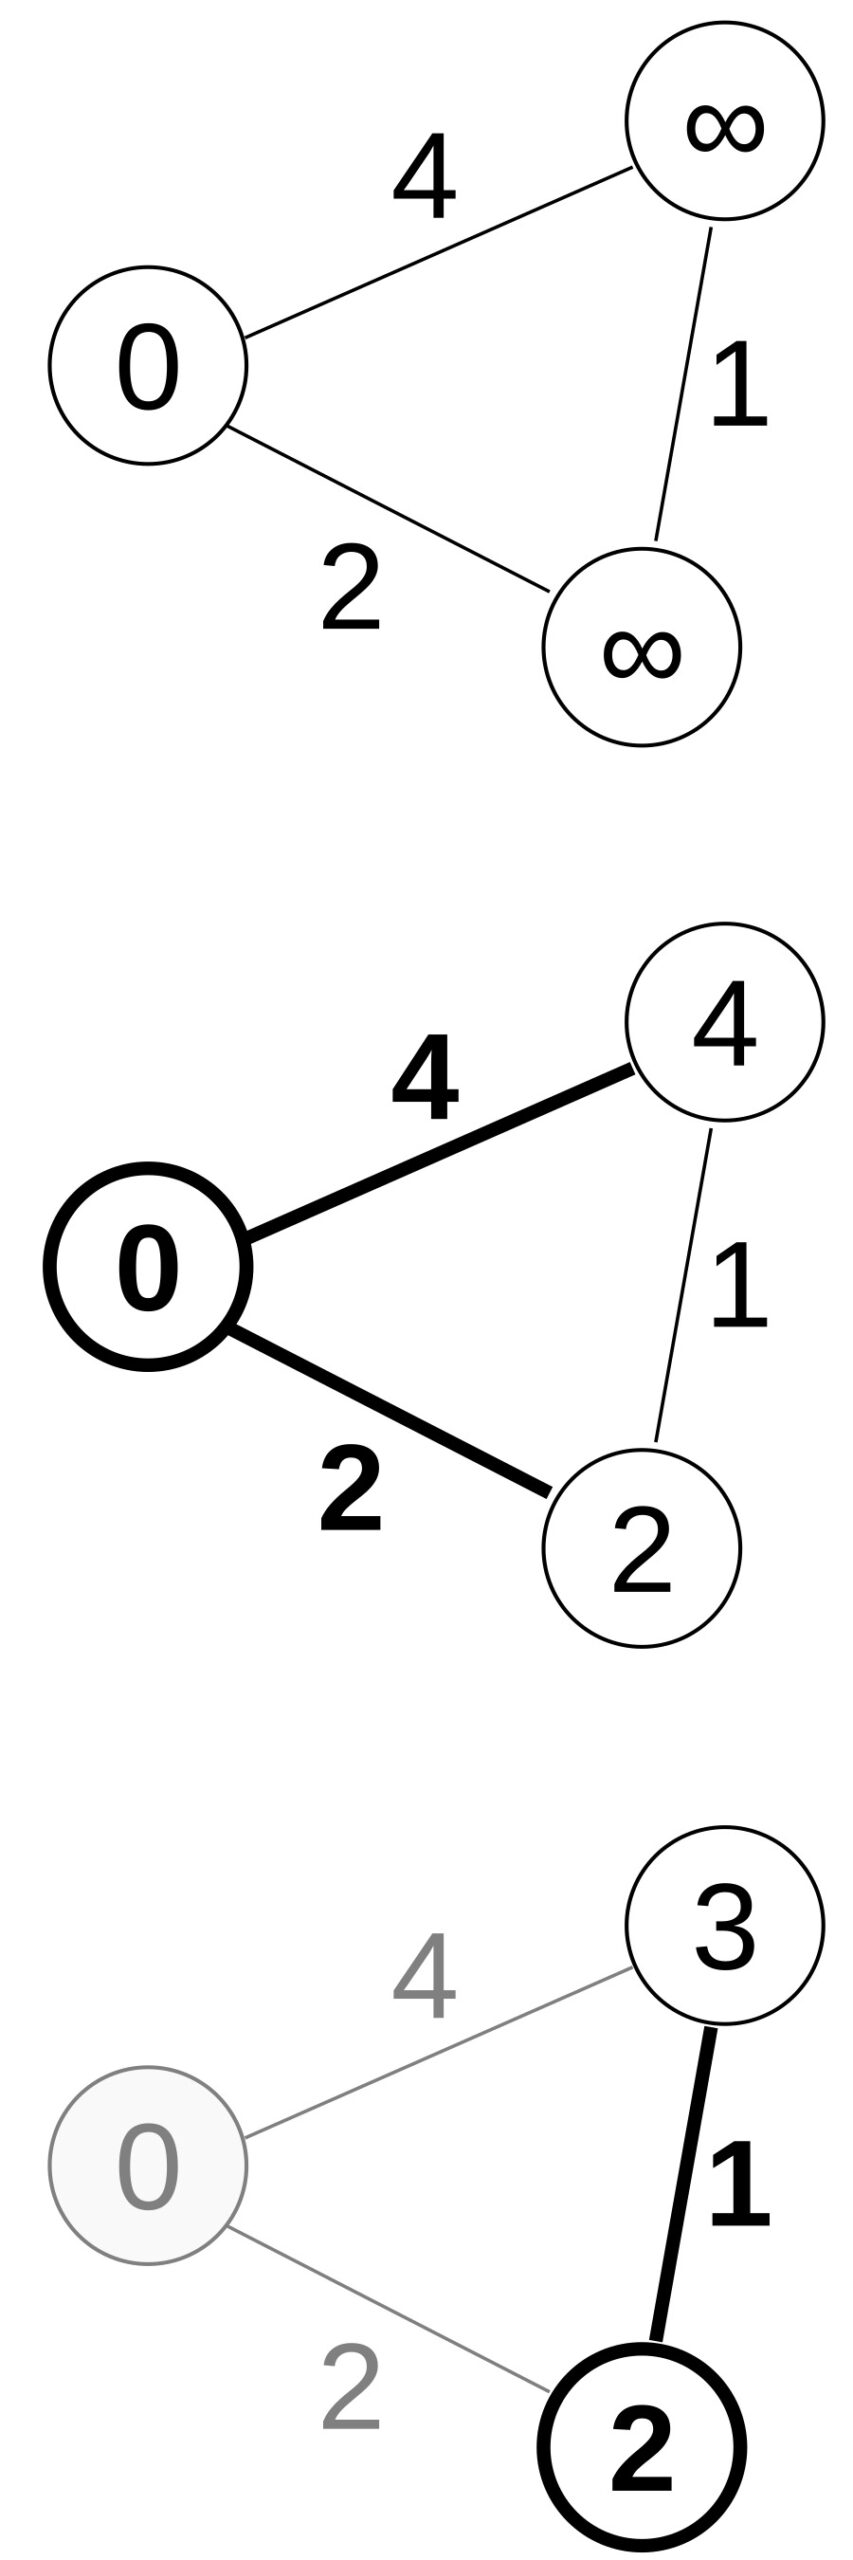
Thuật toán duy trì một bảng dist[v] lưu khoảng cách tốt nhất tìm được từ s tới mỗi đỉnh v. Quy trình lặp lại cho tới khi hàng đợi rỗng:
- Lấy đỉnh
uchưa chốt códist[u]nhỏ nhất từ hàng đợi ưu tiên. - Chốt
u— khoảng cách hiện tại là cuối cùng và không thể cải thiện. - Với mỗi cạnh
u → vcủa trọng sốw, nếudist[u] + w < dist[v]thì cập nhậtdist[v]và đẩy cặp mới vào hàng đợi.
Điểm mấu chốt nằm ở bước 2. Vì không tồn tại đường đi nào tới u có tổng nhỏ hơn dist[u]: nếu có, thì trên đường đi đó sẽ có một đỉnh chưa chốt mà khoảng cách tới nó nhỏ hơn dist[u], trái với việc ta chọn u là đỉnh nhỏ nhất. Đó là lập luận chứng minh tính đúng đắn, và nó chỉ đúng khi trọng số không âm — với trọng số âm, một đường đi vòng lại có thể làm khoảng cách giảm vô hạn.
Ví dụ minh hoạ
Giả sử có đồ thị với 5 đỉnh A, B, C, D, E. Các cạnh: A-B=4, A-C=1, C-B=2, C-D=5, B-D=1, D-E=3. Chạy tay từ A:
| Bước | Đỉnh chốt | Khoảng cách sau khi chốt |
|---|---|---|
| 1 | A | A=0, C=1, B=4, D=∞, E=∞ |
| 2 | C | A=0, C=1, B=3, D=6, E=∞ |
| 3 | B | A=0, C=1, B=3, D=4, E=∞ |
| 4 | D | A=0, C=1, B=3, D=4, E=7 |
| 5 | E | A=0, C=1, B=3, D=4, E=7 |
Kết quả: đường ngắn nhất từ A tới E có tổng trọng số 7 qua A → C → B → D → E, thay vì đường thẳng A → C → D → E có tổng 9. Nếu chỉ lấy trực tiếp trọng số của cạnh, ta dễ bỏ sót việc đi vòng qua B vì cạnh B-D rất nhẹ.
Độ phức tạp thuật toán
Với danh sách kề và hàng đợi ưu tiên, thuật toán chạy trong O((V + E) log V). Nếu dùng heap nhị phân, mỗi thao tác chèn/tách là O(log V) và có nhiều cạnh hơn nút khi đồ thị thưa. Trong trường hợp E >= V², biến thể dùng mảng kề phẳng với O(V²) lại nhanh hơn vì chi phí log V không còn đáng kể so với quét tuyến tính.
| Cấu trúc ưu tiên | Độ phức tạp | Phù hợp khi |
|---|---|---|
| Heap nhị phân | O((V+E) log V) | Đồ thị thưa, cạnh không đều |
| Mảng kề phẳng | O(V²) | Đồ thị dày, cần code tối giản |
| Fibonacci heap | O(E + V log V) | Lý thuyết, hiếm dùng thực tế |
Code Python cho hàng đợi ưu tiên
import heapq

def dijkstra(graph, start):
    dist = {v: float("inf") for v in graph}
    dist[start] = 0
    pq = [(0, start)]
    prev = {}

    while pq:
        d, u = heapq.heappop(pq)
        if d > dist[u]:          # bo qua muc da cap nhat cu
            continue
        for v, w in graph[u].items():
            if d + w < dist[v]:
                dist[v] = d + w
                prev[v] = u
                heapq.heappush(pq, (dist[v], v))
    return dist, prev
Biến prev lưu đỉnh cha để dựng lại đường đi sau khi có khoảng cách. Phần dựng lại chỉ cần đi ngược từ đích về nguồn. Trong Python, heapq là thư viện chuẩn nên không cần cài thêm gì.
Code Java cho hệ thống lớn
public static Map<String, Integer> dijkstra(
        Map<String, List<Edge>> g, String start) {
    Map<String, Integer> dist = new HashMap<>();
    g.keySet().forEach(v -> dist.put(v, Integer.MAX_VALUE));
    dist.put(start, 0);
    PriorityQueue<Node> pq = new PriorityQueue<>(Comparator.comparingInt(Node::dist));
    pq.add(new Node(start, 0));

    while (!pq.isEmpty()) {
        Node u = pq.poll();
        if (u.dist > dist.get(u.name)) continue;
        for (Edge e : g.get(u.name)) {
            int nd = u.dist + e.weight;
            if (nd < dist.get(e.to)) {
                dist.put(e.to, nd);
                pq.add(new Node(e.to, nd));
            }
        }
    }
    return dist;
}
Lưu ý khi dùng số nguyên: đừng dùng Double.POSITIVE_INFINITY làm trọng số khởi tạo vì cộng thêm sẽ cho ra giá trị NaN hoặc số rất lớn. Integer.MAX_VALUE an toàn hơn nếu biết trọng số nhỏ, còn với đồ thị lớn thì dùng long để tránh tràn số.
Dijkstra và trọng số âm
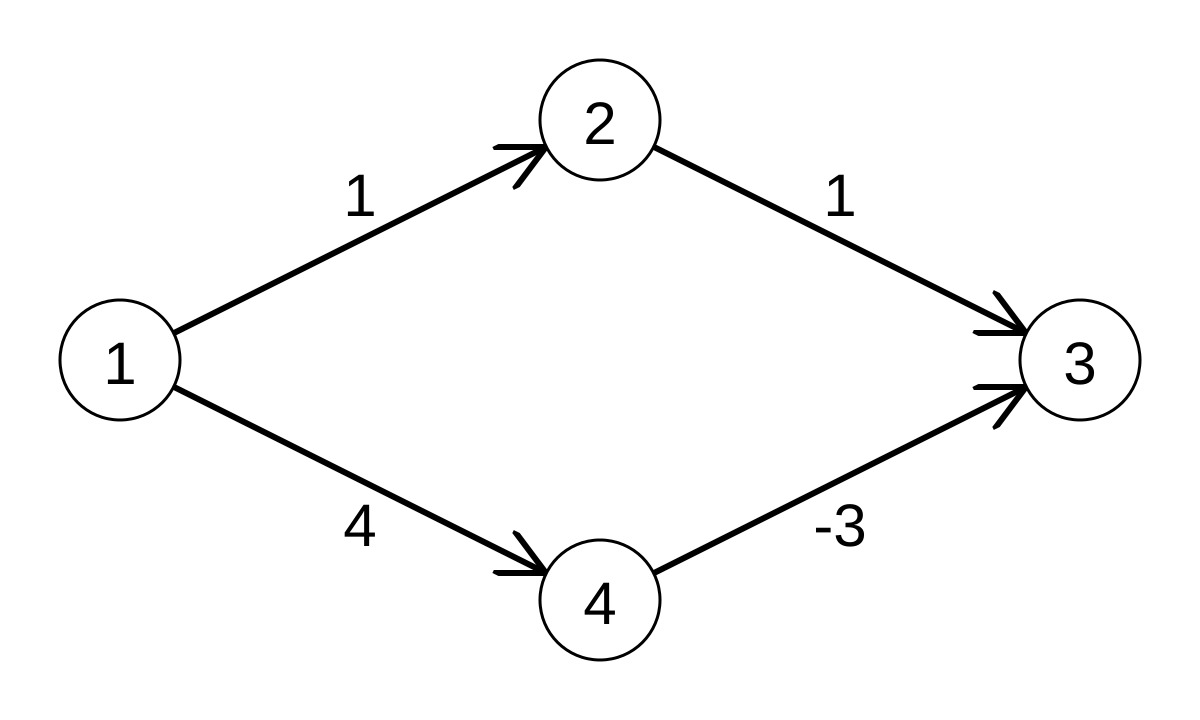
Nếu đồ thị có cạnh âm, Dijkstra cho kết quả sai. Ví dụ ba đỉnh A, B, C với A-B=5, B-C=-4, A-C=1: Dijkstra chốt C với giá trị 1, rồi mới phát hiện đường A-B-C có tổng 1 và bằng — hợp lệ. Nhưng nếu A-B=5, B-C=-10, A-C=1 thì từ A đi vòng B rồi C có tổng -5, thấp hơn nhiều, trong khi thuật toán đã chốt C ở giá trị 1 và không bao giờ xét lại. Khi đó cần thuật toán khác.
So sánh với A*, Bellman-Ford và Floyd-Warshall
| Thuật toán | Trọng số âm | Độ phức tạp | Dùng khi |
|---|---|---|---|
| Dijkstra | Không | O((V+E) log V) | Đường ngắn nhất từ một nguồn, trọng số không âm |
| A* | Không | Phụ thuộc heuristic | Bản đồ, game, có heuristic tốt |
| Bellman-Ford | Có | O(V·E) | Có cạnh âm, phát hiện chu trình âm |
| Floyd-Warshall | Có | O(V³) | Đường ngắn nhất giữa mọi cặp đỉnh |
A* là biến thể của Dijkstra dùng thêm hàm heuristic h(n) ước lượng khoảng cách tới đích, giúp mở rộng các đỉnh có khả năng dẫn tới đích. Nếu h chính xác hoàn toàn, A* không bao giờ mở rộng nhầm. Trong dự án bản đồ, Dijkstra thuần thường mở rộng gần như mọi nút của bản đồ, còn A* chỉ mở rộng một dải hẹp quanh đường đi thực tế.
Ứng dụng thực tế
- Bản đồ và giao thông: Google Maps, Uber, Grab dùng biến thể A* hoặc contraction hierarchies trên đồ thị hàng triệu đỉnh.
- Định tuyến mạng: OSPF dùng thuật toán kiểu Dijkstra (link-state) để mỗi router tính đường ngắn nhất tới mọi mạng đích.
- Lập kế hoạch robot: Khi robot phải tránh vật cản, ô trống được xem là đỉnh và khoảng cách là trọng số.
- Bao lồi tối ưu: Chuỗi cung ứng, phân bổ kho hàng, lịch trình nhân sự đều là bài toán tìm đường ngắn nhất trong đồ thị.
- Xử lý phụ thuộc: Công cụ build và quản lý gói tìm thứ tự cài đặt sao cho tổng thời gian chờ là nhỏ nhất.
Với đồ thị rất lớn, người ta thường tiền xử lý: chia đồ thị thành các cụm, định nghĩa hub, hoặc dùng bidirectional search (tìm đồng thời từ nguồn và đích) để giảm đáng kể không gian tìm kiếm.
Những sai lầm thường gặp
- Quên kiểm tra mục đã cũ trong heap. Khi cập nhật
dist[v], mục cũ vẫn nằm trong heap. Bắt buộc phải bỏ qua nếud > dist[u], nếu không sẽ mở rộng lặp và tốn thời gian vô ích. - Dùng
distlàm điều kiện dừng vô hạn. Phải dừng khi heap rỗng hoặc khi đã chốt đích, không dừng theo giá trị khác. - Áp dụng cho trọng số âm. Nếu bài toán có thể có chi phí âm (hoàn tiền, credit), hãy chuyển sang Bellman-Ford.
- Chọn cấu trúc ưu tiên sai. Với đồ thị dày, heap còn chậm hơn cách quét mảng tuyến tính.
- Không phục hồi đường đi. Lưu
prevtừ đầu, nếu không sẽ phải chạy lại thuật toán lần nữa.
Kết luận
Dijkstra vẫn là lựa chọn mặc định cho bài toán đường ngắn nhất không trọng số âm, nhờ cấu trúc rõ ràng, chứng minh được tính đúng và hiệu năng thực tế tốt. Điều kiện cần nhớ nhất là toàn bộ trọng số phải không âm. Khi bài toán có thêm thông tin ưu tiên theo đích, chọn A*; khi có trọng số âm, chuyển sang Bellman-Ford; khi cần đáp án cho mọi cặp đỉnh và số đỉnh nhỏ, dùng Floyd-Warshall.
Tham khảo thêm: Dijkstra’s algorithm trên Wikipedia, phần giới thiệu thuật toán đồ thị trong NetworkX, và tài liệu module heapq của Python.