Mixture of Experts (MoE) là kiến trúc mô hình ngôn ngữ lớn cho phép tách một mạng nơ-ron thành nhiều “chuyên gia” nhỏ và chỉ kích hoạt một phần trong số đó cho mỗi token đầu vào. Nhờ đó, MoE tăng gấp nhiều lần sức chứa tham số mà chi phí tính toán lại chỉ tăng nhẹ. Bài viết này giải thích toàn bộ cơ chế định tuyến, ưu nhược điểm và cách các hãng lớn triển khai MoE trong thực tế.
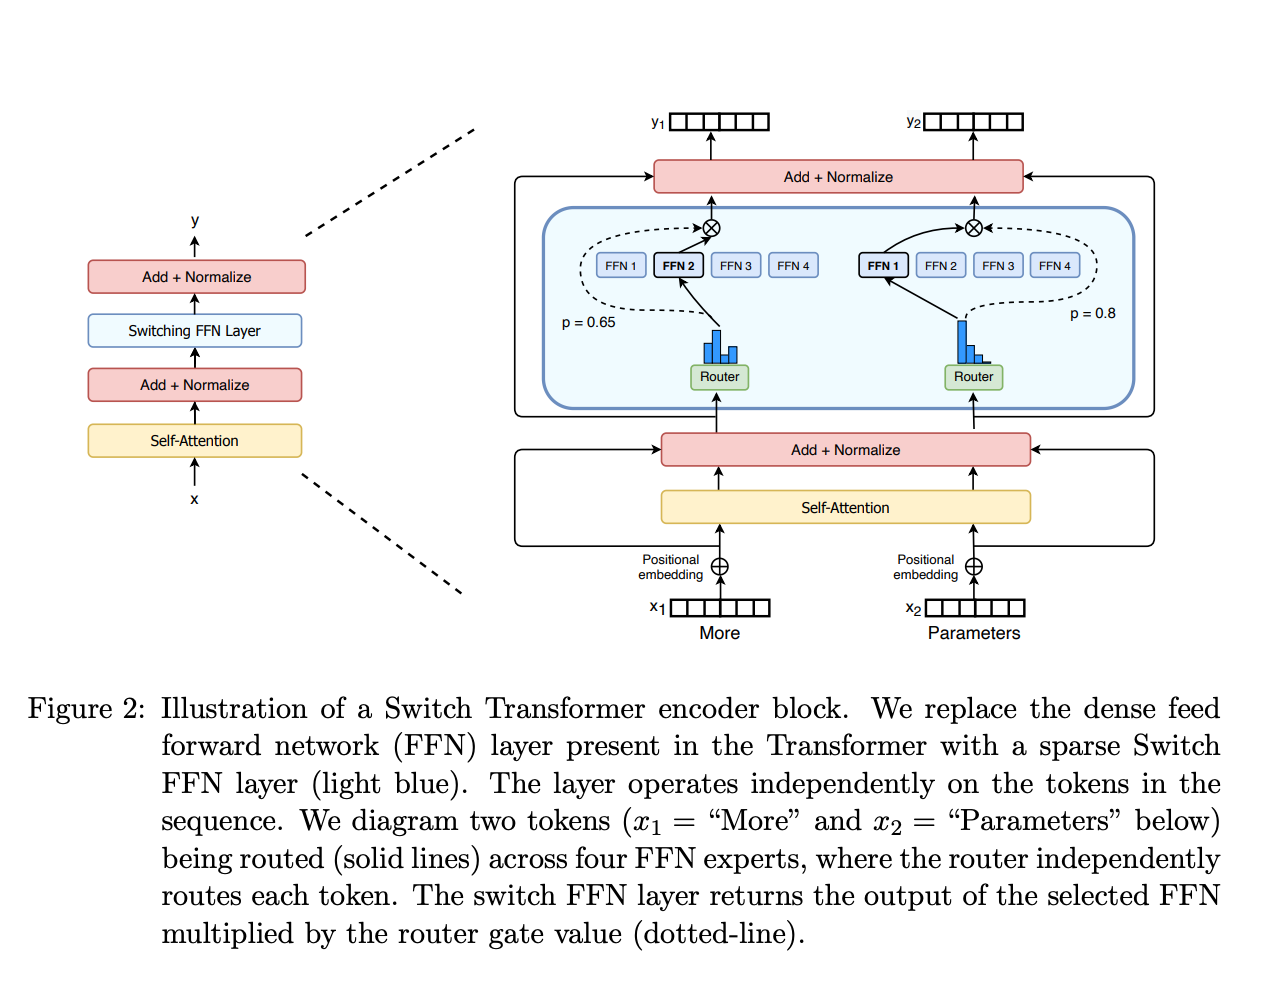
MoE giải quyết vấn đề gì
Mỗi token đi qua cùng một tập trọng số trong mô hình dense thông thường. Muốn mô hình biết nhiều hơn, bạn phải tăng số tầng và độ rộng, kéo theo chi phí FLOP tăng tuyến tính và thời gian suy luận tăng theo tỉ lệ đó.
Trong các bài toán ngôn ngữ, trọng số thường không được dùng đều: cú pháp, tri thức khoa học, lập trình hay đa ngôn ngữ đòi hỏi những “kỹ năng” khác nhau. Ý tưởng của Jacobs và cộng sự (1991) và sau đó là Shazeer và cộng sự là chuyển mỗi kỹ năng thành một chuyên gia riêng, rồi để một mạng định tuyến nhỏ chọn ra chuyên gia phù hợp cho từng đầu vào.
Kết quả: mô hình có thể có 600 tỉ tham số nhưng mỗi token chỉ đi qua khoảng 30 tỉ tham số. Đây là lý do các mô hình như Mixtral 8x7B hay Switch Transformer huấn luyện được nhanh và suy luận rẻ hơn nhiều so với mô hình dense cùng tổng số tham số.
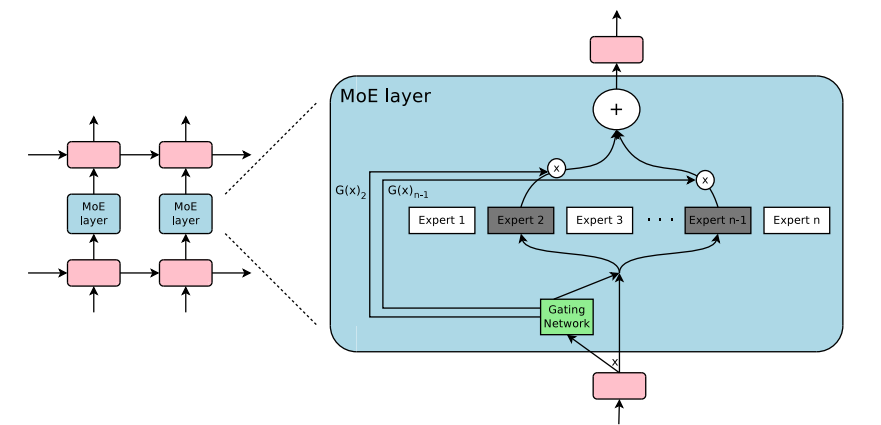
Ba thành phần chính của một MoE layer
1. Router hay gating network
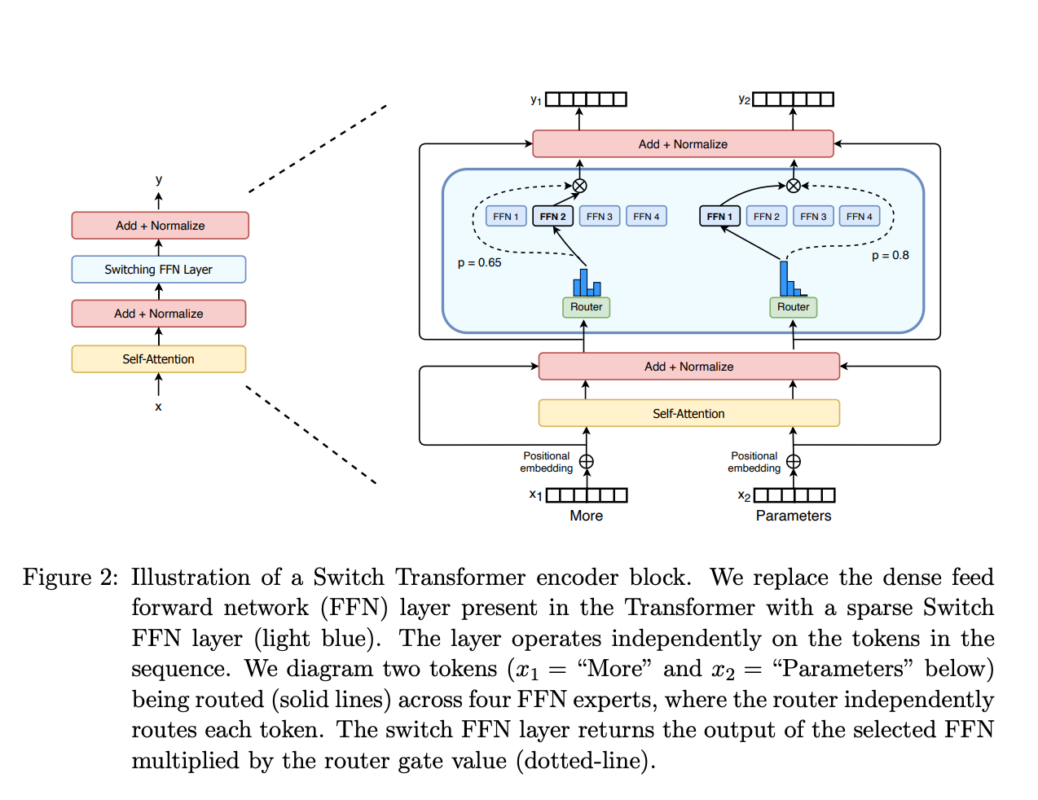
Router là một mạng tuyến tính cực nhỏ, thường chỉ vài nghìn tham số. Nó nhận biểu diễn của token và cho ra điểm số cho từng chuyên gia. Có ba cách chọn phổ biến:
- Top-1 routing: chỉ dùng chuyên gia có điểm cao nhất. Rẻ nhất, được Switch Transformer dùng.
- Top-2 routing: đưa token tới hai chuyên gia rồi lấy trọng số hoành theo điểm số. Chất lượng tốt hơn, FLOP gần gấp đôi.
- Top-k routing: tổng quát hoá của hai cách trên, với k bất kỳ.
2. Các chuyên gia
Mỗi chuyên gia là một mạng feed-forward nhỏ. Trong thiết kế phổ biến, chỉ một phần tầng FFN của transformer được thay bằng MoE, còn lớp tự chú ý (attention) vẫn dùng chung. Mixtral 8x7B có 8 chuyên gia, mỗi chuyên gia 7 tỉ tham số, tổng 46.7 tỉ tham số được dùng thực tế cho mỗi token.
3. Cơ chế capacity factor
Đây là chi tiết hay bị bỏ qua nhưng quyết định vận hành. Mỗi chuyên gia chỉ nhận tối đa một số token cố định gọi là capacity. Người dùng có thể điều khiển bằng capacity factor, là tỉ lệ giữa số token tối đa và số token trung bình mỗi chuyên gia có thể xử lý. Token vượt capacity sẽ bị drop và phần thông tin bị mất, hoặc được xử lý bởi chuyên gia dự phòng tùy phiên bản.
Load balancing: vấn đề thầm lặng của MoE
Nếu không can thiệp, router sẽ tự nhiên dồn token về vài chuyên gia “quen” và bỏ rơi phần còn lại, khiến phần lớn tham số chết. Switch Transformer đưa ra hàm tổn thất cân bằng tải, lấy gradient từ tổng số token mỗi chuyên gia nhận được:
L = alpha * N * sum_i f_i * P_i
Trong đó f_i là tỉ lệ token được định tuyến tới chuyên gia i, P_i là tỉ lệ token chuyên gia i thực sự xử lý do giới hạn capacity, và alpha là hệ số cân bằng. Khi một chuyên gia quá tải, P_i tăng, gradient của hàm tổn thất đẩy router phân bố lại đều hơn.
Ưu điểm và cái giá phải trả
| Tiêu chí | MoE | Mô hình dense |
|---|---|---|
| Tổng tham số | Rất lớn, có thể hàng trăm tỉ | Ít hơn cho cùng ngân sách |
| FLOP mỗi token | Thấp, chỉ vài chuyên gia | Toàn bộ tham số |
| Bộ nhớ VRAM khi suy luận | Phải giữ toàn bộ chuyên gia | Ít hơn |
| Độ trễ suy luận | Thấp hơn, nhưng có độ trễ giao tiếp | Ổn định |
| Độ ổn định huấn luyện | Khó hơn, dễ mất cân bằng | Ổn định hơn |
| Dễ triển khai | Cần all-to-all, phân tán | Đơn giản |
Nói cách khác, MoE đánh đổi giữa độ phức tạp hạ tầng và hiệu quả tính toán. Bạn cần nhiều GPU hơn để chứa tham số, nhưng mỗi token lại chạy nhanh hơn.
Các mô hình MoE đáng chú ý
- Mixtral 8x7B của Mistral AI: mã nguồn mở, 8 chuyên gia, hiệu năng ngang với mô hình lớn gấp nhiều lần.
- DeepSeek-V2/V3: bổ sung cơ chế chia nhỏ token (fine-grained expert segmentation) để giảm chi phí kích hoạt, kèm thiết bị tăng tốc routing độc lập.
- Qwen, DBRX, Snowflake Arctic: các biến thể thương mại và nghiên cứu với cách định tuyến khác nhau.
Khi nào nên chọn MoE
MoE hợp lý khi bạn cần sức chứa tri thức lớn nhưng hạn chế ngân sách suy luận, hoặc khi phục vụ nhiều ngôn ngữ và nhiều miền chuyên ngành với một mô hình duy nhất. Nó không hợp lý cho ứng dụng chạy trên thiết bị biên, cho mô hình nhỏ dưới 7 tỉ tham số, hoặc khi hạ tầng chỉ có một vài GPU đơn lẻ mà không có kỹ năng all-to-all.
Tóm lại, MoE là câu trả lời cho câu hỏi làm sao có mô hình rất lớn mà vẫn suy luận rẻ. Công bằng mà nói, nó chỉ đổi vấn đề: thay vì tốn FLOP, bạn tốn bộ nhớ và độ phức tạp phân tán. Phần tài liệu MoE của Hugging Face là điểm khởi đầu tốt nếu bạn muốn tự thử nghiệm.