vLLM: Công cụ serving LLM siêu tốc, tiết kiệm bộ nhớ GPU
vLLM là một engine suy diễn và phục vụ LLM (large language model) nhanh và tiết kiệm bộ nhớ, được phát triển bởi nghiên cứu viên Đại học Berkeley. Nhờ thuật toán PagedAttention và kỹ thuật continuous batching, vLLM tăng throughput gấp nhiều lần so với cách triển khai truyền thống. Đặc biệt, vLLM hỗ trợ API tương thích OpenAI, giúp developer tích hợp ngay mà không cần viết lại mã nguồn. vLLM hiện là dự án serving LLM được cộng đồng lớn nhất trên GitHub với hàng ngàn sao và hàng trăm contributor.
PagedAttention: Bí quyết tiết kiệm bộ nhớ
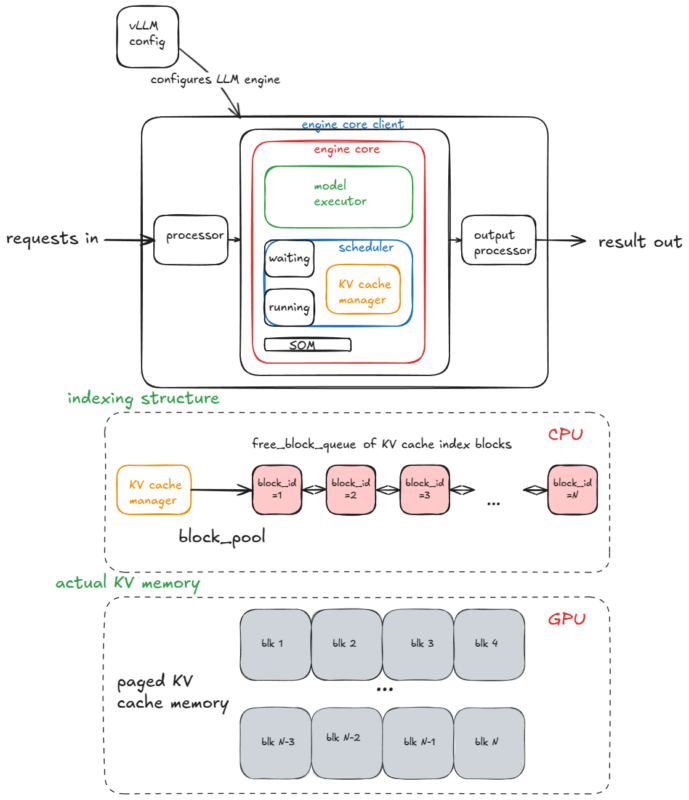
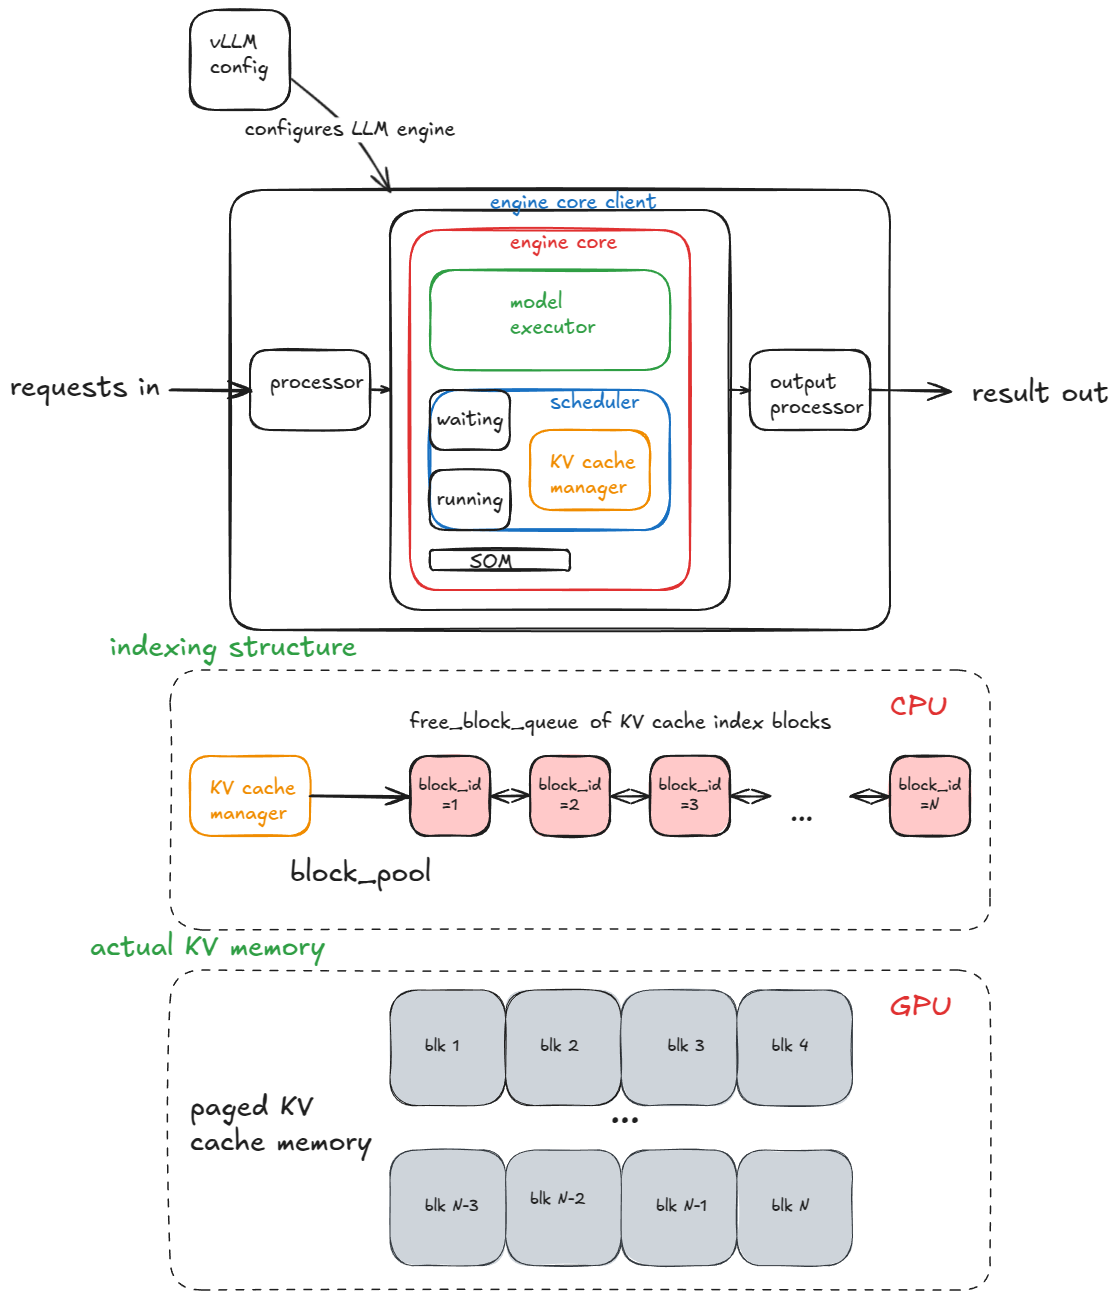
PagedAttention là cốt lõi của vLLM. Thay vì lưu trữ toàn bộ KV cache liên tục trong GPU memory như cách truyền thống, PagedAttention chia KV cache thành từng trang nhỏ (page) và lưu trữ linh hoạt trên bộ nhớ, tương tự hệ điều hành quản lý trang bộ nhớ. Điều này cho phép nhiều yêu cầu đồng thời chia sẻ GPU memory mà không bị giới hạn bởi kích thước mô hình.
Với PagedAttention, vLLM có thể phục vụ mô hình tới 8x lớn hơn trên cùng một GPU so với cách tiếp cận truyền thống. Điều này giúp giảm đáng kể chi phí triển khai cho các công ty muốn chạy LLM lớn như Llama, Qwen hay Mistral. KV cache được lưu trữ theo dạng page table, giống như hệ điều hành Linux dùng bảng trang để quản lý bộ nhớ ảo — vLLM có thể lấy lại và tái phân bố các trang khi yêu cầu kết thúc.
Continuous batching và scheduling
Continuous batching cho phép máy chủ thêm yêu cầu mới vào batch ngay khi các yêu cầu khác đang được xử lý, thay vì chờ toàn bộ batch hoàn thành. Kết hợp với scheduling thông minh, vLLM đạt mức GPU utilization lên tới 90%, tối ưu cho workload đa tải trọng.
- PagedAttention: Quản lý KV cache theo trang, tiết kiệm bộ nhớ.
- Continuous batching: Tối đa hóa throughput bằng cách gộp yêu cầu liên tục.
- Prefix caching: Tận dụng lại KV cache cho prompt trùng lặp.
- Speculative decoding: Tăng tốc sinh token bằng mô hình phụ trợ.
- Multi-GPU serving: Hỗ trợ tensor parallelism và pipeline.
Benchmark và hiệu suất thực tế
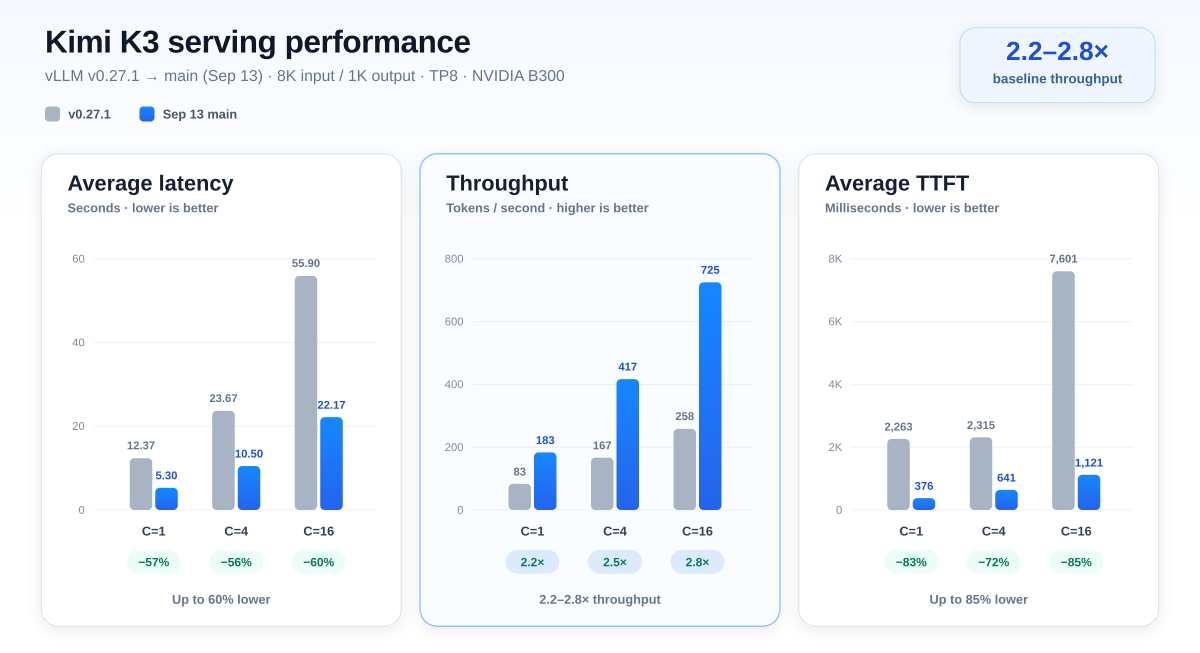
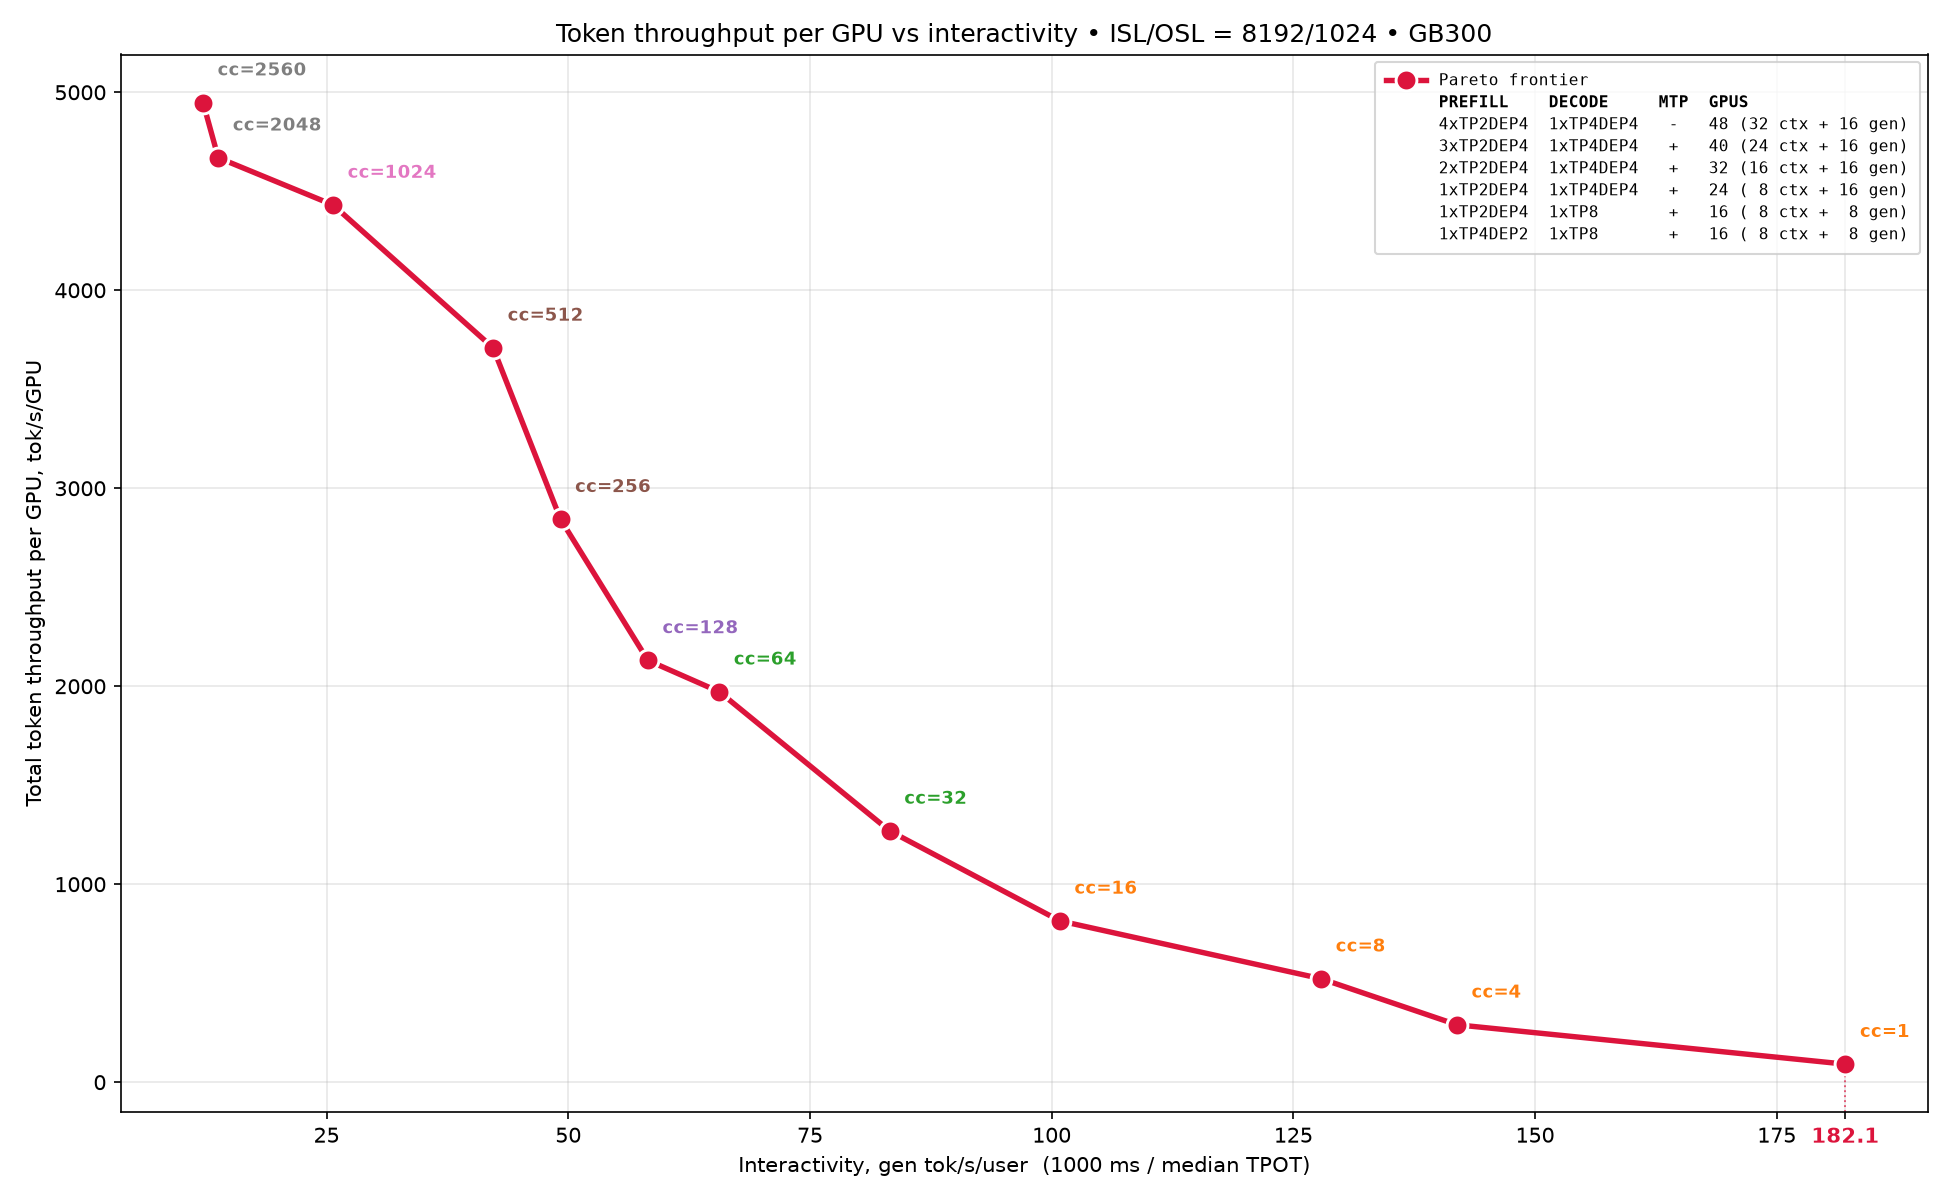
Với cấu hình PD (prefill-decode) disaggregation trên Qwen3 8B, vLLM đạt throughput lên tới 5.000 tokens/giây — gấp 3x so với cách tiếp cận truyền thống. Độ trễ phản hồi (TTFT) ở mức trung bình 15–40ms, đủ cho ứng dụng chat thời gian thực. Kết quả được đo trên nền tảng hardware GB300 NVLink-72, khẳng định lợi thế của vLLM trong serving LLM quy mô lớn.
Hệ sinh thái và khả năng mở rộng
vLLM hỗ trợ rộng rãi các mô hình nguồn mở lớn như Llama 2/3, Qwen 2/3, Mistral 7B/8x22B, Gemma, và các mô hình tiếng Việt do cộng đồng đóng góp. Nhờ plugin MoE (Mixture of Experts), vLLM có thể chạy các dạng mô hình chuyên gia phân tán như Qwen2.5-Omni, Kimi-K3, và các bản ghi MoE từ Mistral — giảm đáng kể overhead khi tải mô hình lớn.
API tương thích OpenAI
vLLM cung cấp một server OpenAI-compatible API. Developer chỉ cần thay đổi base URL trong SDK OpenAI: https://api.vllm.vn/v1 hoặc cài đặt local. Tất cả endpoint như /chat/completions và /embeddings đều hoạt động giống hệt.
pip install vllm --torch-backend autoSau khi cài đặt, khởi động server:
vllm serve "meta-llama/Llama-2-7b-chat-hf"Rồi gọi API như bình thường thông qua openai Python SDK. Ví dụ:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="token")
response = client.chat.completions.create(
    model="meta-llama/Llama-2-7b-chat-hf",
    messages=[{"role": "user", "content": "Giải thích PagedAttention là gì?"}]
)
Tích hợp cloud và edge
Bên cạnh triển khai local, vLLM hỗ trợ cả triển khai trên GPU cloud (NVIDIA H100, A100) và Apple Silicon thông qua vllm-metal — một nhánh mang khả năng serving paged, continuously batched tới chip M-series của Apple. Điều này mở đường cho AI inference chạy trên laptop mà không cần đám mây.
PD disaggregation và Web Optimizer
Trong phiên bản 0.9.x, vLLM ra mắt PD (prefill-decode) disaggregation cho phép tách giai đoạn prefill và decode ra các GPU khác nhau. Điều này tối ưu hóa việc sử dụng tài nguyên khi có nhiều worker đồng thời gửi yêu cầu sinh văn bản. Ngoài ra, vLLM Web UI cung cấp giao diện đồ họa trực tuyến giúp người dùng không cần lập trình cũng có thể quản lý mô hình, cấu hình và theo dõi metrics. Mã nguồn mở cho phép cộng đồng bổ sung các nhà cung cấp backend (CUDA, ROCm, XPU, CPU) tùy theo nền tảng phần cứng.
Trang chủ vLLM và tài liệu chính thức cập nhật chi tiết mỗi tính năng và benchmark.
Kết luận
vLLM trở thành lựa chọn hàng đầu cho việc serving LLM nhờ PagedAttention, API tương thích OpenAI và hiệu suất cao. Dự án được phát triển hoàn toàn mã nguồn mở trên GitHub, liên tục được cập nhật với các tính năng cutting-edge như speculative decoding và PD disaggregation.