Bloom filter là gì? Đây là một cấu trúc dữ liệu xác định xác suất, được nhà khoa học máy tính Burton Howard Bloom đề xuất năm 1970, dùng để kiểm tra một phần tử có thuộc một tập hợp hay không với mức dùng bộ nhớ cực kỳ tiết kiệm. Thay vì lưu toàn bộ dữ liệu, Bloom filter chỉ lưu một mảng bit nhỏ và trả lời nhanh: phần tử chắc chắn không có, hoặc có thể có. Bài viết này giải thích nguyên lý, công thức chọn tham số, ưu điểm, giới hạn và ứng dụng thực tế của Bloom filter trong lập trình.
Ý tưởng cốt lõi
Trong phần lớn bài toán, vấn đề không phải là tra cứu chậm mà là tiêu tốn quá nhiều bộ nhớ để lưu toàn bộ tập hợp. Ví dụ kinh điển của Bloom: một từ điển 500.000 từ tiếng Anh, trong đó 90% có thể tách âm tiết bằng quy tắc đơn giản, còn 10% cần tra cứu đĩa để lấy quy tắc phức tạp. Nếu dùng bảng băm không sai, với đủ bộ nhớ, ta loại bỏ được mọi lần truy cập đĩa thừa. Nhưng khi bộ nhớ hạn chế, kỹ thuật của Bloom dùng vùng băm chỉ bằng 18% kích thước lý tưởng vẫn loại bỏ được 87% số lần truy cập đĩa. Nói cách khác, chấp nhận một tỉ lệ sai nhỏ để đổi lấy tiết kiệm bộ nhớ lớn.
Điểm cốt lõi của Bloom filter là nó không bao giờ cho kết quả sai âm (false negative). Nếu một phần tử thực sự nằm trong tập, bộ lọc chắc chắn báo có. Điều nó không đảm bảo là khi báo có, phần tử đó có thực sự có hay không, vì những bit khác nhau có thể tình cờ cùng được bật lên bởi các phần tử trước đó. Đây là sai dương (false positive), và nó là cái giá bạn trả để có tốc độ và dung lượng tốt đến mức đáng ngạc nhiên.
Cách hoạt động
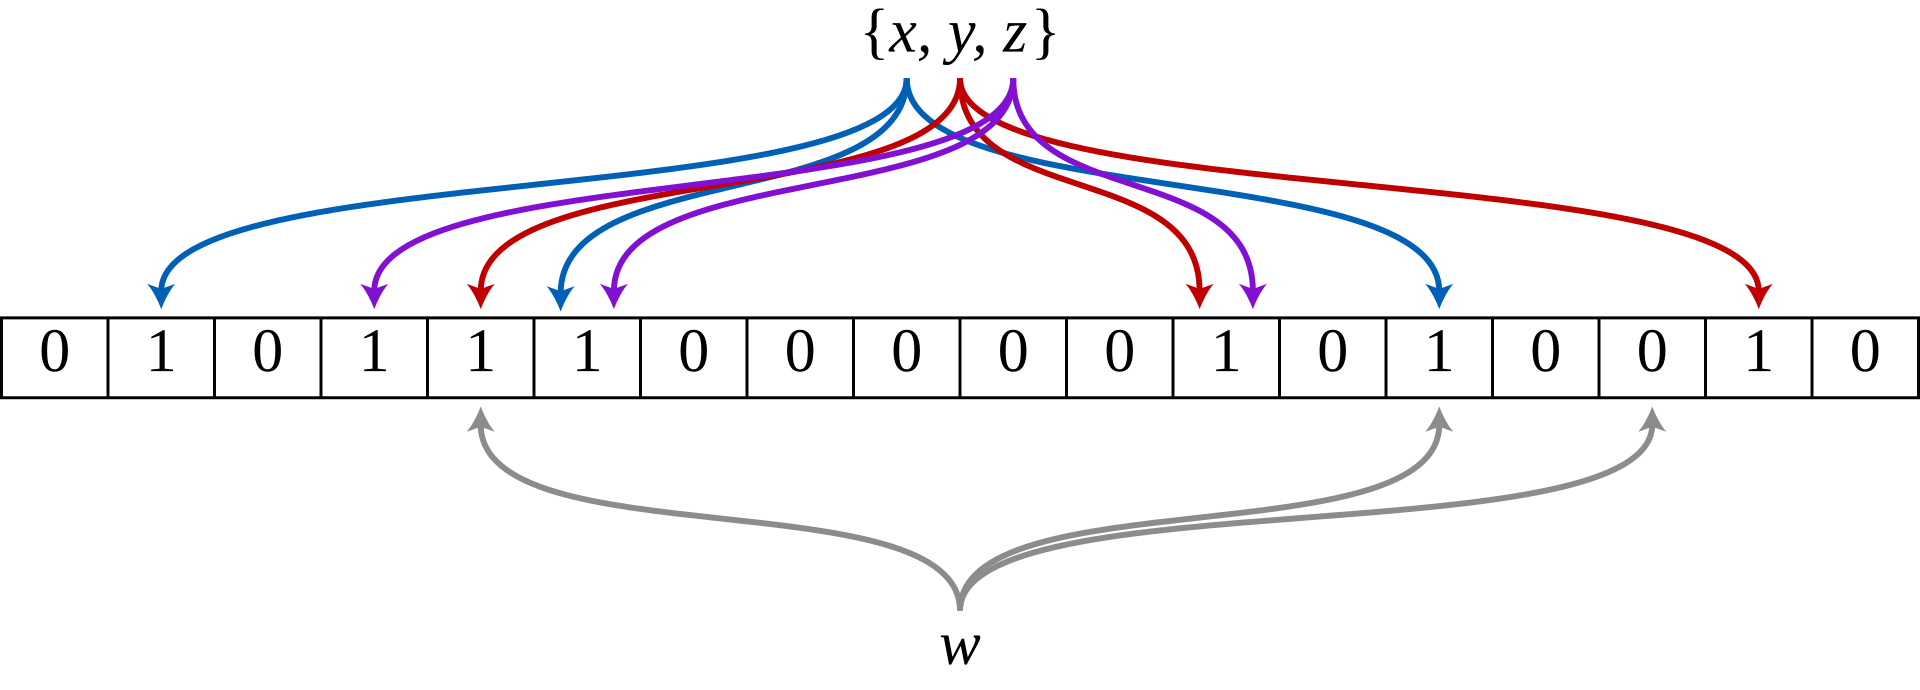
Một Bloom filter rỗng đơn giản là một mảng gồm m bit, toàn bộ ban đầu bằng 0. Bộ lọc được trang bị k hàm băm khác nhau, mỗi hàm ánh xạ một phần tử tới một trong m vị trí trong mảng. Các hàm băm nên phân bố đều và độc lập với nhau. Thông thường k là một hằng số nhỏ, phụ thuộc vào tỉ lệ lỗi mong muốn, còn m tỉ lệ thuận với k và số phần tử sẽ thêm vào.
Thêm một phần tử: đưa phần tử qua cả k hàm băm để có k vị trí trong mảng, rồi bật (đặt thành 1) tất cả các bit tại những vị trí đó.
Kiểm tra một phần tử: đưa phần tử qua cả k hàm băm để có k vị trí. Nếu bất kỳ bit nào tại các vị trí đó còn bằng 0, phần tử chắc chắn không thuộc tập, vì khi nó được thêm vào, tất cả các bit ấy đều đã được bật lên. Nếu tất cả đều bằng 1, hoặc là phần tử có thật trong tập, hoặc các bit đã bị ngẫu nhiên bật lên khi thêm những phần tử khác, tạo ra kết quả sai dương. Bộ lọc Bloom đơn giản không có cách phân biệt hai trường hợp này, nhưng các kỹ thuật nâng cao có thể giải quyết vấn đề.
Việc thiết kế k hàm băm độc lập thực sự trở nên tốn kém khi k lớn. May mắn là với một hàm băm có đầu ra rộng, ta có thể tạo ra nhiều hàm băm khác nhau chỉ bằng cách cắt đầu ra thành nhiều trường bit. Hoặc truyền các giá trị khởi tạo khác nhau, hoặc cộng các giá trị đó vào khóa. Với m và k lớn, có thể nới lỏng yêu cầu độc lập mà tỉ lệ sai dương gần như không đổi.
Công thức chọn tham số
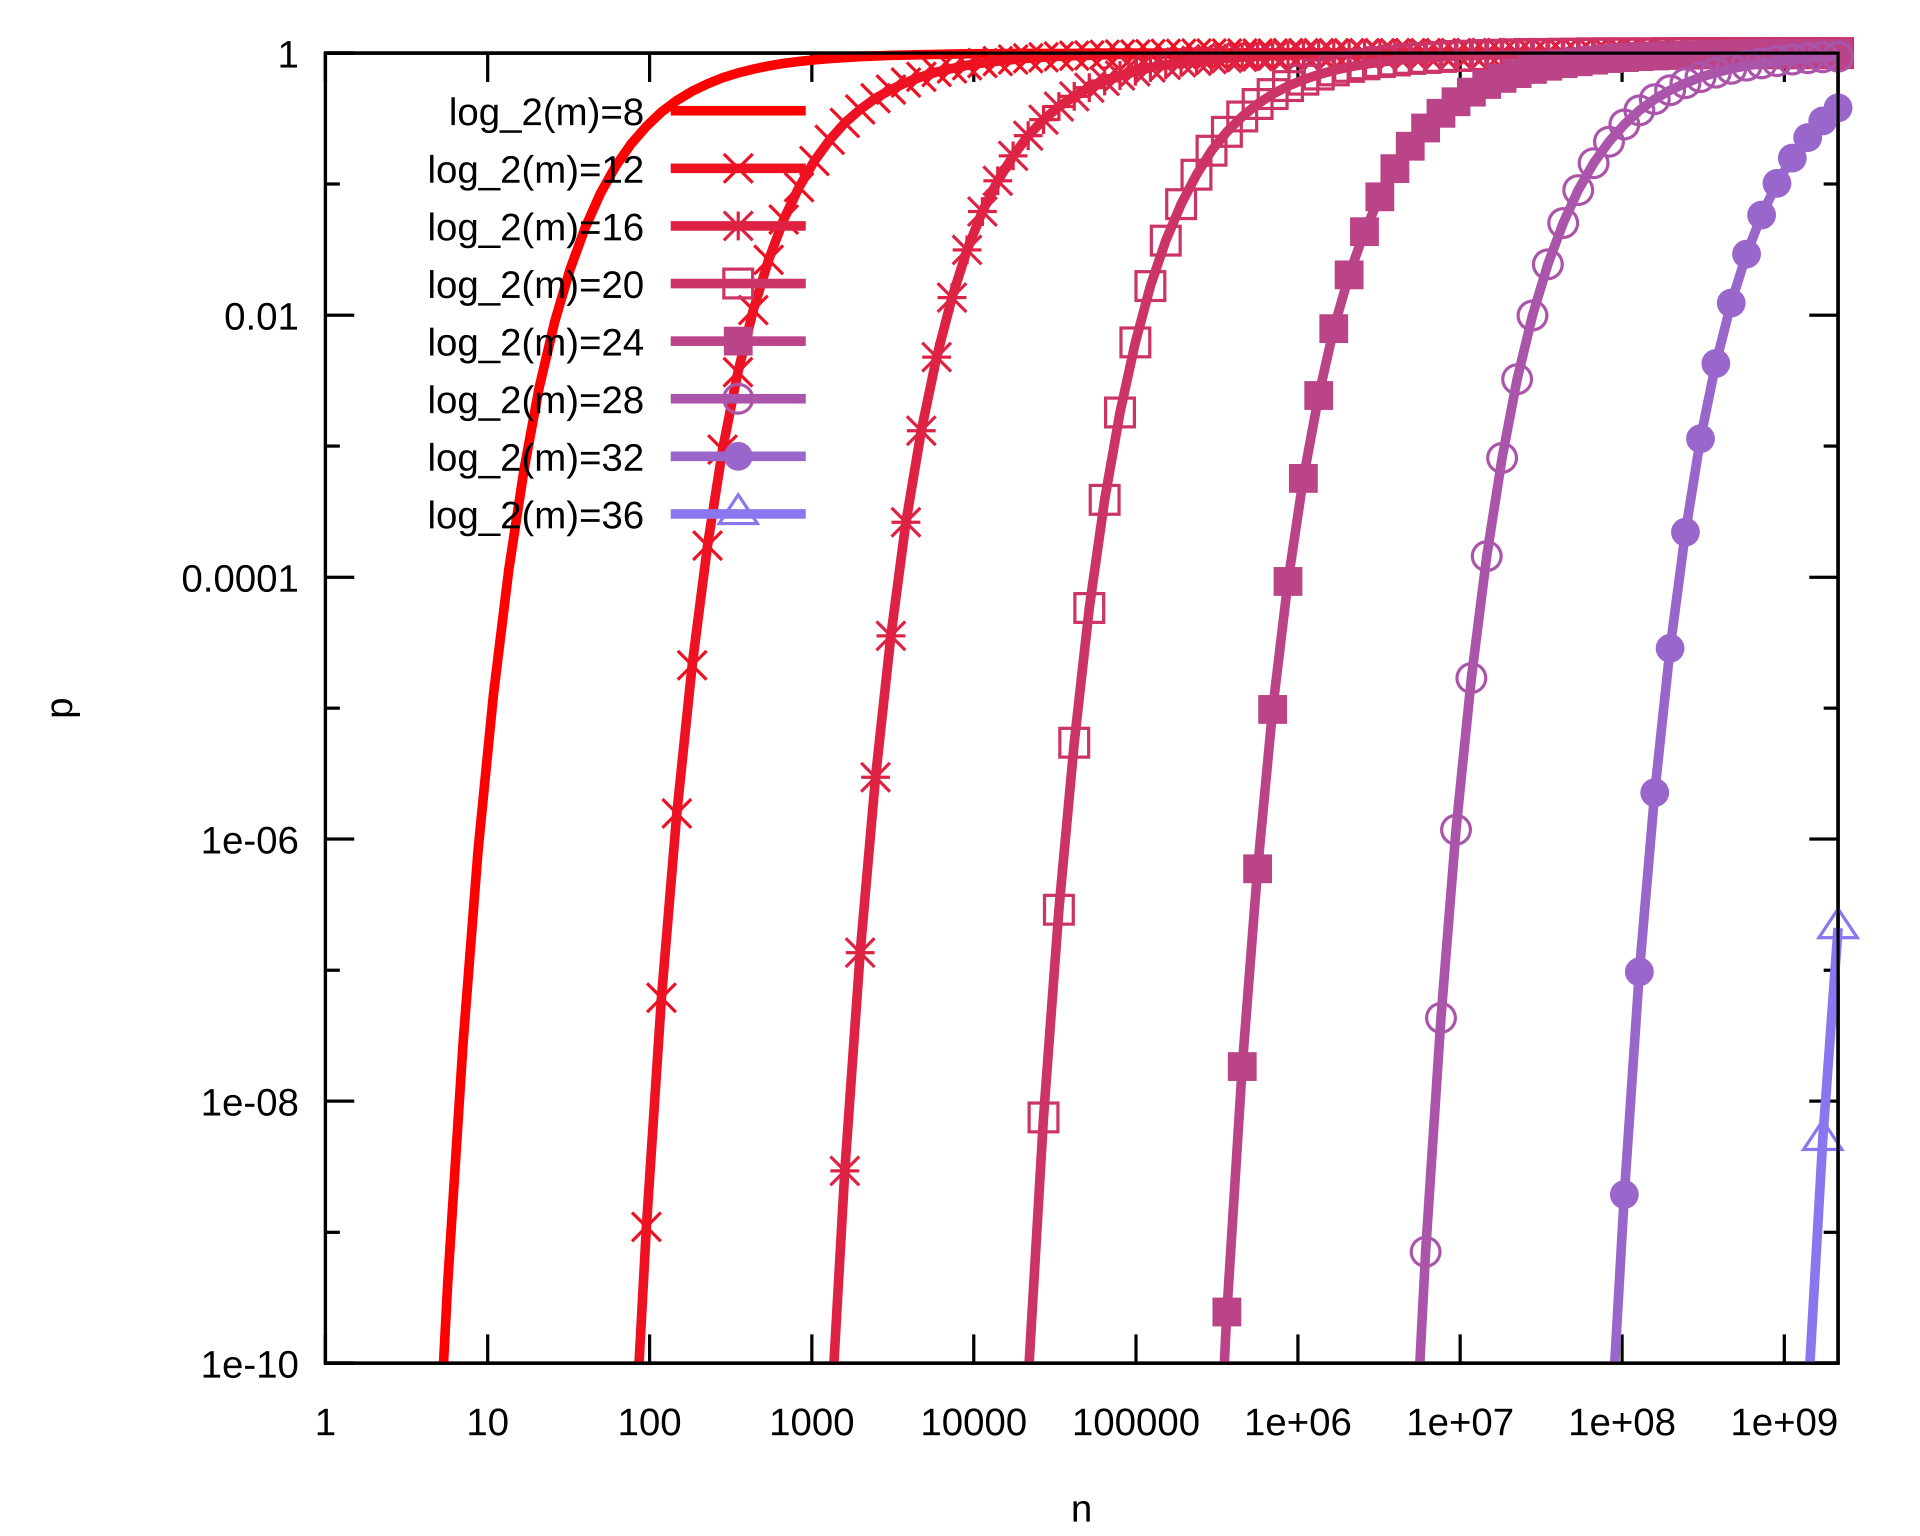
Điểm mạnh nữa của Bloom filter nằm ở hiệu suất không gian. Chỉ với tỉ lệ lỗi 1% và giá trị k tối ưu, bộ lọc chỉ cần khoảng 9,6 bit cho mỗi phần tử, bất kể kích thước của phần tử là bao nhiêu. Muốn giảm tỉ lệ sai dương xuống mức thấp hơn, ta có thể đánh đổi bằng cách thêm bit. Cụ thể, giảm tỉ lệ lỗi đi một bậc mười chỉ cần thêm khoảng 4,8 bit cho mỗi phần tử. Đây là điểm cần nhớ: bộ nhớ và độ chính xác có quan hệ nghịch đảo, nhưng tỷ lệ trao đổi rẻ hơn nhiều so với việc lưu dữ liệu thật.
So với các cấu trúc khác như cây tìm kiếm nhị phân cân bằng, trie, bảng băm hay mảng đơn giản, Bloom filter tiết kiệm không gian vượt trội vì nó không lưu phần tử dữ liệu mà chỉ lưu chút thông tin trạng thái. Tuy nhiên, nếu số giá trị tiềm năng nhỏ và phần lớn đều nằm trong tập, mảng bit xác định chỉ cần một bit cho mỗi giá trị lại thắng. Còn bảng băm, nếu bỏ qua va chạm và chỉ lưu trạng thái có/không của mỗi bucket, thực chất đã biến thành Bloom filter với k bằng 1.
Ưu điểm và giới hạn
Bloom filter có một đặc tính độc đáo: thời gian để thêm phần tử lẫn thời gian kiểm tra thành viên đều là hằng số O(k), hoàn toàn độc lập với số phần tử đã có trong tập. Không cấu trúc tập hợp không gian hằng nào khác có đặc tính này. Trên phần cứng, lợi thế càng rõ vì k lần tra cứu là độc lập và có thể chạy song song.
Tuy nhiên, có những giới hạn rõ ràng cần cân nhắc:
- Không thể xóa phần tử. Bộ lọc đơn giản không biết bit nào thuộc về phần tử cần xóa. Xóa bất kỳ bit nào trong k bit đó đủ để gỡ phần tử, nhưng cũng xóa luôn mọi phần tử khác cùng ánh xạ tới bit đó, gây ra kết quả sai âm. Có thể mô phỏng việc xóa một lần bằng cách dùng thêm một Bloom filter thứ hai chứa các phần tử đã xóa, nhưng khi đó sai dương của bộ lọc thứ hai lại biến thành sai âm của bộ lọc tổng hợp, và không thể thêm lại phần tử đã xóa.
- Tỉ lệ sai dương tăng theo thời gian. Càng thêm nhiều phần tử, xác suất sai dương càng cao. Nếu tỉ lệ lỗi vượt ngưỡng mong muốn, phải dựng lại bộ lọc từ đầu, một sự kiện được xem là hiếm.
- Không liệt kê hay đếm được. Bộ lọc chỉ trả lời có/không, không cho biết tập có bao nhiêu phần tử.
Ứng dụng thực tế
Bloom filter được dùng rộng rãi ở những nơi phần lớn số lần truy vấn đều không trúng và một phần lớn lưu trữ là dư thừa:
- Trình duyệt và phần mở rộng: kiểm tra một URL có trong cache không, để khỏi gửi yêu cầu mạng vô ích.
- Cơ sở dữ liệu: bỏ qua các hàng không khớp điều kiện lọc trước khi đọc từ đĩa, giảm tải cho I/O.
- Hệ thống phân tán: chống lặp lại thông điệp trong hàng đợi phân tán, giảm tải cho broker.
- Chống lạm dụng: lọc số điện thoại, địa chỉ IP đã gặp rắc rối trước đó, bảo vệ tài nguyên.
- Thuật toán đồ thị và phần mềm: giải quyết tập hợp con, dự án tối ưu, so khớp chuỗi với chi phí dưới tuyến tính.
Nguyên lý Bloom filter được trình bày chi tiết hơn trong bài Bloom filter trên Wikipedia. Nếu bạn muốn nắm nền tảng toán học của mảng bit và hàm băm, hãy đọc bài hàm băm mật mã cùng bài mảng bit để hiểu sâu hơn nền tảng mà Bloom filter dựa trên đó.
Khi nào nên dùng và khi nào nên tránh
Bloom filter là lựa chọn đúng khi bạn cần một bước lọc rẻ, chạy trước mọi thao tác đắt giá, và chấp nhận tỉ lệ sai dương nhỏ. Đừng dùng nó khi bạn cần trả lời chính xác tuyệt đối mà chưa sẵn sàng tra cứu nguồn dữ liệu thật khi nghi ngờ kết quả dương, khi bạn cần xóa phần tử, hoặc khi tập rất nhỏ và biến thiên liên tục. Trong những trường hợp đó, một bảng băm hay cây cân bằng đơn giản thường dễ quản lý hơn.
Biến thể Counting Bloom Filter khắc phục giới hạn không xóa được bằng cách thay mỗi bit bằng một bộ đếm nhỏ, tăng khoảng 4 lần dung lượng nhưng cho phép gỡ phần tử. Nếu đây là hướng bạn cần, hãy cân nhắc thêm các biến thể nâng cao hơn như Cuckoo Filter, vốn hỗ trợ xóa và có tỉ lệ sai dương tốt hơn ở cùng mức bộ nhớ.