RAG là gì? Kết hợp truy xuất và sinh văn bản cho LLM
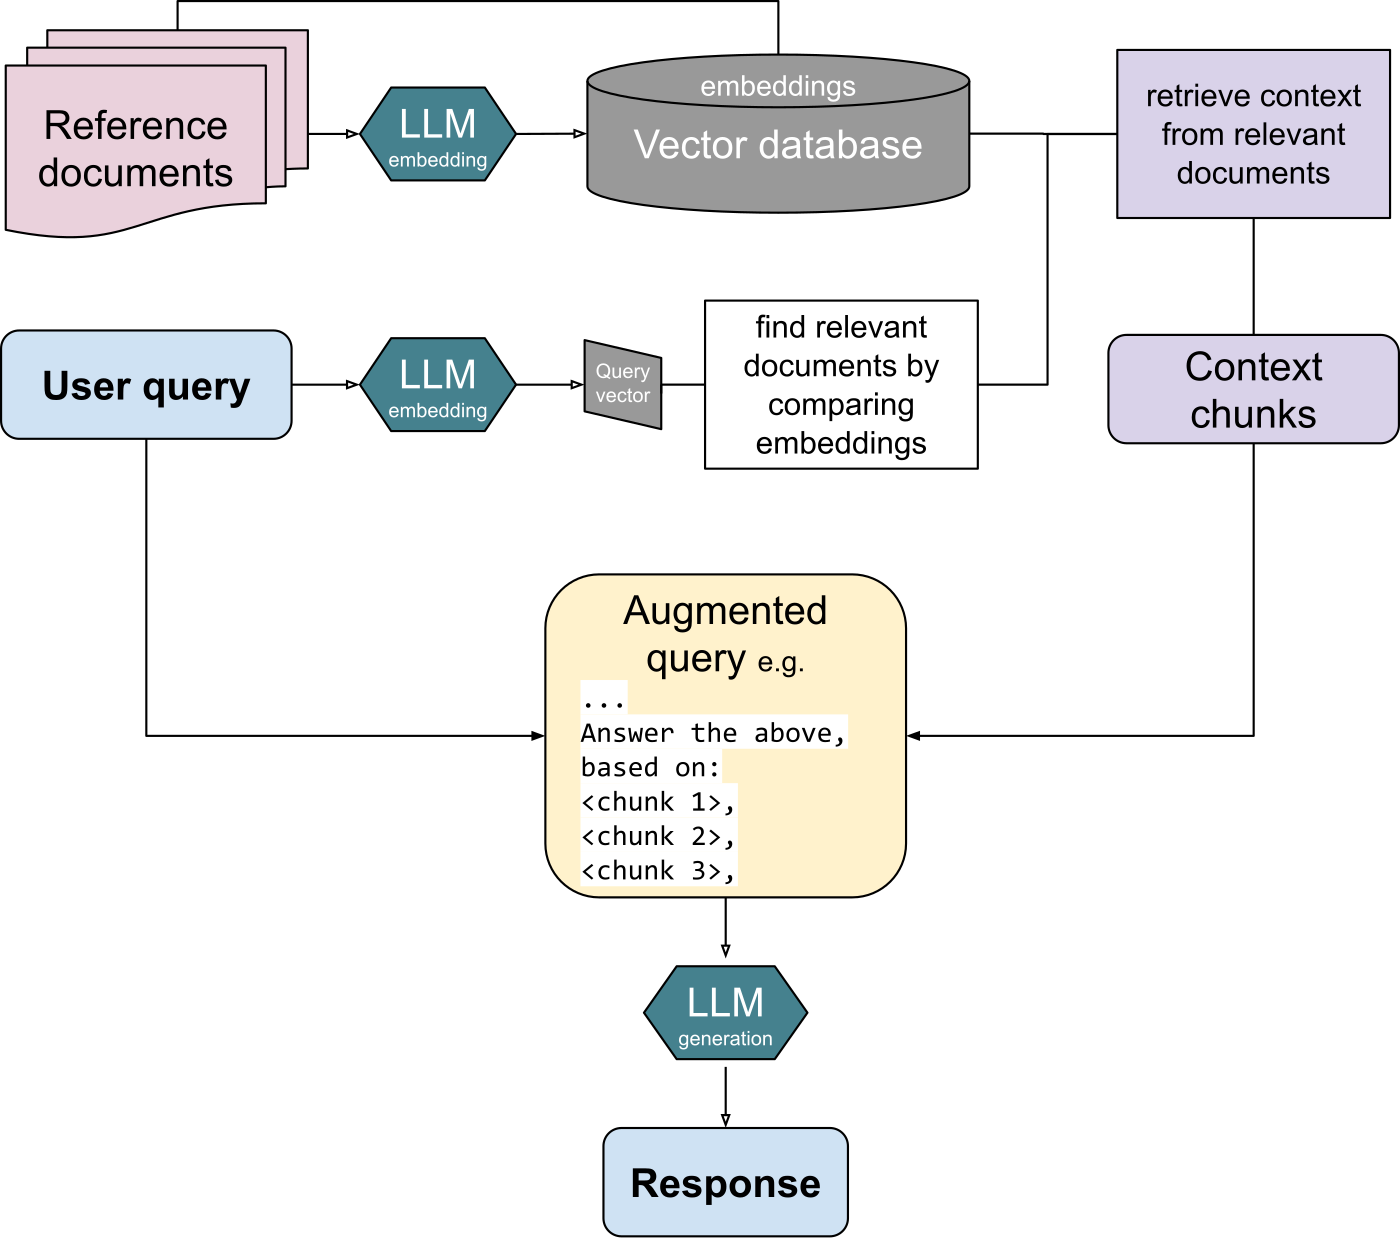
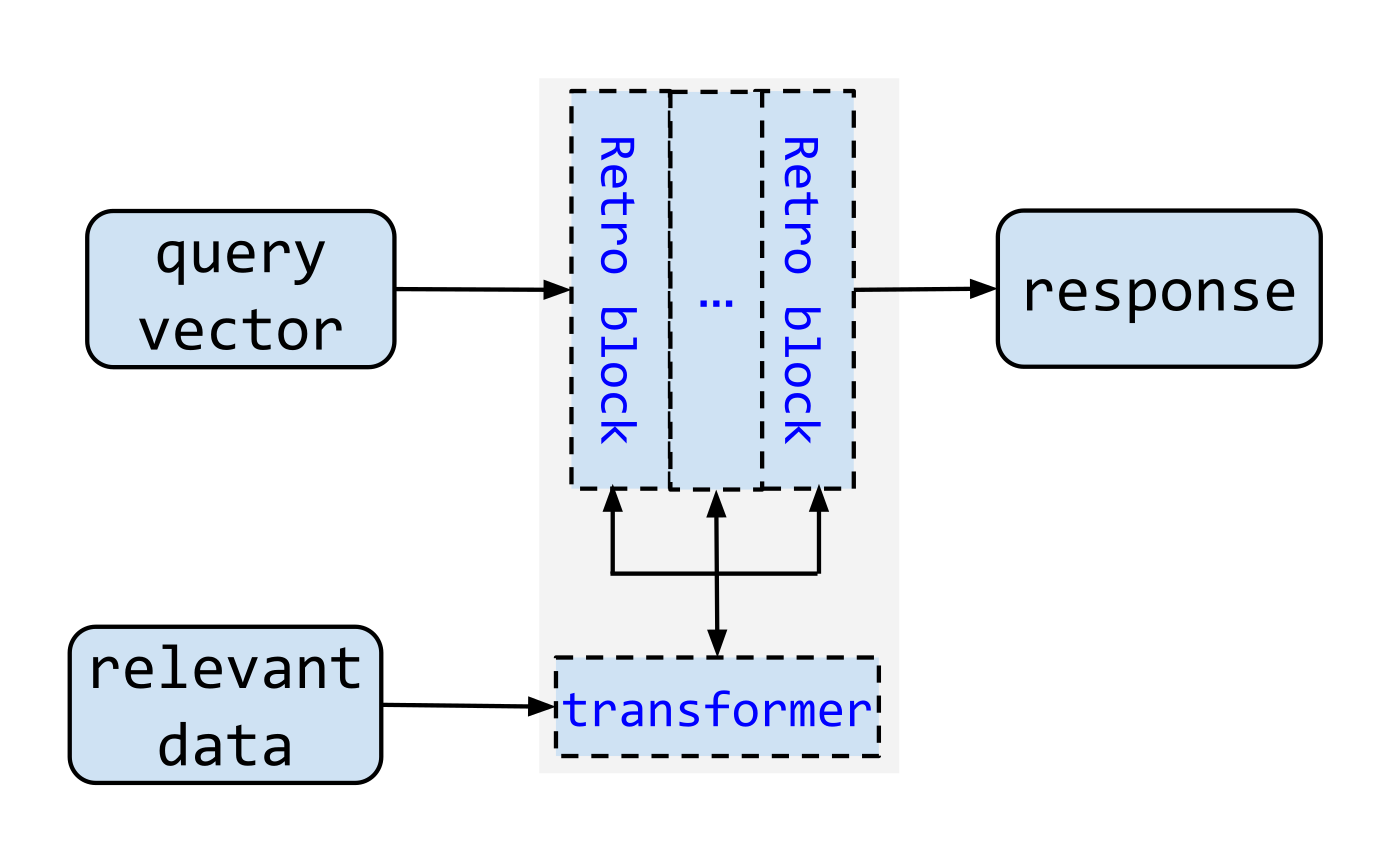
RAG, viết tắt của Retrieval-Augmented Generation, là kiến trúc kết hợp một bộ truy xuất thông tin với mô hình ngôn ngữ lớn. Thay vì chỉ dựa vào trọng số đã học sẵn, hệ thống RAG tìm các đoạn văn bản liên quan trong kho tri thức riêng, đưa chúng vào ngữ cảnh đầu vào rồi mới sinh câu trả lời.
Cách tiếp cận này được đề xuất trong bài báo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks của Patrick Lewis và cộng sự, xuất bản trên arXiv. Ý tưởng trung tâm rất đơn giản: LLM đóng vai trò sinh văn bản, còn retriever đóng vai trò kho tri thức có thể cập nhật.
Vấn đề mà RAG giải quyết rất rõ. LLM thuần túy lưu tri thức trong tham số nên không trích dẫn được nguồn, không cập nhật được kiến thức mới mà không huấn luyện lại, và dễ bịa thông tin. RAG đưa dữ liệu vào ngữ cảnh lúc chạy, nên câu trả lời có thể truy được về đúng tài liệu gốc.
Quy trình ba bước của RAG
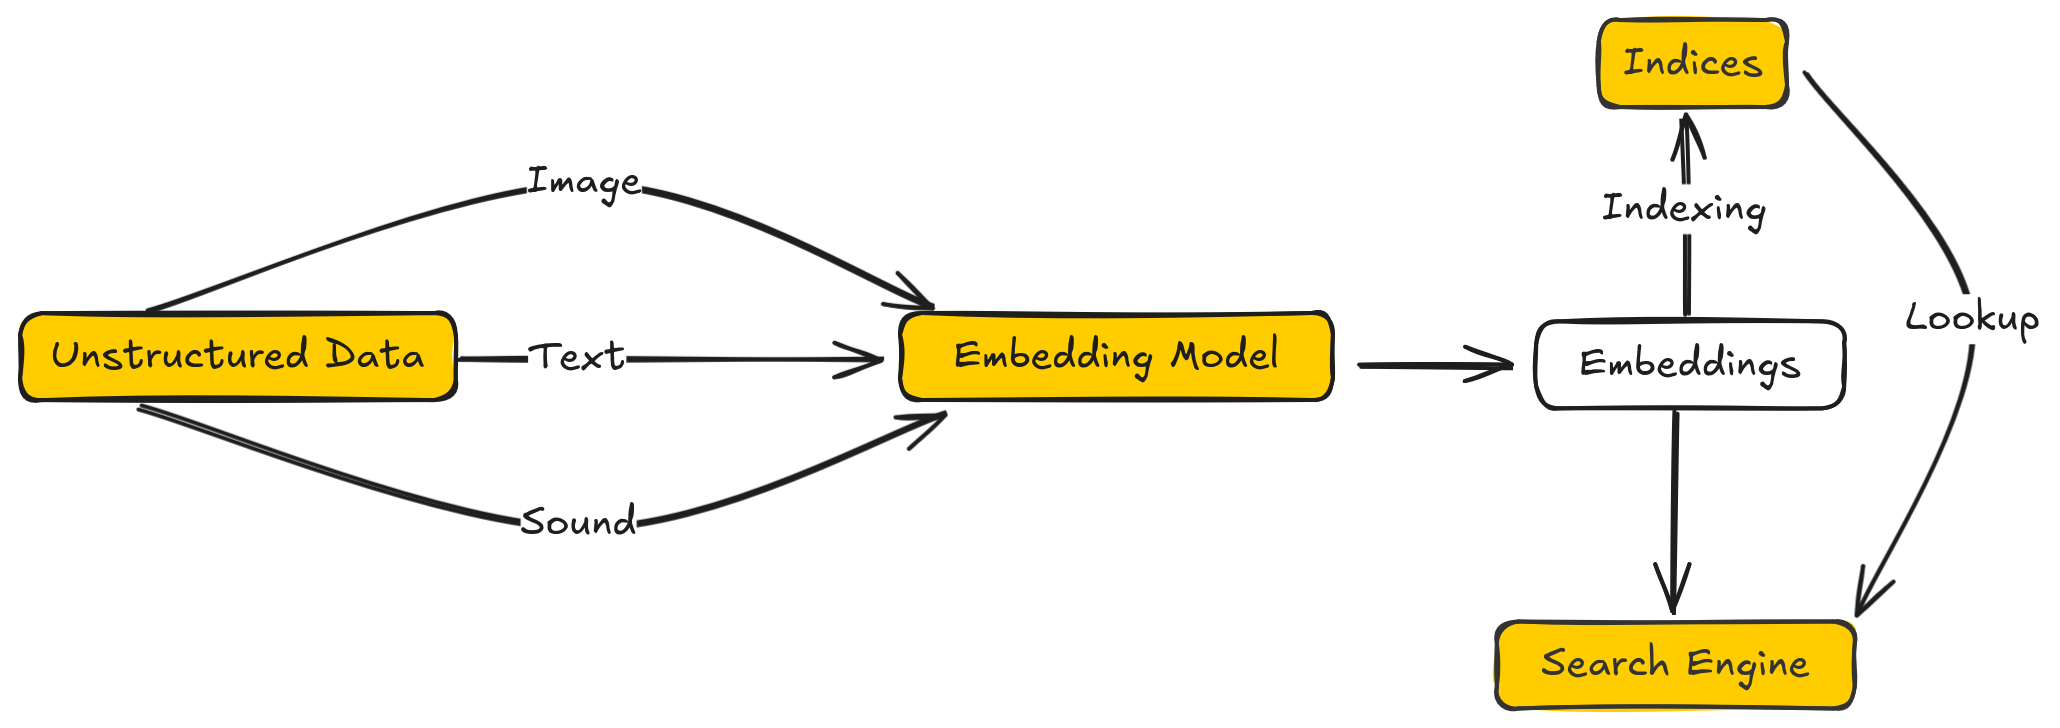
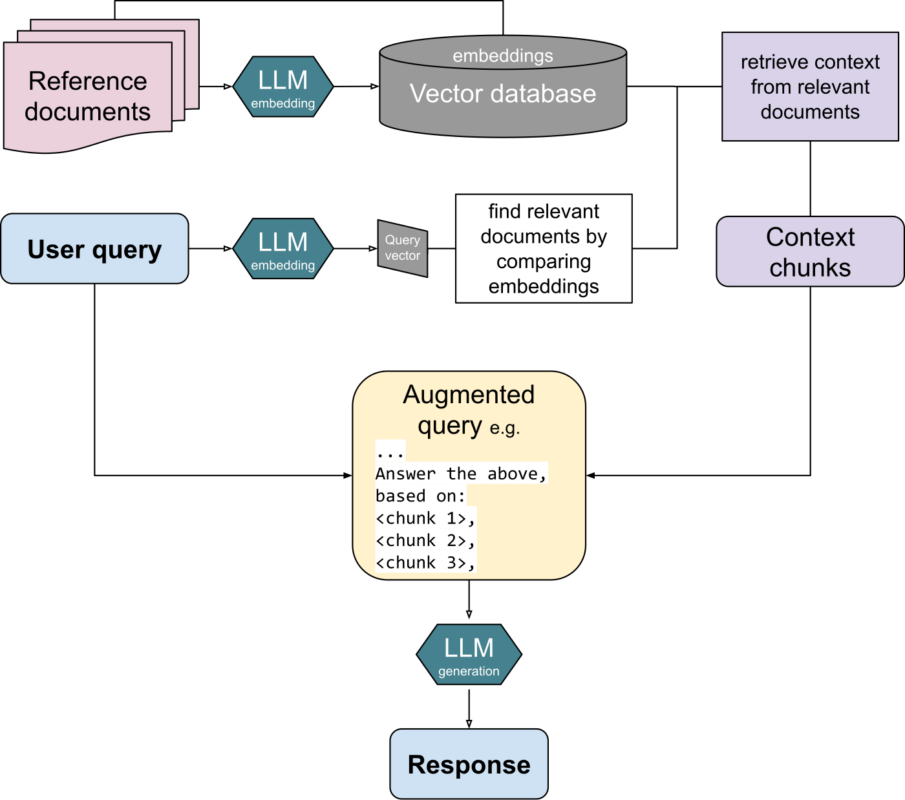
Bước 1, đánh chỉ mục. Tài liệu nguồn được chia thành các đoạn nhỏ, mỗi đoạn chuyển thành vector cố định bằng một mô hình embedding, ví dụ all-MiniLM-L6-v2. Các vector này lưu trong cơ sở dữ liệu vector như FAISS, Milvus hay Qdrant.
Bước 2, truy xuất. Khi có câu hỏi, câu hỏi cũng được chuyển thành vector rồi so khớp với các vector đã lưu để lấy ra k đoạn liên quan nhất. Trong thực tế thường có thêm bước rerank bằng mô hình chéo để sắp xếp lại kết quả.
Bước 3, sinh câu trả lời. Các đoạn văn bản được ghép vào prompt cùng với câu hỏi, LLM đọc chúng và sinh câu trả lời có dẫn nguồn. Đây là lý do các hệ thống RAG nghiệp vụ thường kèm phần trích dẫn tài liệu.
RAG khác fine-tune ở chỗ nào
Fine-tune thay đổi hành vi của mô hình và cần dữ liệu huấn luyện, thường là hàng nghìn ví dụ cho mỗi lần chạy. RAG không đụng vào trọng số mô hình, chỉ thay đổi dữ liệu đầu vào. Vì vậy cập nhật tri thức trong RAG chỉ là thêm tài liệu và đánh chỉ mục lại, có thể làm trong vài phút.
Đổi lại, RAG không cải thiện được khả năng của mô hình. Nếu câu hỏi đòi hỏi suy luận nhiều bước hoặc kiến thức không nằm trong kho tài liệu, hệ thống vẫn dễ sai. Vì vậy nhiều dự án dùng kết hợp cả hai: fine-tune cho hình thức câu trả lời và phong cách, RAG cho nội dung tri thức.
Các biến thể đáng chú ý
- Self-RAG: mô hình tự đánh giá chất lượng đoạn truy xuất và quyết định có cần tìm thêm hay không, thay vì luôn lấy số đoạn cố định.
- Corrective RAG: đánh giá chất lượng ngữ cảnh, nếu thấp thì chuyển sang tìm kiếm trên web thay vì sinh luôn.
- Agentic RAG: một tác nhân tự quyết định cần truy xuất bao nhiêu lần, truy xuất ở nguồn nào, rồi tổng hợp kết quả cho câu hỏi nhiều bước.
- RAG lai: kết hợp tìm kiếm theo từ khóa và tìm kiếm theo vector rồi hợp nhất, thường cho kết quả tốt hơn đơn thuần vector.
Những lỗi thường gặp khi triển khai
Chất lượng RAG phụ thuộc nặng vào cách chia đoạn tài liệu. Đoạn quá dài làm nhiễu ngữ cảnh, quá ngắn thì mất mạch nối ý. Vấn đề phổ biến thứ hai là retriever trả về đoạn có từ khoá trùng nhưng không trả lời được câu hỏi. Cách xử lý là thêm reranker và chỉ truy xuất một số đoạn vừa phải.
Một lỗi khác là để quá nhiều đoạn vào ngữ cảnh, làm loãng chỉ dẫn. Với hầu hết tình huống, ba đến năm đoạn là đủ. Ngoài ra cần cơ chế trích dẫn nguồn và đánh giá lại định kỳ, vì chất lượng RAG suy giảm dần khi kho tài liệu cũ hoặc câu hỏi thay đổi.
RAG và vector database
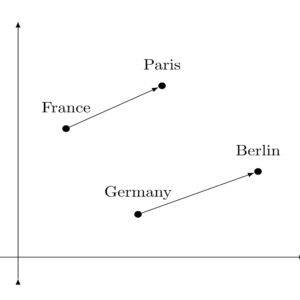
Mảnh ghép quan trọng nhất của RAG là cơ sở dữ liệu vector, nơi lưu trữ phần nhúng của mọi đoạn tài liệu. Thay vì so khớp chuỗi ký tự như tìm kiếm truyền thống, tìm kiếm vector đo góc giữa các vector và vì vậy bắt được cả nghĩa câu hỏi. Đây là lý do một truy vấn bằng tiếng Việt vẫn tìm được tài liệu viết bằng tiếng Anh nếu không gắn từ khoá chính xác.
Tuy nhiên tìm kiếm theo vector có điểm yếu: nó bỏ qua từ khoá chính xác như mã sản phẩm hay tên hàm. Hệ thống lai ghép kết quả của cả hai phương pháp, rồi rerank bằng mô hình chéo. Cách này tốn thêm một bước tính toán nhưng độ chính xác cải thiện rõ rệt trên kho tài liệu kỹ thuật.
Phần cơ bản để tự xây một hệ RAG gồm một mô hình embedding, một cơ sở dữ liệu vector, một LLM và lớp ghép nối. Các thư viện như LangChain hay LlamaIndex gói sẵn phần ghép nối, còn FAISS là lựa chọn mã nguồn mở phổ biến cho tìm kiếm vector cục bộ.
Đánh giá chất lượng một hệ RAG
Đo chất lượng RAG cần tách hai tầng. Tầng đầu là retriever: đo được bao nhiêu đoạn đúng nằm trong tập kết quả mong đợi, thường dùng recall@k và MRR. Tầng sau là generator: so câu trả lời với câu trả lời chuẩn, hoặc để con người chấm điểm theo tiêu chí trung thực, đúng ngữ cảnh, đủ đầy đủ.
Ngân sách suy luận cũng cần tính đến. Truy xuất thêm n đoạn làm dài ngữ cảnh, tăng độ trễ và chi phí mỗi câu trả lời. Trên hệ thống nghiệp vụ, tối ưu thường dừng ở việc trả về năm đoạn liên quan nhất, kèm một đoạn lịch sử hội thoại đã cắt gọn.
Vì sao RAG trở thành lựa chọn mặc định
RAG cân bằng tốt giữa độ chính xác, khả năng cập nhật tri thức và chi phí vận hành, nên nó là kiến trúc được chọn cho phần lớn ứng dụng hỏi đáp dựa trên tài liệu nội bộ.