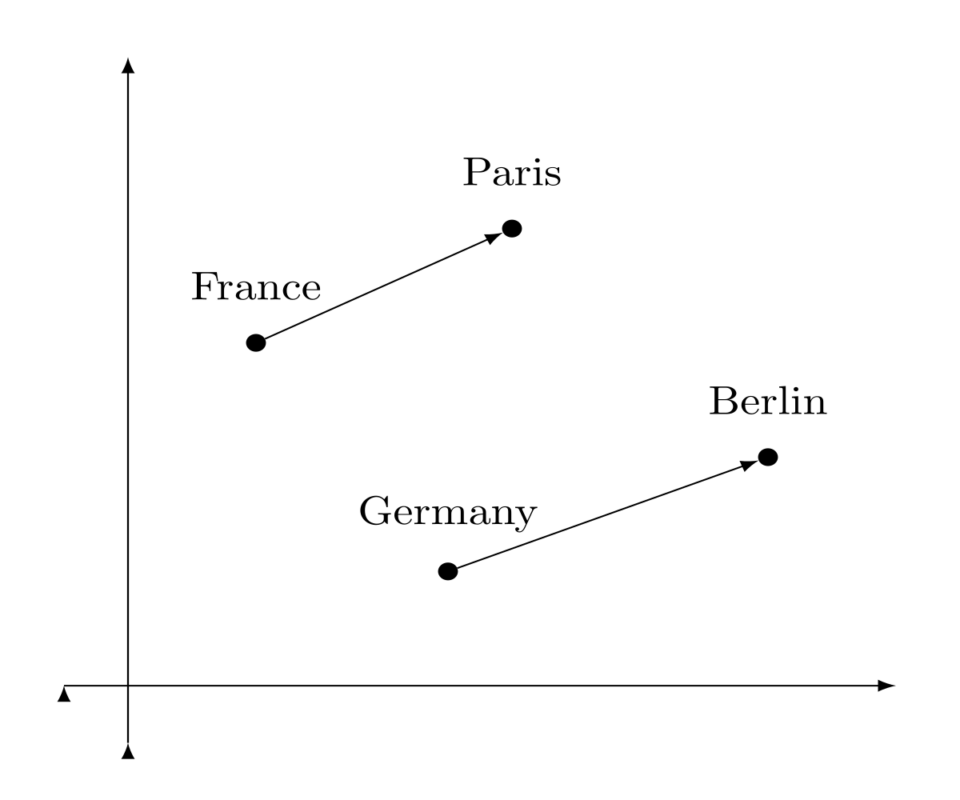
Word embedding (nhúng từ) là kỹ thuật chuyển đổi từ ngữ thành các vector số trong không gian đa chiều, giúp máy tính hiểu được ngữ nghĩa và mối quan hệ giữa các từ. Thay vì xử lý từ như những ký tự rời rạc, mô hình nhúng ánh xạ mỗi từ thành một điểm trong không gian vector, trong đó các từ mang ý nghĩa tương tự nằm gần nhau. Đây là nền tảng của hầu hết các ứng dụng xử lý ngôn ngữ tự nhiên hiện đại.
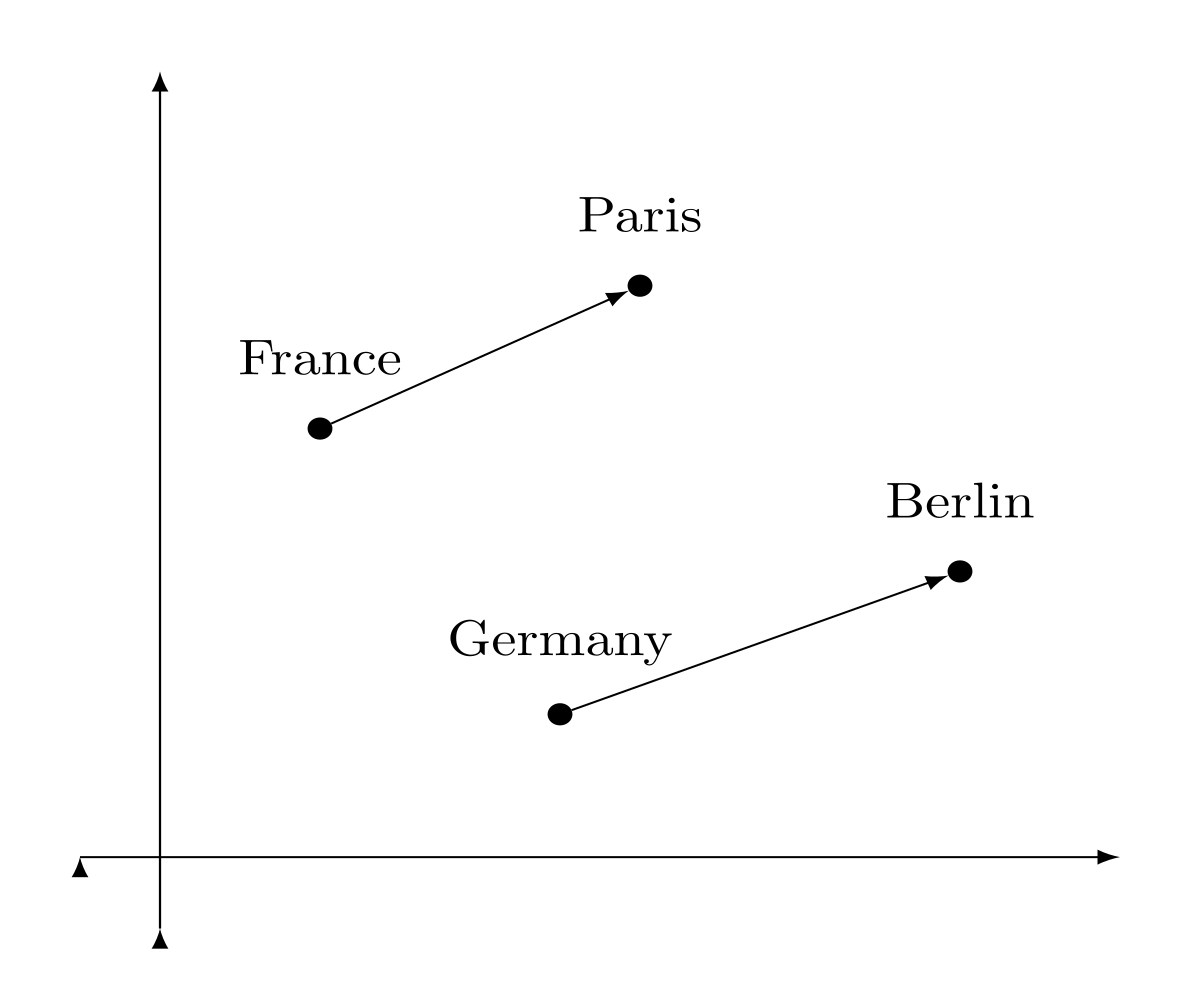
Khái niệm này trở nên phổ biến nhờ bài báo Word2Vec của Google năm 2013, cho thấy phép toán trên vector có thể nắm bắt mối quan hệ ngữ nghĩa: vector của “vua” trừ đi vector “đàn ông” cộng vector “phụ nữ” cho kết quả rất gần với vector “nữ hoàng”. Khả năng này mở ra những ứng dụng mà trước đó gần như không thể với cách xử lý từ kiểu truyền thống.
Vì sao cần word embedding?
Cách xử lý từ cổ điển gán mỗi từ một số nguyên riêng biệt theo thứ tự trong từ điển. Cách này có hai vấn đề lớn. Thứ nhất, hai từ gần nghĩa với nhau lại không có quan hệ gì trong không gian số, nên mô hình không tự suy ra được “bánh mì” và “bánh mì tươi” liên quan. Thứ nhất, kích thước vector one-hot bằng số lượng từ trong từ điển, khiến dữ liệu thưa và phình to nhanh chóng. Thứ hai, mô hình học được mối quan hệ ngữ nghĩa phải qua dữ liệu huấn luyện cực lớn, mỗi mối quan hệ phải được thấy trực tiếp trong tập văn bản.
Word embedding giải quyết cả hai bằng cách học phân bố ngữ nghĩa một cách gián tiếp. Mô hình được huấn luyện trên hàng tỷ câu, không cần thấy trực tiếp cặp “bánh mì – bánh mì tươi”, nhưng vẫn đặt hai từ này gần nhau vì chúng thường xuất hiện trong cùng ngữ cảnh. Nguyên lý “những từ xuất hiện trong cùng ngữ cảnh thì có nghĩa gần nhau” chính là giả định phân bố của Mikolov và là nền tảng lý thuyết cho toàn bộ nhánh kỹ thuật này.
Các mô hình nhúng từ phổ biến
Có hai nhánh chính: mô hình tĩnh (static) và mô hình ngữ cảnh (contextual).
Word2Vec
Word2Vec dùng mạng nơ-ron nông một tầng ẩn để học vector. Có hai kiến trúc: CBOW dự đoán từ đích từ ngữ cảnh xung quanh, và Skip-gram ngược lại dự đoán ngữ cảnh từ từ đích. Skip-gram thường cho kết quả tốt hơn với tập dữ liệu nhỏ, còn CBOW nhanh hơn và ổn định với tập dữ liệu lớn.
GloVe
GloVe (Global Vectors) tiếp cận khác: thay vì dự đoán từ, nó huấn luyện trên ma trận đồng xuất hiện toàn cục, đo tần suất một từ xuất hiện cạnh các từ khác trong toàn bộ tập dữ liệu. Vector cuối cùng là tổ hợp trọng số của các thành phần này, cho phép tận dụng cả thống kê toàn cục lẫn cấu trúc cục bộ.
FastText và mô hình ngữ cảnh
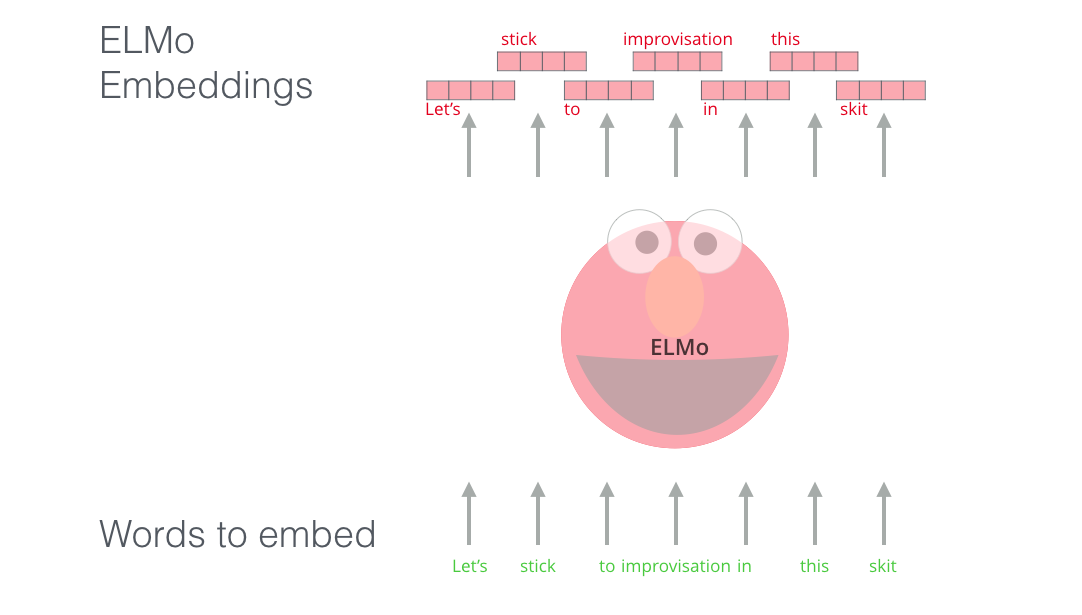
FastText bổ sung phân rã từ thành n-gram ký tự, nhờ đó xử lý được từ ghép và từ chưa từng xuất hiện trong từ điển. Về nhánh ngữ cảnh, ELMo dùng LSTM hai chiều, BERT áp dụng cơ chế attention hai chiều trong transformer, còn GPT chỉ dùng attention một chiều để phù hợp với bài toán sinh văn bản tuần tự.
Khác biệt cốt lõi nằm ở chỗ mô hình tĩnh gán một vector duy nhất cho mỗi từ, còn mô hình ngữ cảnh tạo vector mới tùy thuộc câu chứa nó. Chính vì vậy BERT phân biệt được “bank” trong “river bank” và “bank account”, điều mà Word2Vec không thể làm.

Ứng dụng thực tế
Word embedding là xương sống của hầu hết đường ống xử lý ngôn ngữ tự nhiên hiện đại:
- Phân loại văn bản: dùng vector trung bình của câu làm đặc trưng cho phân loại chủ đề hoặc phát hiện spam.
- Tìm kiếm ngữ nghĩa: so sánh độ tương đồng cosine giữa vector truy vấn và vector tài liệu, cho kết quả liên quan dù không khớp từ khóa chính xác.
- Dịch máy: kiến trúc encoder-decoder dùng embedding làm đầu vào để dịch giữa nhiều ngôn ngữ.
- Hệ thống hỏi đáp: so khớp vector câu hỏi với các đoạn văn bản chứa câu trả lời.
- Gợi ý nội dung: đo độ tương đồng giữa sản phẩm và lịch sử tìm kiếm của người dùng.
Khi triển khai, các nhà phát triển thường chọn thư viện như Gensim cho Word2Vec và FastText, Hugging Face Transformers cho BERT, RoBERTa, hoặc spaCy cho các vector có sẵn. Lựa chọn phụ thuộc vào bài toán: vector tĩnh nhanh, nhẹ, phù hợp thiết bị biên và hệ thống nhúng; vector ngữ cảnh chính xác hơn nhưng tốn nhiều tài nguyên tính toán hơn.
Nguồn tham khảo: Wikipedia – Word embedding, The Illustrated BERT, Efficient Estimation of Word Representations in Vector Space.