Vấn đề memory trong AI agent hiện đại
AI agent ngày nay đối mặt với một hạn chế cố hữu: context window hữu hạn. Mô hình ngôn ngữ lớn chỉ nhớ một đoạn hội thoại gần đây, sau đó thông tin cũ bị “quên” hoàn toàn. Điều này tạo ra bài toán khó cho các ứng dụng cần duy trì ngữ cảnh dài hạn — hỗ trợ khách hàng, quản lý dự án, hay phân tích dữ liệu liên tục.
Có ba lớp memory chính trong kiến trúc AI agent ngày nay: working memory (cache ngắn hạn trong context window), retrieval memory (RAG kết hợp vector database), và persistent memory (lưu trữ đa phiên với graph hoặc SQL). Mỗi lớp giải quyết một phần của bài toán nhớ dài hạn, nhưng không có giải pháp nào hoàn hảo nếu đứng một mình.
Context window và working memory
Working memory chính là context window của mô hình — nơi lưu token đầu vào và đầu ra trong một lượt inference. Kích thước hiện đại của GPT-4o hay Claude lên đến 128K-200K token, tương đương khoảng 100-150 trang văn bản. Đủ cho một cuộc hội thoại dài, nhưng không đủ cho lịch sử người dùng trải dài vài tháng.
Hạn chế lớn nhất: attention degradation. Khi context dài, mô hình dễ “quên” thông tin ở đầu chuỗi, thậm chí token gần cuối bị suy giảm trọng số. Nhiều nghiên cứu chỉ ra hiện tượng “lost in the middle” — thông tin ở giữa context ít được chú ý nhất.
Retrieval-Augmented Generation và vector DB
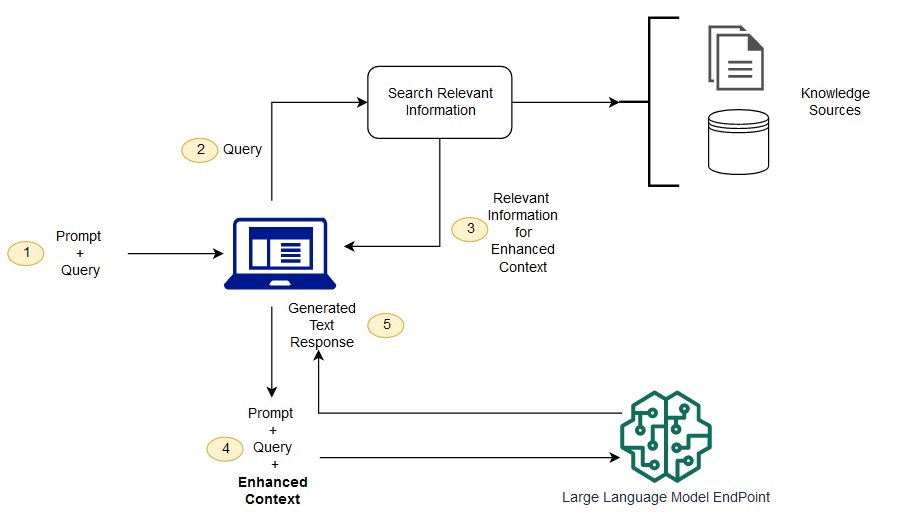
RAG ra đời như cách tiếp cận thông minh: thay vì nhét toàn bộ dữ liệu vào context, agent chỉ truy xuất thông tin liên quan khi cần. Vector database lưu trữ embedding của tài liệu, cho phép tìm kiếm semantic theo mức độ liên quan thay vì từ khóa đơn thuần.
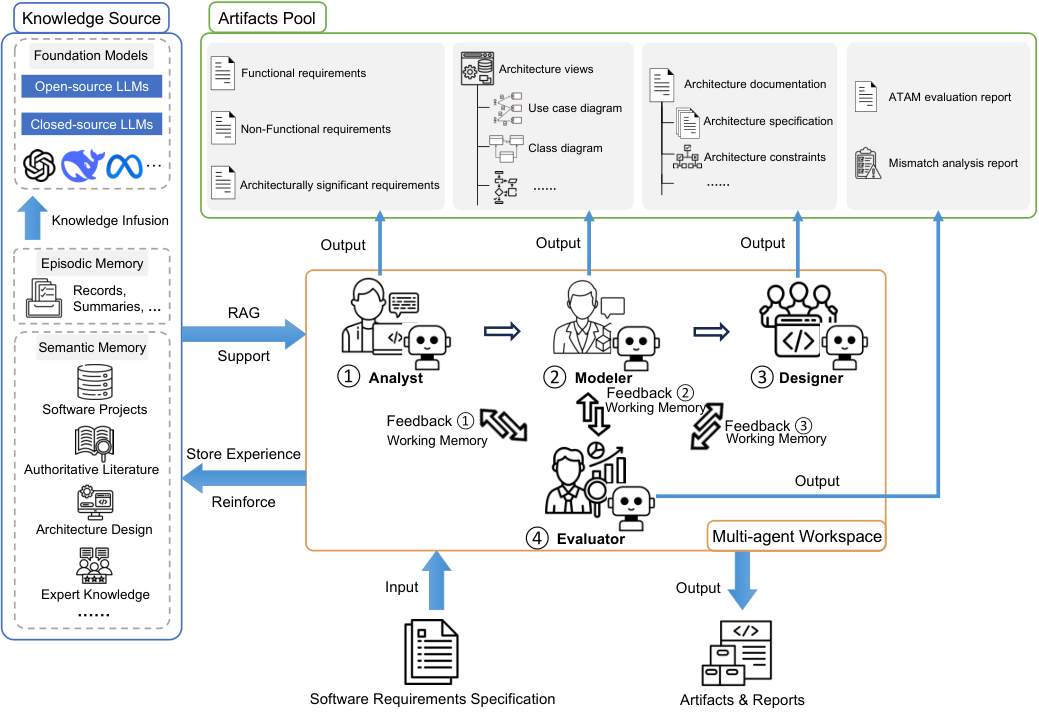
Công cụ phổ biến: Pinecone, Weaviate, Qdrant, hay ChromaDB. Trong môi trường self-hosted, Qdrant kết hợp FastAPI và Docker triển khai nhanh, phù hợp cho startup. Một số agent framework như LangChain hay LlamaIndex tích hợp sẵn RAG pipeline, giảm boilerplate code đáng kể.
Persistent memory: lưu trữ đa phiên
Nếu working memory chỉ sống trong một phiên, persistent memory cho phép agent nhớ người dùng qua nhiều lần tương tác. Cách tiếp cận phổ biến hiện nay là knowledge graph kết hợp entity extraction — lưu mối quan hệ giữa người dùng, sở thích, lịch sử mua hàng dưới dạng đồ thị.
Graph database như Neo4j hay FalkorDB cho phép truy vấn quan hệ phức tạp, ví dụ: “tất cả khách hàng đã mua sản phẩm X trong 30 ngày và có đánh giá trên 4 sao”. Dữ liệu này được cập nhật liên tục khi agent tương tác, tạo nên bộ nhớ sống và cá nhân hóa theo thời gian thực.
Tích hợp multi-agent memory
Khi nhiều agent phối hợp, memory trở thành thách thức lớn hơn. Mỗi agent cần chia sẻ trạng thái mà không gây ra race condition hay dữ liệu mâu thuẫn. Một số hệ thống sử dụng event sourcing — ghi lại mọi thay đổi dưới dạng event log, cho phép agent khác phục hồi trạng thái bất cứ lúc nào.
Crypto wallet agent là ví dụ điển hình: ví agent cần nhớ số dư, lịch sử giao dịch, và khóa bí mật qua nhiều phiên. Nếu persistent memory mất, người dùng mất quyền truy cập tài sản. Do đó, encryption at rest và backup cold storage trở thành yếu tố bắt buộc, không phải tùy chọn.
Công cụ và framework hiện có
Nhiều framework mã nguồn mở đang định hình tiêu chuẩn cho AI agent memory. Mem0 tập trung vào personalization qua graph-based memory, Zep cung cấp long-term memory với encryption, còn Letta (trước đây là MemGPT) mô phỏng kiến trúc memory hierarchical giống hệ điều hành — paging giữa RAM và ổ cứng.
Việc lựa chọn công cụ phụ thuộc vào use case. Nếu ứng dụng cần cá nhân hóa đơn giản, một vector DB kết hợp metadata đủ dùng. Nếu cần reasoning phức tạp trên lịch sử dài, knowledge graph là lựa chọn tối ưu. Đừng over-engineer từ đầu — bắt đầu với RAG cơ bản, scale dần khi nhu cầu tăng.
Bài viết tham khảo nghiên cứu từ arXiv: Augmented Language Models và tài liệu chính thức của LlamaIndex.