Kiến trúc Transformer là một mô hình mạng nơ ron sâu dựa trên cơ chế self-attention thay vì dùng các lớp lặp lại như RNN hay LSTM. Bởi vì khả năng tính toán song song trên toàn bộ chuỗi đầu vào, Transformer đã trở thành nền tảng cho hầu hết các mô hình ngôn ngữ lớn hiện đại như GPT, BERT và các biến thể khác, đồng thời lan tỏa sang thị giác máy tín và xử lý âm thanh.
Năm 2017, một nhóm nghiên cứu tại Google công bố bài báo “Attention Is All You Need” giới thiệu kiến trúc Transformer, mô tả cách tự-attention (self-attention) và positional encoding cho phép xử lý song song, từ đó vượt qua những hạn chế nội tại của các mạng lặp lại. Trước đó, các mô hình xử lý chuỗi thường dùng RNN và LSTM, nhưng chúng đều chịu hạn chế về tính tuần tự, khiến cho việc xử lý chuỗi dài tốn thời gian và gặp vấn đề mất gradient khi chiều dài tăng.
Cơ chế self-attention là trái tim
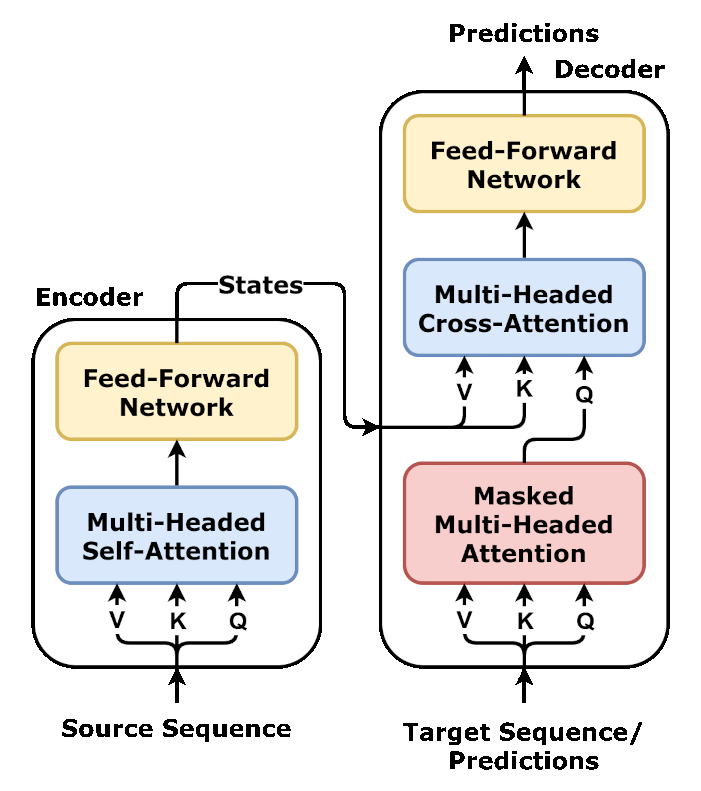
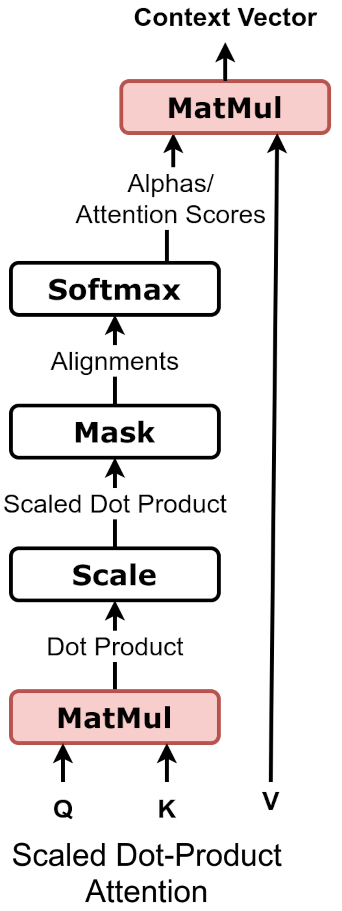
Trong một lớp self-attention, mỗi token (số hoá từ một từ hoặc một mảnh ảnh) sẽ tính toán ba vector Query (Q), Key (K) và Value (V). Điểm attention giữa hai token được tính bằng tích vô hướng của Q với K, chia cho căn bậc hai của chiều vector K để chuẩn hoá, rồi qua hàm softmax để có trọng số. Cuối cùng, đầu ra của mỗi token là tổng có trọng số của các vector V với trọng số vừa tính.
Để mô hình có thể tập trung vào các phần khác nhau của chuỗi cùng một lúc, kiến trúc này dùng multi-head attention: thay vì một bộ Q/K/V duy nhất, chúng ta có h (thường là 8 hoặc 12) bộ Q/K/V song song, mỗi bộ tập trung vào một subspace khác nhau của không gian đặc trưng. Kết quả là các đầu ra của h bộ được nối lại với nhau để có chiều rộng bằng h lần chiều rộng của một bộ.
Cấu trúc lớp và block
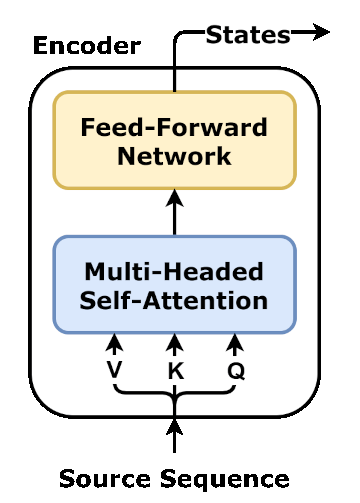
Một lớp Transformer tiêu chuẩn gồm hai phần chính: một khối multi-head attention và một mạng feed-forward neural network (FFNN) có hai lớp tuyến tính với hàm kích hoạt ReLU ở giữa. Cả hai phần đều được bao bọc bởi kết nối dư bằng (residual connection) và chuẩn hóa lớp (layer normalization). Kết nối dư bằng giúp tín hiệu lan truyền qua nhiều lớp mà không bị tiêu tan, trong khi chuẩn hóa lớp giữ cho mức độ kích hoạt ổn định qua các lớp.
Block encoder đơn giản bao gồm một lớp multi-head attention và một lớp FFNN, mỗi lần chạy qua sẽ cho ra một biểu diễn trung gian giàu có thông tin về context. Block decoder tương tự nhưng thêm một lớp attention phụ đề (cross-attention) để nhìn vào đầu ra của encoder. Hai loại block này được xếp chồng lên nhau để tạo thành encoder đầy đủ và decoder đầy đủ.
Positional encoding được thêm vào mỗi token ở đầu giai đoạn đầu vào, để mô hình biết được vị trí của token trong chuỗi vì self-attention không nhận biết thứ tự. Các kiểu positional encoding phổ biến bao gồm sinusoidal (công thức có sin và cos) và positional embedding được học trong suốt quá trình huấn luyện.
Các biến thể kiến trúc
Tuỳ thuộc vào mục đích sử dụng, người ta có thể giữ lại một phần của kiến trúc hoàn chỉnh:
- Encoder-only (ví dụ: BERT): chỉ có phần encoder, tối ưu cho các bài toán hiểu ngôn ngữ như phân loại và trả lời câu hỏi.
- Decoder-only (ví dụ: GPT series): chỉ có phần decoder, được thiết kế để sinh văn bản tự-hồi quy (autoregressive generation) – chính là cách hoạt động của hầu hết các mô hình ngôn ngữ lớn.
- Encoder-decoder (ví dụ: T5, BART): có cả encoder và decoder, thích hợp cho các bài toán sequence-to-sequence như tóm tắt văn bản và dịch máy.
Nhờ khả năng tính toán song song và mở rộng tốt, Transformer đã lan tỏa ra nhiều lĩnh vực khác ngoài xử lý ngôn ngữ tự nhiên.
Ứng dụng rộng rãi trong trí tuệ nhân tạo hiện đại
- Xử lý ngôn ngữ tự nhiên: hầu hết các mô hình ngôn ngữ lớn như GPT-4, Claude, Gemini đều dựa trên kiến trúc decoder-only Transformer.
- Giải thị giác máy tính: mô hình Vision Transformer (ViT) áp dụng cùng nguyên lý trên những mảnh ảnh, đạt hiệu suất gần bằng các mạng tích chập trong nhiều tác vụ phân loại và phát hiện đối tượng.
- Xử lý âm thanh và tín hiệu: mô hình như Whisper dùng Transformer để chép lại lời nói và trích xuất đặc trưng từ tín hiệu số, đạt kết quả tốt trong môi trường ồn ào.
- Học tăng cường và robotics: Transformer được dùng để mô hình hóa chính sách và tương tác trong môi trường phức tạp, từ chơi cờ vua tới điều khiển cánh tay robot.
- Nhiều modal (multimodal learning): mô hình như GPT-4V kết hợp ảnh và văn bản bằng cách đưa cả hai vào cùng một không gian embedding, cho phép trả lời câu hỏi dựa trên cả hai modality.
Ưu điểm, thách thức và hướng phát triển
Ưu điểm lớn nhất của Transformer là khả năng tính toán song song, cho phép huấn luyện trên hàng tỷ tham số trong thời gian hợp lý. Nhưng điều này đi kèm với tài nguyên bộ nhớ cao vì ma trận attention có kích thước bội phương theo độ dài chuỗi (O(n²)). Nhiều hướng nghiên cứu đang cố gắng giảm bớt chi phí này, chẳng hạn như dùng attention thưa (sparse attention), attention tuyến tính (linear attention) hoặc quantization.
Một thách thức khác là nhu cầu về dữ liệu lớn để huấn luyện hiệu quả, mặc dù các kỹ thuật như transfer learning và fine-tuning giúp giảm bớt tải này. Trong thực tế, hầu hết các mô hình Transformer hiện nay đều được khởi tạo từ một checkpoint đã được huấn luyện trước trên một corpus khổng lồ, rồi mới được điều chỉnh cho ứng dụng cụ thể.
Kết luận
Kiến trúc Transformer không chỉ là một cải tiến kỹ thuật mà là một bước đột phá trong cách chúng ta xây dựng hệ thống trí tuệ nhân tạo. Từ việc cho phép mô hình ngôn ngữ lớn hiểu và tạo ra văn bản tự nhiên, tới việc cho phép máy “nhìn” và “nghe” được thế giới xung quanh, Transformer đã chứng minh mình là nền tảng không thể thiếu của kỷ niệm AI hiện nay.
Nếu muốn tìm hiểu thêm chi tiết, bạn có thể tham khảo bài viết gốc Attention Is All You Need trên arXiv, hoặc đọc tổng quan về Kiến trúc Transformer trên Wikipedia.