Kimi K2 là mô hình ngôn ngữ lớn (LLM) mã nguồn mở của Moonshot AI, được phát hành với kiến trúc Mixture-of-Experts (MoE) quy mô 1 nghìn tỷ (1T) tham số tổng cộng và 32 tỷ tham số được kích hoạt mỗi lần suy luận. Mô hình này đánh dấu bước tiến quan trọng trong việc tối ưu hóa hiệu suất cho các tác vụ agentic — khả năng sử dụng công cụ, lập luận tự chủ và giải quyết vấn đề phức tạp mà không cần can thiệp liên tục của con người.
Kiến trúc và quy mô mô hình
Kimi K2 sử dụng kiến trúc Mixture-of-Experts (MoE) với 384 chuyên gia (experts), trong đó 8 chuyên gia được chọn cho mỗi token. Cấu hình chi tiết:
- Tổng tham số: 1T (1 nghìn tỷ)
- Tham số kích hoạt: 32B (32 tỷ)
- Số layer: 61 (bao gồm 1 layer dense)
- Chiều ẩn attention: 7.168
- Chiều ẩn MoE mỗi chuyên gia: 2.048
- Số attention heads: 64
- Shared experts: 1
- Vocabulary size: 160K
- Context length: 128K tokens
- Cơ chế attention: MLA (Multi-head Latent Attention)
- Activation function: SwiGLU
Huấn luyện với MuonClip Optimizer
Điểm đột phá của Kimi K2 là việc áp dụng MuonClip optimizer — biến thể của Muon optimizer — ở quy mô chưa từng có. Muon (Momentum Orthogonal Newton) được thiết kế để huấn luyện ổn định các mô hình siêu lớn bằng cách duy trì tính trực giao của ma trận trọng số. Kimi K2:
- Được pre-train trên 15,5 nghìn tỷ (15,5T) tokens
- Đạt ổn định huấn luyện tuyệt đối (zero training instability) — lần đầu tiên ở quy mô 1T tham số
- Phát triển kỹ thuật MuonClip mới để giải quyết bất ổn khi scale up
So với AdamW truyền thống, MuonClip giảm đáng kể memory overhead và tăng tốc hội tụ, cho phép Moonshot AI train mô hình 1T params với chi phí tính toán hợp lý.
Hai biến thể mô hình
Moonshot AI phát hành hai phiên bản:
| Biến thể | Mô tả | Phù hợp cho |
|---|---|---|
| Kimi-K2-Base | Foundation model, chưa qua post-training | Nghiên cứu, fine-tuning tùy chỉnh, custom solutions |
| Kimi-K2-Instruct | Post-trained cho chat và agentic tasks | Drop-in chat, autonomous agents, coding, reasoning |
Kimi-K2-Instruct là mô hình “reflex-grade” — phản ứng nhanh mà không cần quy trình suy nghĩ dài (long thinking) như các mô hình reasoning chuyên biệt.
Kết quả benchmark ấn tượng
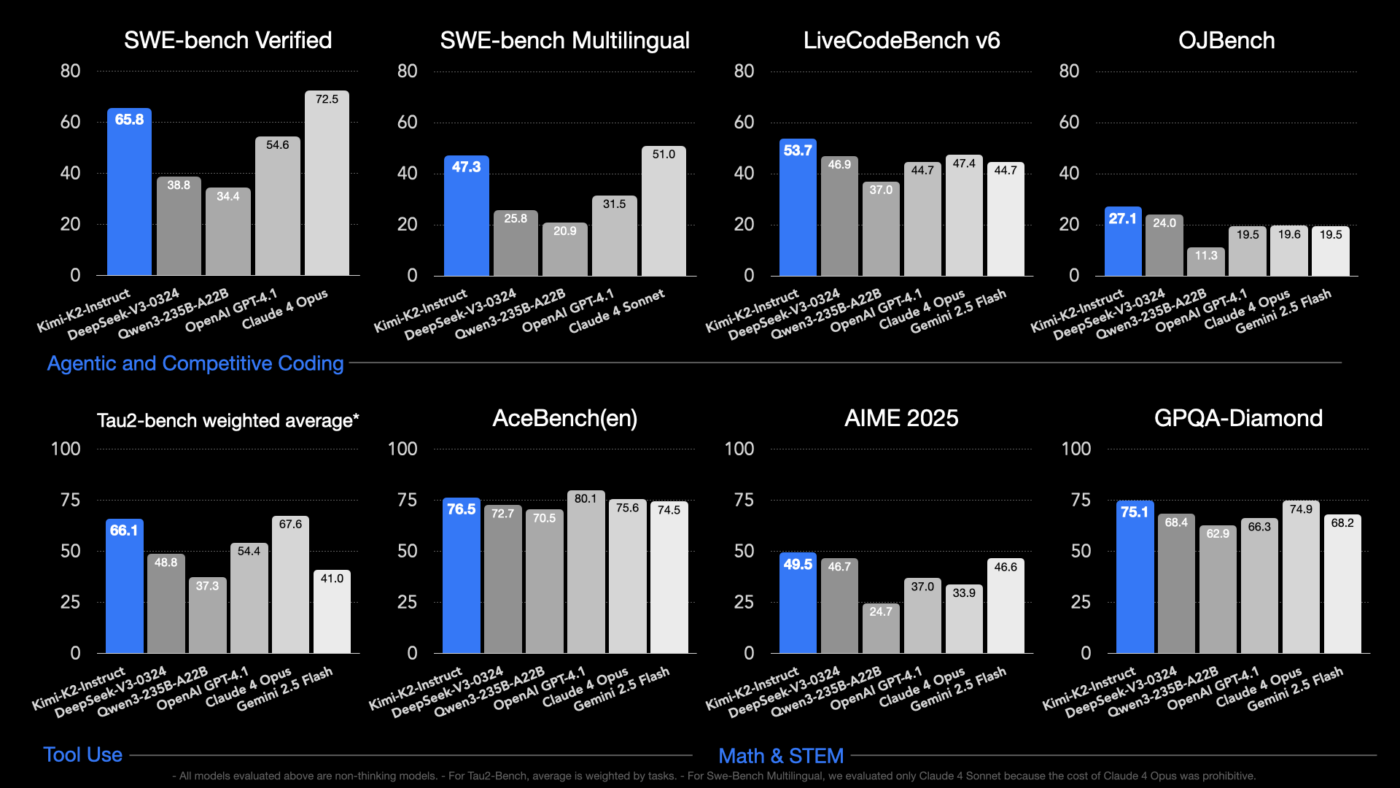
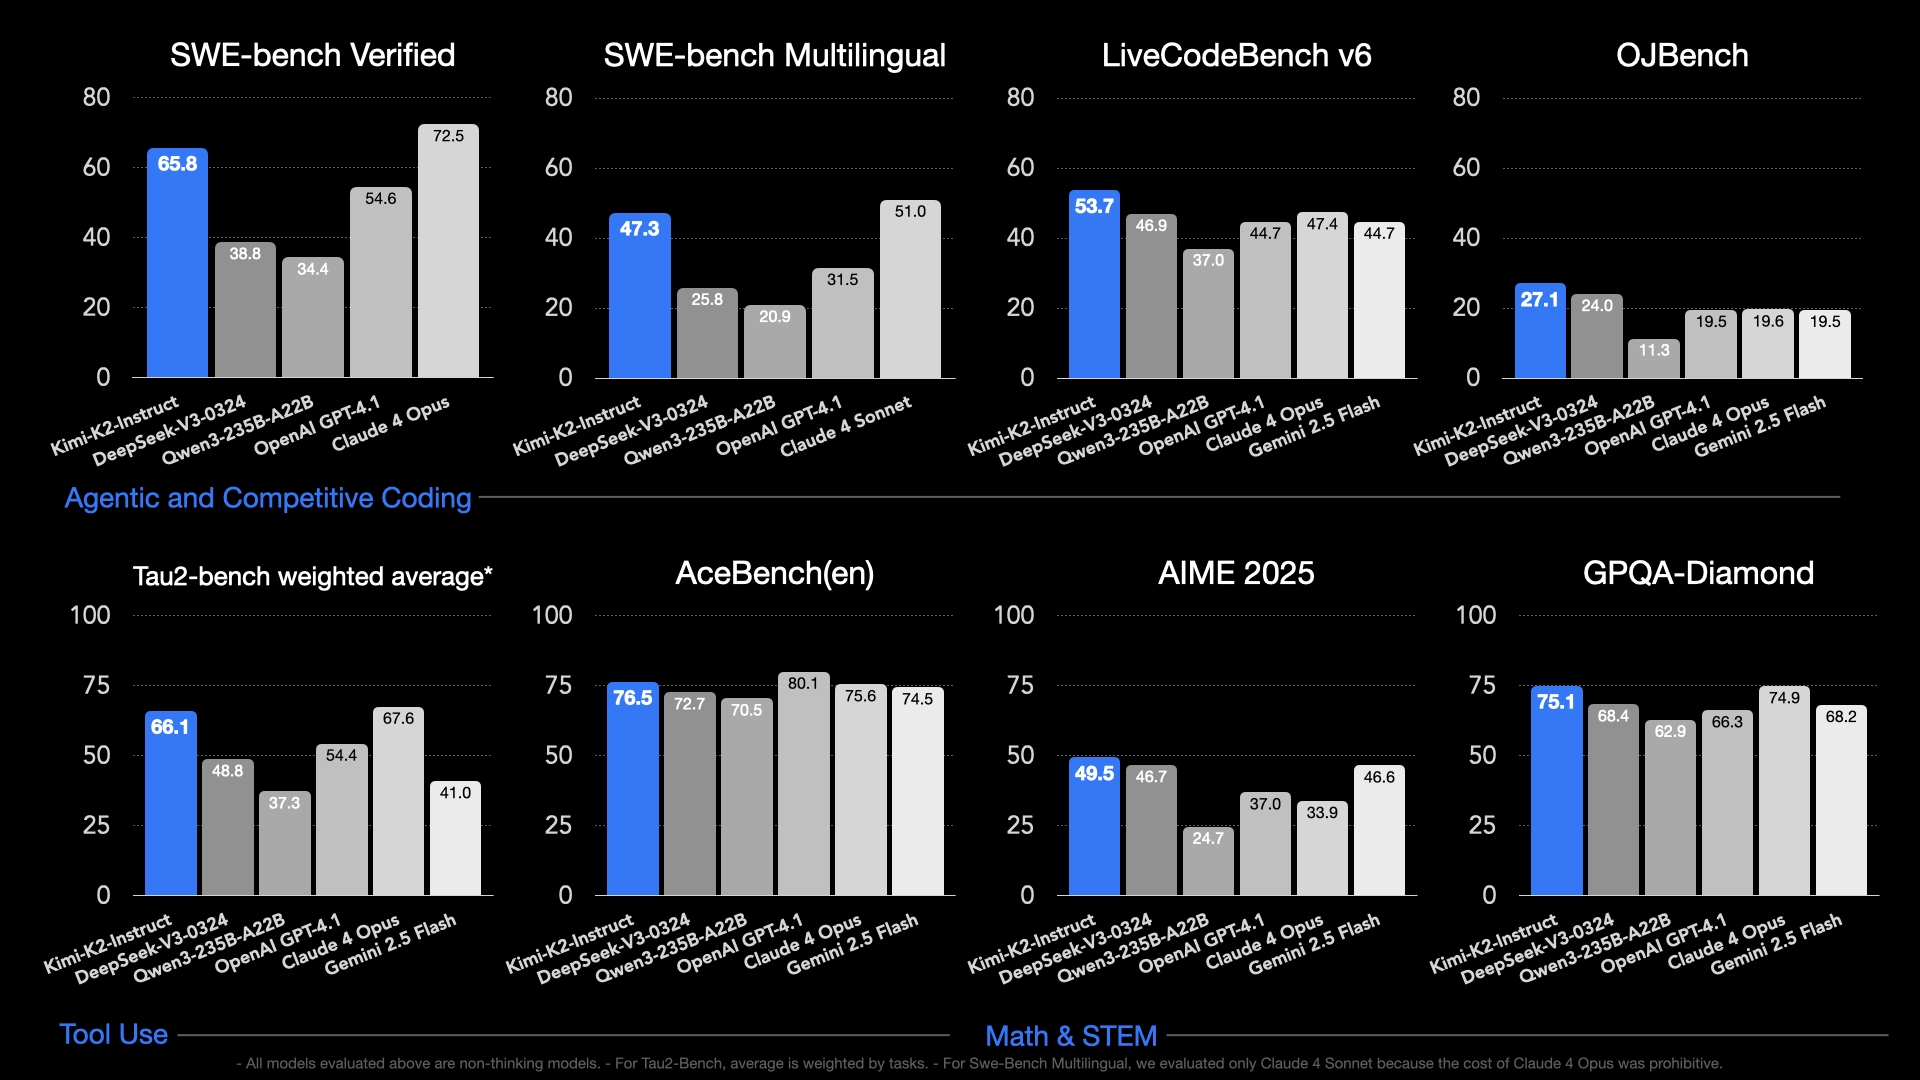
Kimi K2 Instruct vượt trội trên nhiều benchmark coding và agentic so với các đối thủ mã nguồn mở và đóng:
- LiveCodeBench v6 (Aug 2024 – May 2025): 53,7% Pass@1 — cao hơn DeepSeek-V3-0324 (46,9%), Qwen3-235B-A22B (37,0%), Claude Sonnet 4 (48,5%), GPT-4.1 (47,4%)
- SWE-Bench Verified: 65,8% — dẫn đầu nhóm open-weight, sát nhau với Claude Opus 4 (67,2%)
- MMLU-Pro: 84,1% — cạnh tranh với GPT-4.1 (84,3%) và Gemini 2.5 Flash (83,8%)
- GPQA-Diamond: 58,2% — reasoning khoa học mạnh
- AIME 2025: 48,7% — toán học cạnh tranh
Điểm mạnh nhất của Kimi K2 nằm ở coding tasks và agentic capabilities — khả năng tự chủ sử dụng tools, lập kế hoạch và thực thi nhiều bước.
Tối ưu cho Agentic Intelligence
Khác với các LLM thông thường chỉ tập trung vào chat completion, Kimi K2 được thiết kế từ đầu cho agentic intelligence:
- Tool use native: Hiểu và gọi functions/tools chính xác, hỗ trợ parallel function calling
- Reasoning có cấu trúc: Phân rã task phức tạp thành sub-tasks, tự kiểm tra và sửa lỗi
- Long-context handling: 128K context cho phép xử lý codebase lớn, tài liệu kỹ thuật dài
- Instruction following: Tuân thủ system prompts phức tạp, format output chính xác (JSON, XML, structured data)
Điều này làm Kimi K2 trở thành lựa chọn lý tưởng cho các framework agent như OpenClaw, Claude Code, hoặc custom agent pipelines.
Mã nguồn mở và truy cập
Kimi K2 được phát hành dưới giấy phép Apache 2.0 — cho phép sử dụng thương mại, sửa đổi và phân phối tự do. Các cách truy cập:
- GitHub: MoonshotAI/Kimi-K2 (11,1k stars, 910 forks)
- Hugging Face: Model weights và tokenizer có sẵn để download
- API: Moonshot AI cung cấp API endpoint cho Kimi K2 Instruct
- Local inference: Hỗ trợ vLLM, SGLang, llama.cpp (GGUF quantization)
Với 32B activated params, Kimi K2 Instruct có thể chạy trên single GPU H100/A100 80GB hoặc 2x RTX 4090/3090 (24GB VRAM each) với quantization 4-bit/8-bit.
Kết luận
Kimi K2 đại diện cho bước ngoặt của AI mã nguồn mở — không chỉ về quy mô mô hình mà còn về sự ổn định huấn luyện và tối ưu agentic. Sự kết hợp giữa MuonClip optimizer, kiến trúc MLA attention và post-training tập trung agentic tạo ra mô hình không chỉ mạnh về knowledge/reasoning mà còn sẵn sàng cho production agentic workflows.
Đối với developers Việt Nam quan tâm AI Agent, LLM và mã nguồn mở, Kimi K2 là mô hình đáng để thử nghiệm và tích hợp vào pipeline ngay hôm nay.
Nguồn: MoonshotAI/Kimi-K2 GitHub Repository, Hugging Face Model Card