vLLM: Phục Vụ LLM Hiệu Suất Cao Cho Production
Trong thế giới AI hiện đại, việc triển khai mô hình ngôn ngữ lớn (LLM) vào production đặt ra nhiều thách thức về hiệu suất, bộ nhớ và chi phí. vLLM là một framework mã nguồn mở giải quyết những vấn đề này bằng cách tối ưu hóa toàn bộ pipeline serving LLM. Bài viết này phân tích kiến trúc, các kỹ thuật chính và cách triển khai vLLM trong thực tế.
vLLM Là Gì?
vLLM (Vectorized LLM) là một inference server mã nguồn mở dành cho LLM, được phát triển ban đầu bởi nhóm nghiên cứu UC Berkeley. Nó cung cấp khả năng phục vụ model với thông lượng cao, độ trễ thấp và sử dụng bộ nhớ GPU hiệu quả. vLLM hỗ trợ hơn 4000 model từ Hugging Face Hub, bao gồm GPT-4, LLaMA 3, Mistral, Gemini, Claude và nhiều model khác. Đây là công cụ không thể thiếu cho bất kỳ team ML nào cần triển khai model ở quy mô lớn.
Kiến Trúc Core
Kiến trúc của vLLM được thiết kế xoay quanh ba thành phần chính:
- PagedAttention: Kỹ thuật quản lý attention memory ngăn xếp, cho phép chia sẻ KV cache giữa các request mà không cần pre-allocation toàn bộ bộ nhớ. Điều này giảm lãng phí bộ nhớ từ 60-80% so với phương pháp truyền thống.
- Continuous Batching: Tự động nhóm các request đang xử lý thành batch động, tối đa hóa GPU utilization và giảm idle time của compute units.
- Chunked Prefill: Chia prefill phase thành các chunk nhỏ, giúp latency không bị ảnh hưởng bởi prompt dài. Đặc biệt quan trọng cho chatbot và ứng dụng real-time.
PagedAttention — Kỹ Thuật Đột Phá
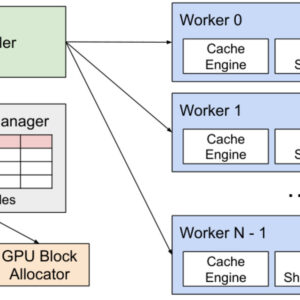
PagedAttention là trái tim của vLLM. Thay vì cấp phát trước một khối bộ nhớ liên tục cho KV cache (gây lãng phí và OutOfMemory khi model lớn), vLLM chia bộ nhớ thành các block có kích thước cố định, giống như cơ chế pagination trong hệ điều hành. Mỗi request được cấp phát block linh hoạt theo nhu cầu thực tế.
Khi prompt dài hoặc ngắn, bộ nhớ được sử dụng hiệu quả hơn đáng kể. Kết quả từ paper nghiên cứu: thông lượng tăng 2-4 lần so với transformers inference truyền thống, với cùng phần cứng. Điều này có nghĩa là gấp đôi số user đồng thời trên cùng một GPU.
PagedAttention cũng giải quyết vấn đề fragmentation — một trong những nguyên nhân chính gây OOM khi serving nhiều model trên cùng GPU. Bộ nhớ được quản lý như một bộ nhớ ảo, với block allocation và deallocation tự động.
Triển Khai vLLM Trong Production
Để deploy vLLM, bạn cần chuẩn bị:
- GPU có hỗ trợ FP16/BF16 (NVIDIA A100, H100, hoặc RTX 4090 cho dev)
- CUDA 11.8+ và PyTorch tương thích
- Model weights tải từ Hugging Face Hub
Chạy server đơn giản chỉ với một lệnh:
vllm serve meta-llama/Llama-3.1-70B-Instruct --max-model-len 8192 --tensor-parallel-size 2Tham số --tensor-parallel-size cho phép phân tán model qua nhiều GPU, trong khi --max-model-len kiểm soát context window tối đa. vLLM cũng hỗ trợ --dtype auto để tự động chọn precision tối ưu dựa trên model architecture.
Trong môi trường production, vLLM thường được deploy cùng với load balancer (nginx, HAProxy) và autoscaling group để xử lý lưu lượng biến đổi. Kết hợp với Kubernetes và KEDA, vLLM có thể scale từ 0 dựa trên request queue length.
So Sánh vLLM Với Các Server Khác
| Tiêu chí | vLLM | TGI (TextGen) | Transformers |
|---|---|---|---|
| Thông lượng (req/s) | Cao nhất | Trung bình | Thấp nhất |
| Latency (prefill) | Rất thấp | Trung bình | Cao |
| PagedAttention | Có | Không | Không |
| Continuous Batching | Tự động | Có | Không |
| Chunked Prefill | Có | Không | Không |
| Độ khó cài đặt | Dễ | Trung bình | Dễ |
| OpenAI compatible API | Có | Có | Cần wrapper |
Tích Hợp Với LLM Agent Framework
vLLM là backend lý tưởng cho các framework agent như LlamaIndex, LangChain và Hermes. Cấu trúc OpenAI-compatible API của vLLM cho phép swap model mà không cần thay đổi code client — chỉ cần đổi host/port trong config file.
Với PagedAttention, nhiều agent session chạy đồng thời trên cùng GPU mà không ảnh hưởng lẫn nhau. Điều này đặc biệt quan trọng khi triển khai multi-tenant AI services. Mỗi agent có context riêng nhưng chia sẻ GPU resources một cách hiệu quả.
Xu hướng và Tương Lai
vLLM không chỉ dừng lại ở hiện tại. Đội phát triển đang tích cực làm việc trên các tính năng mới như:
- Speculative decoding để tăng tốc độ generate token
- Quantization awareness để hỗ trợ tốt hơn các model 4-bit, 8-bit
- Better multi-modal support cho vision-language models
- Improved logging và monitoring để tích hợp với observability stack
Các nhà cung cấp cloud như AWS, Azure, GCP đang triển khai vLLM-managed services để giảm gánh nặng vận hành cho khách hàng. Điều này cho thấy vLLM đang trở thành tiêu chuẩn thực tế trong ngành LLM serving.
Kết Luận
vLLM đặt tiêu chuẩn mới cho LLM serving — thông lượng cao, latency thấp, bộ nhớ hiệu quả. Khi AI ngày càng được triển khai rộng rãi hơn trong enterprise, các công cụ như vLLM sẽ trở thành nền tảng không thể thiếu trong stack hạ tầng AI. Bắt đầu với một GPU đơn và scale lên tensor parallel khi tải tăng. Nhờ kiến trúc thông minh và cộng đồng phát triển năng động, vLLM sẽ tiếp tục dẫn đầu trong lĩnh vực inference optimization trong những năm tới.
Tham khảo thêm: vLLM Documentation, vLLM GitHub, PagedAttention Paper.