LoRA là viết tắt của Low-Rank Adaptation, một kỹ thuật cho phép tinh chỉnh mô hình ngôn ngữ lớn bằng cách chỉ huấn luyện một phần rất nhỏ tham số thay vì toàn bộ trọng số. Nhờ đó, bạn có thể tạo bản tùy biến riêng cho từng tác vụ chỉ với vài chục MB thay vì hàng trăm GB. Bài viết này giải thích cơ chế phân rã hạng thấp, cách chọn tham số, và những sai lầm thường gặp khi áp dụng.
LoRA giải quyết vấn đề gì
Bài toán gốc rất đơn giản: bạn có một mô hình ngôn ngữ đã huấn luyện sẵn và muốn nó giải quyết tốt một miền riêng, ví dụ văn bản pháp lý tiếng Việt hay dữ liệu hỗ trợ khách hàng nội bộ. Cách hiển nhiên nhất là tinh chỉnh toàn phần (full fine-tuning), tức mở khoá mọi trọng số và cho tất cả chúng cập nhật theo gradient. Cách này cho chất lượng tốt nhất nhưng đắt: mỗi lần chạy đều phải giữ trọng số gốc, gradient và trạng thái của bộ tối ưu hoá trong bộ nhớ. Với một mô hình khoảng 175 tỉ tham số, con số này lên tới trăm gigabyte.
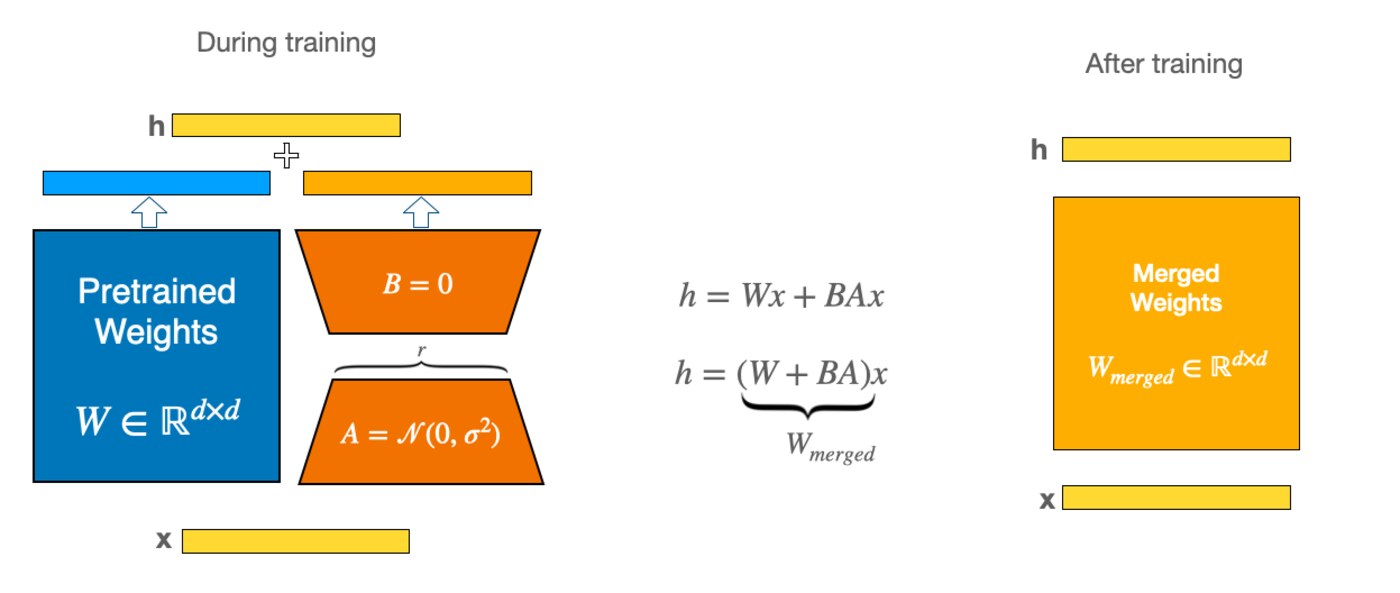
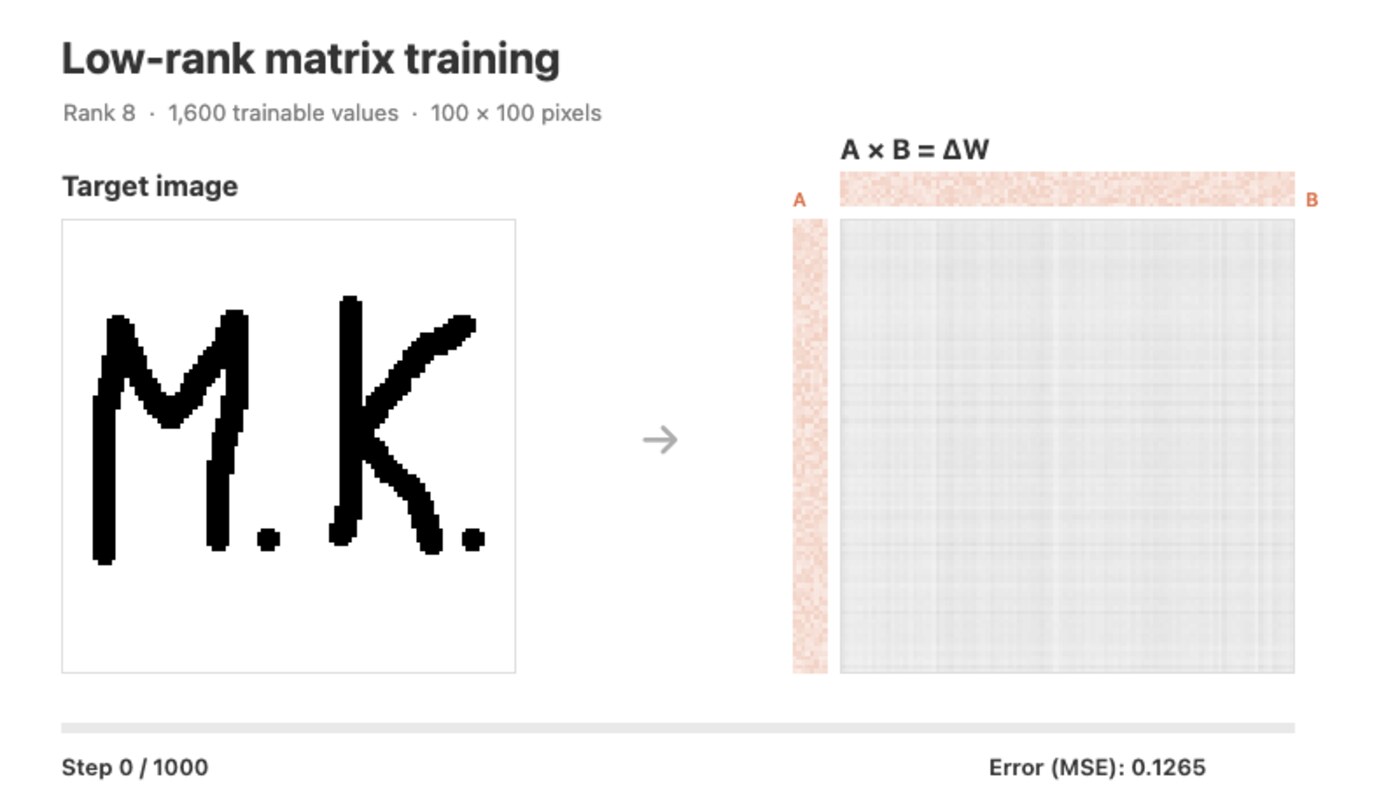
LoRA đặt một giả định: phần thay đổi cần thiết để thích nghi với tác vụ mới không có hạng đầy đủ, mà chỉ có hạng rất thấp. Với một ma trận trọng số W có kích thước d x k, LoRA thay vì học trực tiếp một ma trận cập nhật d x k, chỉ học hai ma trận B (d x r) và A (r x k), với r nhỏ hơn rất nhiều so với cả d và k. Bản cập nhật là tích của hai ma trận, có hạng không vượt quá r.
Cơ chế phân rã hạng thấp và hệ số alpha
Công thức cốt lõi rất gọn: trọng số hiệu tại bằng tổng của trọng số đóng băng W0 cộng với tích B nhân A. Phần W0 giữ nguyên trong suốt quá trình huấn luyện, chỉ A và B được cập nhật. Để quy trình bắt đầu từ trạng thái “chưa thay đổi gì”, A được khởi tạo bằng phân phối ngẫu nhiên còn B được khởi tạo bằng toàn số không, nhờ vậy tích B nhân A bằng không ngay từ đầu và mô hình hành xử y hệt bản gốc.
Do kết quả nhân với x rất nhỏ so với hàm chuyển đổi chính, LoRA nhân thêm một hệ số alpha chia cho r. Hệ số này giữ biên độ đầu ra ổn định khi bạn thay đổi bậc r mà không phải huấn luyện lại từ đầu. Trong cấu hình mặc định của thư viện PEFT, bậc r bằng 8 và alpha cũng bằng 8.
LoRA và QLoRA khác nhau ở điểm nào
QLoRA là biến thể bổ sung thêm lớp lượng tử hoá 4 bit cho trọng số đóng băng. Trọng số gốc nén xuống 4 bit, phần cập nhật LoRA vẫn giữ ở độ chính xác cao, nên phần tính toán và bộ nhớ ở độ chính xác đầy đủ chỉ dành cho phần nhỏ tham số đang học. QLoRA dùng định dạng NormalFloat 4 bit, được thiết kế để gần đúng phân phối trọng số hơn so với số nguyên thống nhất, kèm lượng tử hoá kép cho chính các hằng số lượng tử hoá để tiết kiệm thêm vài gigabyte.
| Tiêu chí | Full fine-tuning | LoRA | QLoRA |
|---|---|---|---|
| Tham số huấn luyện | Toàn bộ | Dưới 1% | Dưới 1% |
| Định dạng trọng số gốc | Đầy đủ | Đầy đủ | 4 bit |
| Bộ nhớ cho mô hình rất lớn | Rất cao | Cao | Thấp |
| Chất lượng sau tinh chỉnh | Tham chiếu | Gần tham chiếu | Gần tham chiếu |
| Độ phức tạp triển khai | Thấp | Trung bình | Trung bình |
Kết quả đáng chú ý từ bài báo gốc: khi chỉ tinh chỉnh hai ma trận chiếu của truy vấn và giá trị với bậc r bằng 4 trên mô hình 175 tỉ tham số, kích thước tệp trọng số của phần bổ sung chỉ khoảng 35 MB so với vài trăm GB nếu lưu toàn bộ. Tốc độ huấn luyện cũng tăng khoảng 25 phần trăm do phần lớn gradient không cần tính toán.
Chọn tham số LoRA như thế nào
Bậc r là tham số quan trọng nhất, thường bắt đầu ở 8 rồi thử 16 hoặc 32 khi tài nguyên cho phép. Nếu dữ liệu tinh chỉnh nhỏ, bậc thấp thường đã đủ vì bài báo gốc chỉ ra bậc 1 đến 2 đã đủ cho nhiều tác vụ. Danh sách module áp dụng mặc định là q_proj và v_proj, chỉ các ma trận phép chiếu trong lớp chú ý.
Lưu ý quan trọng về hiệu năng: LoRA không gây thêm độ trễ khi suy luận, vì bạn có thể gộp trọng số sau khi huấn luyện bằng cách cộng trực tiếp B nhân A vào W0, thu được một mô hình độc lập không kèm adapter. Việc đổi tác vụ chỉ cần thay lớp adapter tương ứng trước khi gộp.
Những lỗi thường gặp và cách tránh
- Quên gộp trọng số trước khi xuất. Adapter độc lập cần thư viện PEFT ở phía suy luận. Gộp sớm giúp triển khai đơn giản hơn nhiều.
- Dùng bậc r quá cao. Tăng bậc không tự động tăng chất lượng, chỉ tăng thời gian huấn luyện và kích thước adapter.
- Áp LoRA cho mọi lớp. Áp cho cả mạng phép chiếu và lớp feed-forward làm tăng tham số mà độ chính xác không cải thiện rõ rệt.
- Bộ nhớ tăng đột ngột khi dữ liệu biến động độ dài. Cần gom theo chiều dài tương đối đồng nhất hoặc dùng bộ tối ưu hoá phân trang như QLoRA để tránh đỉnh bộ nhớ.
- Quên chính sách bản quyền dữ liệu. Adapter là sản phẩm có giá trị thương mại; cần ghi rõ nguồn dữ liệu và điều khoản sử dụng.
Khi nào nên chọn LoRA thay vì tinh chỉnh toàn phần
LoRA hợp lý khi bạn cần nhiều biến thể tác vụ từ cùng một mô hình gốc, khi ngân sách GPU giới hạn, hoặc khi dữ liệu tinh chỉnh chỉ vài nghìn mẫu. Ngược lại, nếu bạn có lượng dữ liệu lớn, cần thay đổi kiến thức nền tảng chứ không chỉ phong cách, và có đủ tài nguyên, tinh chỉnh toàn phần vẫn cho kết quả tốt hơn.
Hướng dẫn tham khảo: bài báo LoRA trên arXiv, bài báo QLoRA trên arXiv, hướng dẫn khái niệm LoRA của Hugging Face PEFT, tham chiếu LoraConfig của PEFT và hướng dẫn lượng tử hoá của PEFT.