Mô hình Seq2seq là gì? Cách mạng dịch máy và tổng hợp văn bản
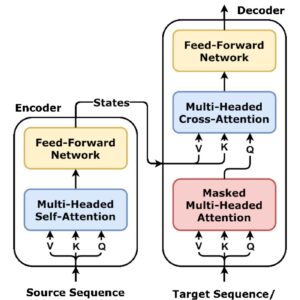
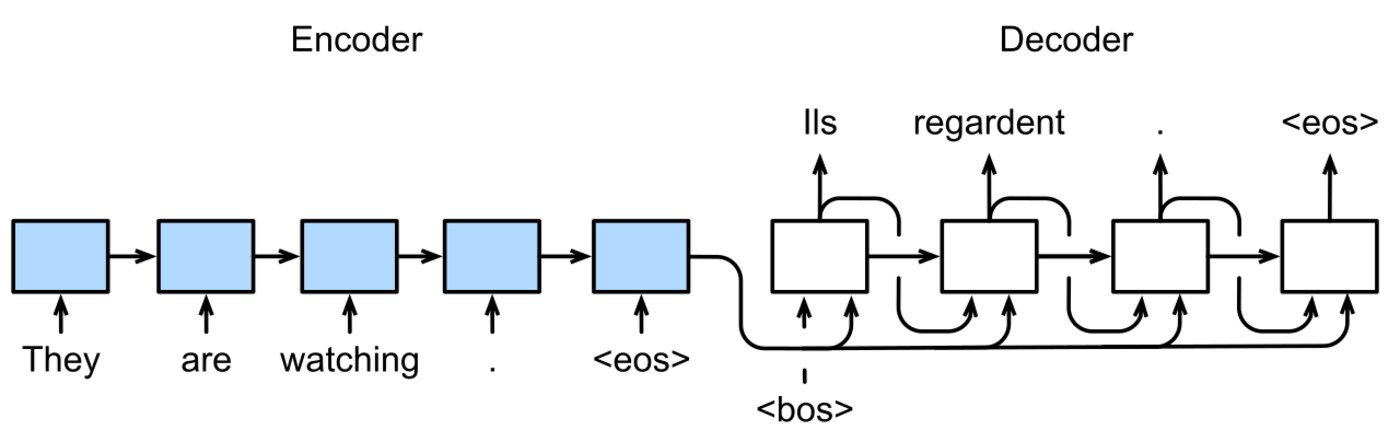
Seq2seq (Sequence-to-sequence) là kiến trúc học sâu dùng để chuyển đổi một chuỗi đầu vào thành một chuỗi đầu ra, thường dùng trong bản dịch máy, tóm tắt văn bản, chatbot và nhận dạng giọng nói. Mô hình bao gồm hai phần chính: Encoder (mã hóa) và Decoder (giải mã), kết nối qua vector context hoặc attention mechanism.
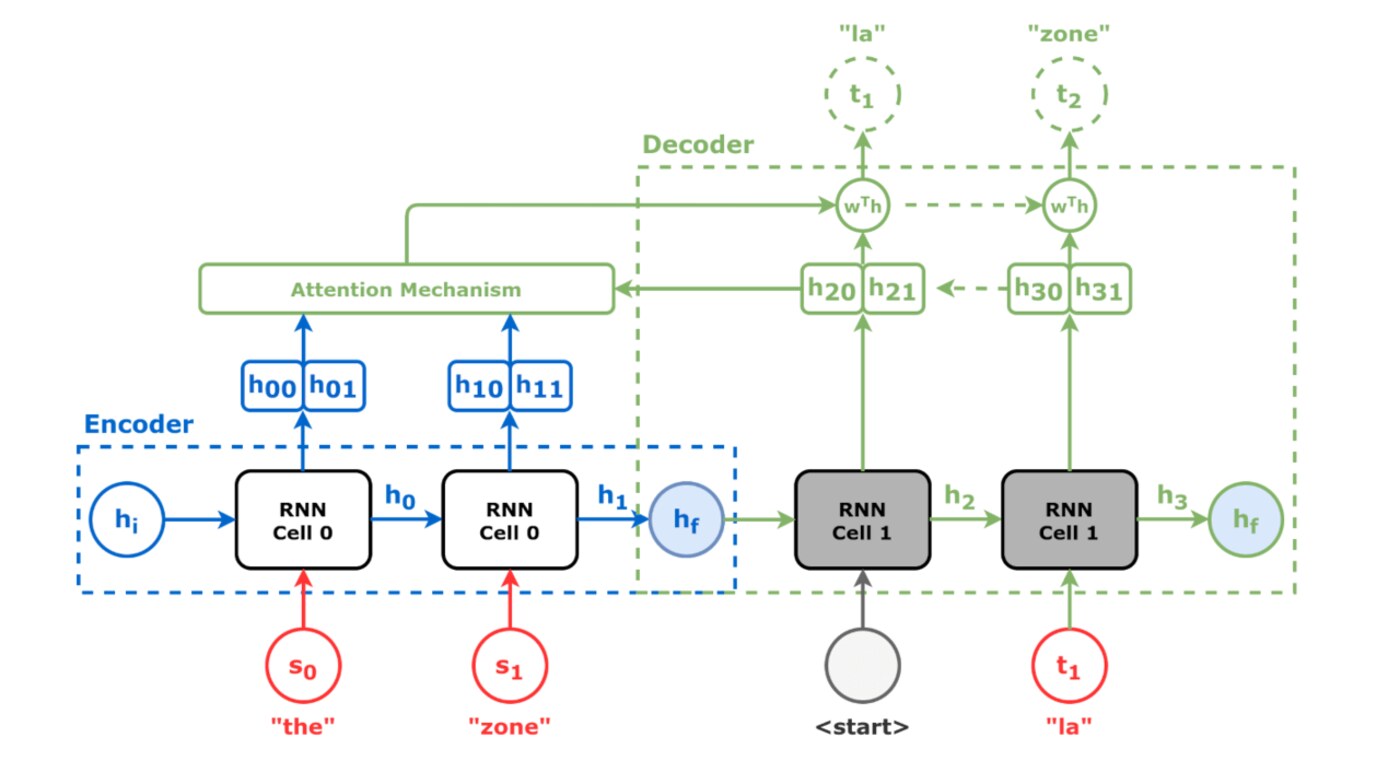
Trước khi xuất hiện attention, Seq2seq thuần túy thường gặp vấn đề “bottleneck” khi chuỗi đầu vào dài – toàn bộ thông tin phải được nén vào một vector cố định, dẫn đến việc degradation chất lượng cho câu dài. Sau này, attention cho phép decoder tập trung vào các phần khác nhau của encoder output tại mỗi bước giải mã.
Cấu trúc Encoder-Decoder cơ bản
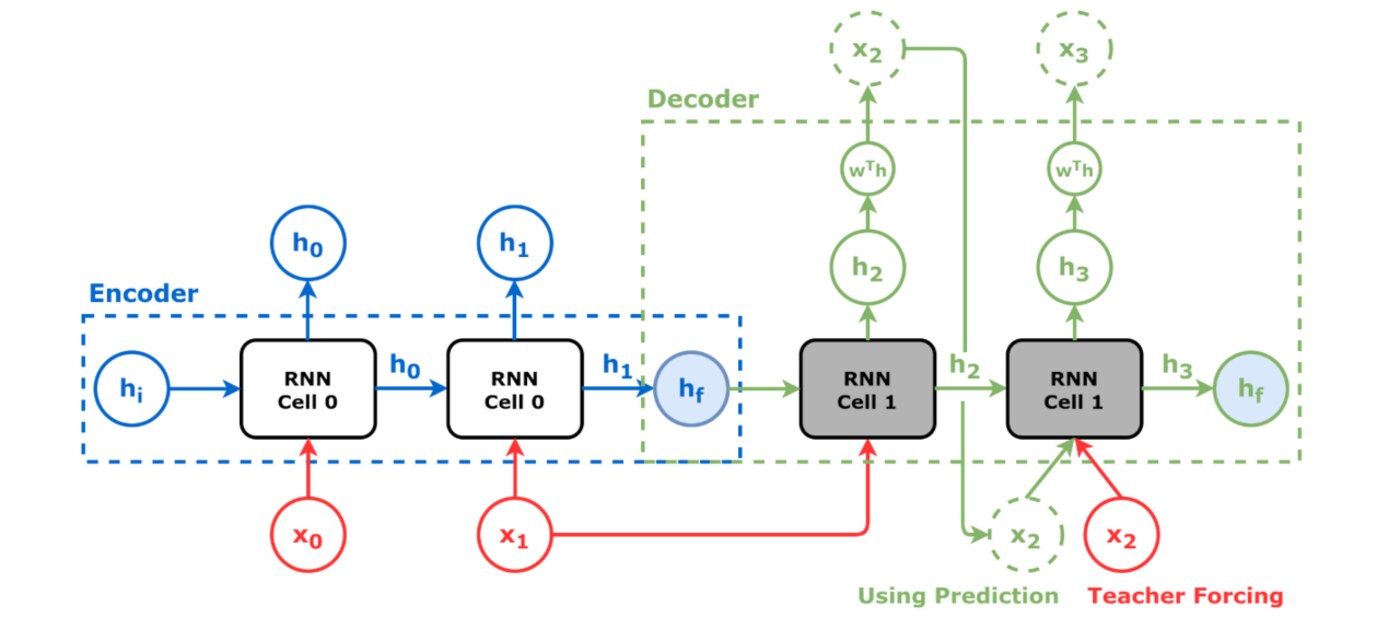
Encoder thường là RNN (LSTM/GRU) hoặc CNN đọc chuỗi đầu vào từ trái sang phải, mỗi bước cập nhật hidden state. Hidden state cuối cùng là vector context được truyền vào decoder.
Decoder cũng là RNN, bắt đầu bằng vector context và một token đặc biệt ( như ), mỗi bước dự đoán token tiếp theo dựa trên hidden state hiện tại và token trước đó, cho tới khi gặp token hoặc đạt độ dài giới hạn.
Giới hạn của Seq2seq thuần túy và cách vượt qua bằng Attention
Khi không có attention, encoder chỉ đưa ra một vector context duy nhất, forcing decoder để truy xuất toàn bộ thông tin từ vectơ đó – không hiệu quả cho chuỗi dài.
Attention đưa ra một tập trọng số (weights) cho mỗi bước giải mã, chỉ ra encoder output nào “đáng chú ý” nhất. Các trọng số này được học từ dữ liệu, cho phép decoder “quay lại” các vị trí khác nhau trong chuỗi nguồn.
Có ba loại attention thường thấy: encoder‑decoder attention (decoder nhìn vào encoder output), self‑attention (trong cùng một chuỗi) và global vs local attention.
Các biến thể Seq2seq phổ biến
- Seq2seq với Attention: cơ bản nhất, dùng rộng trong dịch máy trước Transformer.
- Seq2seq với Beam Search: thay vì greedy decoding, duy trì k‑best giả định để tối ưu xác suất chuỗi hoàn chỉnh.
- Seq2seq với Copy Mechanism: cho phép sao chép token trực tiếp từ chuỗi nguồn vào đầu ra, hữu ích khi xử lý tên riêng, số.
- Seq2seq với Coverage Penalty: tránh lặp lại attention trên cùng một vị trí trong các bước giải mã dài.
Ứng dụng thực tiễn của Seq2seq
- Dịch máy: WMT, IWSLT – mô hình Seq2seq với attention tạo nên bước đệm quan trọng trước Transformer.
- Tóm tắt văn bản: đầu vào là bài viết dài, đầu ra là tóm tắt ngắn – có thể dùng attention để lấy câu quan trọng.
- Chatbot và hội thoại: đầu vào là lịch sử trò chuyện, đầu ra là phản hồi tiếp theo.
- Speech-to-text: chuỗi đặc tính âm thanh thành chuỗi ký tự.
- Text-to-speech: ngược lại, chuỗi ký tự thành đặc tính âm thanh.
So sánh với kiến trúc Transformer
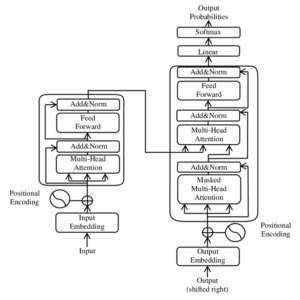
Transformer thay đổi hoàn toàn Seq2seq bằng cách thay RNN bằng các lớp self-attention, cho phép song song hoá hoàn toàn và xử lý chuỗi dài hiệu quả hơn. Tuy nhiên, Seq2seq với attention vẫn là nền tảng quan trọng để hiểu cơ chế attention trước khi vào các mô hình hiện đại như BERT, GPT, T5.
Nhiều bài báo mới vẫn dùng Seq2seq làm backbone cho các tác vụ có cấu trúc rõ ràng như sinh code, sản xuất lời lệnh cho robot, hoặc chuyển đổi giữa các định dạng dữ liệu cấu trúc (JSON, XML, YAML).
Quy trình huấn luyện và cách chọn hàm mất mát
Huấn luyện Seq2seq diễn ra theo kiểu supervised: cặp câu nguồn–đích được đưa vào mô hình, rồi so sánh chuỗi đầu ra với chuỗi đích thật. Hàm mất mát phổ biến là cross-entropy, cộng thêm một hạng phạt độ dài để mô hình không tạo câu quá dài hoặc quá ngắn.
Điểm quan trọng: quá trình giải mã lúc huấn luyện và lúc suy luận khác nhau. Khi huấn luyện, decoder ăn đúng token của chuỗi đích (teacher forcing). Khi suy luận, decoder ăn chính token nó vừa dự đoán, nên lỗi tích luỹ dần theo từng bước. Beam search ra đời để bù điểm này bằng cách giữ nhiều chuỗi đang theo thay vì chỉ giữ chuỗi tốt nhất tại mỗi bước.
Với RNN, việc tính gradient qua chuỗi dài bị suy giảm dần theo thời gian (vanishing gradient), khiến mô hình khó học quan hệ giữa các từ ở xa nhau. Cách khắc phục phổ biến là dùng LSTM hoặc GRU có cổng nhớ, hoặc cắt gradient (gradient clipping) khi giá trị trở nên quá lớn.
Những giới hạn cần biết trước khi chọn Seq2seq
Seq2seq vẫn có vài điểm yếu cố hữu khi so với kiến trúc hiện đại:
- Không thể huấn luyện song song trên toàn chuỗi như Transformer, nên thời gian huấn luyện tăng theo chiều dài câu.
- Chuỗi đầu ra dài dễ dẫn tới hiện tượng lặp, vì mô hình không có cơ chế nào đảm bảo mỗi thông tin chỉ được dùng một lần.
- Vector context cố định giữa encoder và decoder hạn chế khả năng nhớ chi tiết; attention giảm bớt nhưng không triệt tiêu hoàn toàn vấn đề.
Ngay cả vậy, trong các bài toán cần dự đoán có cấu trúc chặt chẽ như chuyển định dạng dữ liệu, Seq2seq vẫn hấp dẫn vì hành vi của nó dễ kiểm soát hơn: mỗi token đầu ra gắn với một vị trí cụ thể, rất thuận tiện khi cần kiểm tra kết quả hoặc sửa lỗi thủ công.
Kết luận
Seq2seq là một trong những bước mốc quan trọng trong sự phát triển của học sâu cho xử lý chuỗi. Mặc dù đã bị Transformer thay thế phần lớn, kiến trúc encoder-decoder kết hợp attention vẫn lý tưởng cho nhiều bài toán thực tế khi cần giải thích được, có kiểm soát rõ ràng trên quá trình sinh ra chuỗi đầu ra.
Nguồn tham khảo: Wikipedia – Seq2seq, Sutskever et al. 2014 – Sequence to Sequence Learning with Neural Networks.